K-means: Algoritmo de agrupación no supervisado
1 ¿Qué es un algoritmo de agrupación no supervisado?
Un algoritmo de agrupamiento (o clustering) analiza un conjunto de puntos de datos sin etiquetar y encuentra automáticamente relaciones o similitudes entre ellos.
A diferencia del aprendizaje supervisado, en el aprendizaje no supervisado no disponemos de etiquetas objetivo (targets); por tanto, no podemos decirle al algoritmo cuál es la «respuesta correcta» que debe predecir. En su lugar, le pedimos que descubra estructuras interesantes de forma autónoma en los datos.
El agrupamiento busca un tipo concreto de estructura: dividir el conjunto de datos en clústeres, es decir, grupos de puntos que comparten características similares entre sí.
Este algoritmo se aplica:
- Agrupación de noticias: Clasificar artículos de prensa similares por temáticas.
- Análisis de ADN: Agrupar datos de expresión genética de diferentes individuos que muestran rasgos biológicos similares.
- Astronomía: Agrupar cuerpos celestes mediante el análisis de datos espaciales para estudiar su comportamiento y origen.
2 Intuición de K-means
Para entender cómo funciona el algoritmo K-means, veámoslo con un ejemplo práctico.
Imaginemos que tenemos un conjunto de datos con 30 ejemplos de entrenamiento sin etiquetar y queremos dividirlos en dos clústeres (\(K = 2\)).
El algoritmo K-means realiza dos operaciones de forma repetida hasta que el sistema se estabiliza:
- Asignación de puntos: Cada punto de datos se asocia al centroide más cercano.
- Actualización de centroides: Cada centroide se desplaza a la posición promedio de los puntos que tiene asignados.
Paso a paso del proceso:
- Inicialización aleatoria: El algoritmo selecciona al azar dos puntos en el espacio para que actúen como centros iniciales de los clústeres. A estos centros se les denomina centroides (representados, por ejemplo, con una cruz roja y una cruz azul).
- Primera asignación: Se analiza cada uno de los 30 puntos de datos para comprobar si se encuentra más cerca del centroide rojo o del azul, asociando cada punto al más próximo (lo cual podemos visualizar pintando cada punto del color correspondiente).
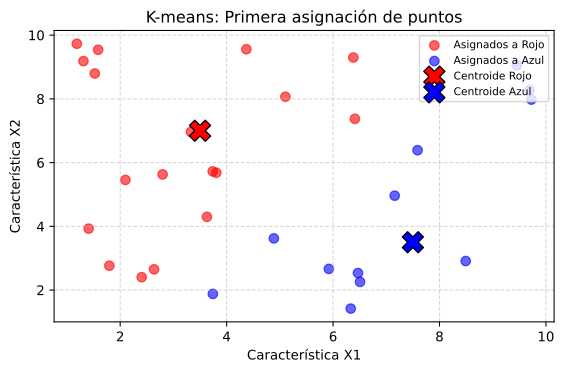
Figura 1: Primera asignación: los puntos se pintan según el centroide más cercano.
- Recálculo de centroides: Se calculan las coordenadas promedio (la media) de todos los puntos agrupados bajo el color rojo, y se mueve la cruz roja a esa nueva ubicación. Se hace exactamente lo mismo con los puntos azules para actualizar la posición del centroide azul.
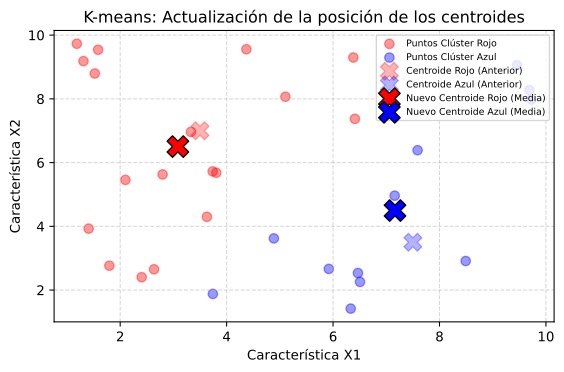
Figura 2: Actualización de centroides: se mueven a la posición promedio (media) de los puntos asignados.
- Iteración: Con las nuevas ubicaciones de los centroides, se vuelve a comprobar la distancia de los 30 puntos. Algunos puntos cambiarán de clúster (y por tanto de color) porque los centroides se han movido.
- Convergencia: Si repetimos este ciclo de forma sucesiva, llegará un momento en el que ningún punto cambie de clúster y las posiciones de los centroides dejen de moverse. En este punto decimos que el algoritmo K-means ha convergido.
3 Algoritmo K-means (Matemáticas y Funcionamiento Formal)
El algoritmo formal consta de los siguientes pasos:
3.1 Inicialización
Se elige el número de clústeres \(K\) y se inicializan aleatoriamente los centroides \(\mu_1, \mu_2, \dots, \mu_K\).
- En la práctica, lo habitual es seleccionar aleatoriamente \(K\) ejemplos de entrenamiento del propio conjunto de datos y fijar los centroides iniciales en esas posiciones.
- Los centroides \(\mu_k\) son vectores que tienen la misma dimensionalidad que nuestros ejemplos de entrenamiento (si cada ejemplo tiene \(n\) características, cada \(\mu_k\) será un vector de \(n\) dimensiones).
3.2 Paso 1: Asignación de puntos a los clústeres
Para cada ejemplo de entrenamiento \(x^{(i)}\) (desde \(i = 1\) hasta \(m\)), determinamos a qué clúster pertenece asignándole un índice \(c^{(i)}\) correspondiente al centroide \(\mu_k\) más cercano:
Matemáticamente, buscamos el valor de \(k\) que minimice la distancia entre \(x^{(i)}\) y \(\mu_k\) (utilizando la norma L2 o distancia euclidiana). Para simplificar el cálculo computacional, se suele minimizar la distancia al cuadrado:
3.3 Paso 2: Actualización de los centroides
Una vez que todos los puntos han sido asignados a su clúster correspondiente, recalculamos la posición de cada centroide \(\mu_k\) calculando la media (promedio) de todos los puntos que pertenecen a ese clúster.
- Caso extremo (Clúster vacío): Si durante la ejecución un clúster se queda sin ningún punto de entrenamiento asignado, no debemos reducir silenciosamente el número solicitado de clústeres. Una estrategia habitual consiste en reinicializar su centroide, por ejemplo colocándolo en un punto alejado o en el punto con mayor error de asignación, y continuar con \(K\) centroides.
4 4. Objetivo de optimización y función de coste
A diferencia de los algoritmos supervisados que utilizan el descenso del gradiente sobre una función de pérdida, K-means optimiza una función de coste específica conocida como función de distorsión (\(J\)):
Esta función mide la distancia cuadrática media entre cada ejemplo de entrenamiento \(x^{(i)}\) y el centroide del clúster al que ha sido asignado (\(\mu_{c^{(i)}}\)).
- Asignar cada punto al centroide más cercano es exactamente la operación matemática que minimiza la distancia respecto a \(\mu_{c^{(i)}}\).
- Situar el centroide \(\mu_k\) en la media aritmética de los puntos asignados es el valor exacto que minimiza la suma de las distancias al cuadrado.
Cada iteración del algoritmo de Lloyd reduce o mantiene el valor de la función de coste \(J\) (distorsión). Como el conjunto de datos es finito y solo existe un número finito de asignaciones posibles, el algoritmo termina alcanzando un punto fijo bajo las condiciones habituales. Esta convergencia es hacia un óptimo local, no necesariamente hacia el óptimo global. Si en alguna iteración la función de coste aumentara, indicaría la presencia de un error en la implementación.
5 Inicialización y mínimos locales
Una limitación de K-means es que es sensible a la inicialización aleatoria. Dependiendo de dónde se sitúen los centroides al principio, el algoritmo puede quedar atrapado en un óptimo local y ofrecer una agrupación de baja calidad.
Para mitigar este problema, una técnica estándar consiste en ejecutar K-means múltiples veces (por ejemplo, entre 50 y 1000 veces) utilizando diferentes semillas de inicialización aleatoria. Esto reduce la probabilidad de quedarse con una mala solución, pero no elimina la posibilidad de obtener distintos óptimos locales ni garantiza encontrar el óptimo global:
- Ejecutar el algoritmo completo hasta la convergencia.
- Calcular el valor final de la función de coste \(J\) (distorsión) para esa ejecución.
- Repetir el proceso \(N\) veces.
- Seleccionar el modelo final que haya producido el valor más bajo de la función de coste \(J\).
La solución elegida suele ser mejor que una ejecución individual según la función de coste, aunque su calidad sigue dependiendo de las inicializaciones y del número de ejecuciones. En implementaciones prácticas, k-means++ proporciona una inicialización más informada que una selección completamente aleatoria.
6 Aplicación de K-means con Scikit-Learn
A continuación se muestra un ejemplo práctico de cómo implementar K-means en Python utilizando la librería scikit-learn con el clásico conjunto de datos Iris:
from sklearn.cluster import KMeans
from sklearn.datasets import load_iris

# Cargamos el conjunto de datos Iris
iris = load_iris()
X = iris.data  # Características
y = iris.target  # Etiquetas verdaderas (solo como referencia)

# Creamos el modelo K-means para 3 clústeres.
# Fijamos n_init para que el resultado no dependa del valor por defecto
# de la versión instalada de scikit-learn.
kmeans = KMeans(n_clusters=3, n_init=10, random_state=42)

# Entrenamos el modelo
kmeans.fit(X)

# Obtenemos las etiquetas de los clústeres asignadas por K-means
labels = kmeans.labels_

# Imprimimos las etiquetas para las primeras 10 muestras
print("Etiquetas de los clústeres para las primeras 10 muestras:")
print(labels[:10])

# Imprimimos las coordenadas de los centroides de los clústeres
print("\nCoordenadas de los centroides de los clústeres:")
print(kmeans.cluster_centers_)

# Probamos con un nuevo ejemplo de flor Iris
new_example = [[5.1, 3.5, 1.4, 0.2]]
predicted_cluster = kmeans.predict(new_example)
print("\nEl nuevo ejemplo pertenece al clúster:", predicted_cluster)
Salida esperada:
Etiquetas de los clústeres para las primeras 10 muestras:
[1 1 1 1 1 1 1 1 1 1]

Coordenadas de los centroides de los clústeres:
[[5.9016129  2.7483871  4.39354839 1.43387097]
 [5.006      3.428      1.462      0.246     ]
 [6.85       3.07368421 5.74210526 2.07105263]]

El nuevo ejemplo pertenece al clúster: [1]
7 La ambigüedad del número de clústeres
El algoritmo K-means requiere como parámetro de entrada el valor de \(K\), es decir, el número de clústeres que deseamos encontrar. Pero ¿cómo decidimos cuántos clústeres utilizar?
Para muchos problemas de agrupamiento, el valor correcto de \(K\) es verdaderamente ambiguo. Si mostramos un mismo conjunto de datos a diferentes personas, es muy probable que algunas perciban dos grupos distintos, mientras que otras distingan cuatro. Ambas percepciones pueden ser correctas.
7.1 El método del codo
En la literatura académica de K-means se sugieren varias técnicas para intentar automatizar la elección de \(K\). Una de las más conocidas es el método del codo (Elbow Method).
El procedimiento consiste en lo siguiente:
- Ejecutar K-means de forma iterativa probando con una variedad de valores crecientes de \(K\).
- Registrar el valor de la función de coste o distorsión \(J\) (en scikit-learn denominada inercia) para cada modelo.
- Graficar la función de coste en función del número de clústeres \(K\).
Al graficarlo, observaremos que cuando usamos muy pocos clústeres (por ejemplo, \(K=1\)), la inercia es muy alta. A medida que aumentamos \(K\), la función de coste disminuye rápidamente. Sin embargo, a partir de cierto punto, la curva se aplana formando una especie de «codo». Ese punto de inflexión se propone a menudo como el número óptimo de clústeres.
7.2 Cómo elegir \(K\) en la práctica: Enfoque de negocio
Dado que el número de clústeres suele ser ambiguo, la mejor forma de decidirlo en entornos reales es evaluar K-means en función de su utilidad para un propósito futuro o de negocio.
Imaginemos que fabricamos camisetas y queremos usar K-means en función de la altura y el peso de nuestros clientes para decidir las tallas:
- Con 3 clústeres (\(K=3\)): Obtendremos tres grupos representativos para fabricar tallas Pequeña, Mediana y Grande.
- Con 5 clústeres (\(K=5\)): Obtendremos cinco agrupaciones que permitirán tallas más específicas (Extra pequeña, Pequeña, Mediana, Grande y Extra grande).
Ambos agrupamientos son matemáticamente válidos. La decisión de elegir entre 3 o 5 clústeres ya no depende exclusivamente de las matemáticas, sino de un análisis de coste-beneficio empresarial:
- Tener más tallas (5 clústeres) ofrece un mejor ajuste para los clientes, pero encarece los costes de fabricación, almacenamiento y distribución.
- Tener menos tallas (3 clústeres) simplifica la operación y reduce costes, pero el ajuste para algunos clientes será menos preciso.
La clave consiste en evaluar las soluciones resultantes y sopesar los beneficios operativos frente a los costes asociados.
7.2.1 Ejemplo práctico: Aplicación del Método del Codo con Quarto
A continuación, implementamos el método del codo utilizando el conjunto de datos Iris, probando valores de \(K\) desde 1 hasta 10, y generando la gráfica de inercia:
from sklearn.cluster import KMeans
from sklearn.datasets import load_iris
import matplotlib.pyplot as plt

# Cargamos el conjunto de datos Iris
iris = load_iris()
X = iris.data

# Creamos una lista para almacenar las inercias
inertias = []

# Probamos diferentes valores de clusters (K de 1 a 10)
rango_k = range(1, 11)
for k in rango_k:
    kmeans = KMeans(n_clusters=k, n_init=10, random_state=42)
    kmeans.fit(X)
    inertias.append(kmeans.inertia_)

# Graficamos la curva de la inercia (método del codo)
plt.figure(figsize=(6, 4))
plt.plot(rango_k, inertias, marker='o', linestyle='-', color='teal')
plt.xlabel('Número de clusters (K)')
plt.ylabel('Inercia (Función de coste J)')
plt.title('Método del Codo para selección de K')
plt.grid(True, linestyle='--', alpha=0.5)
plt.tight_layout()
plt.show()
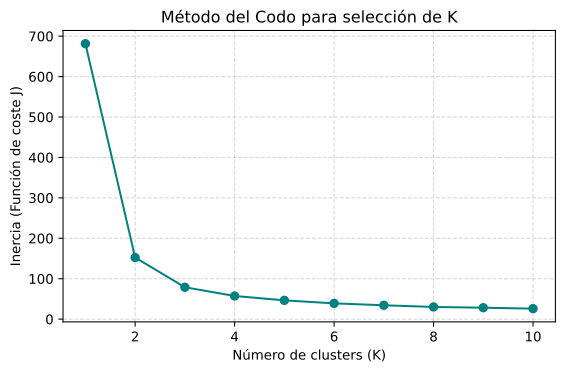
Figura 3: Curva del método del codo utilizando la inercia del modelo K-means.