Evaluación de modelos, sobreajuste y regularización
1 Introducción
Entrenar un modelo no basta: hay que comprobar que generaliza, es decir, que funciona con datos que no ha visto. Este capítulo reúne tres ideas transversales a todos los algoritmos del libro: cómo dividir y evaluar los datos, qué son el sobreajuste y el subajuste (y su relación con el sesgo y la varianza), y cómo la regularización los corrige.
Cuando empecé a experimentar con redes neuronales, intenté predecir los resultados de partidos de tenis utilizando brain.js y los datos públicos de los jugadores. El modelo parecía espectacular: obtenía un error casi nulo durante el entrenamiento. Sin embargo, cuando lo llevé a la práctica para predecir partidos reales, fallaba aproximadamente el 50 % de las veces, es decir, lo mismo que el azar.
Al no evaluar su rendimiento sobre datos nuevos, el modelo simplemente memorizó los ejemplos del entrenamiento y no desarrolló la capacidad de generalizar, que es precisamente lo que distingue a un modelo útil de uno engañosamente perfecto.
2 Conjuntos de entrenamiento, validación y prueba
En la práctica rara vez podemos dibujar los datos en 2D o 3D para inspeccionarlos a simple vista, sobre todo con muchas variables. Para saber si un modelo se sobreajusta, dividimos el conjunto original en subconjuntos:
- Entrenamiento (train): se usa para ajustar los parámetros del modelo.
- Validación (validation): se usa para comparar modelos y elegir hiperparámetros (por ejemplo, la profundidad de un árbol o el valor de \(k\) en KNN).
- Prueba (test): se usa una sola vez al final, para estimar la capacidad de generalización real.
Una división típica es 80 % entrenamiento, 10 % validación y 10 % prueba, aunque depende del tamaño del dataset. Lo importante es que el conjunto de prueba nunca participe ni del entrenamiento ni de la selección de hiperparámetros.
3 La importancia del conjunto de datos
Elegir un buen conjunto de datos es tan relevante como elegir el algoritmo adecuado. Un dataset debe ser representativo del problema y estar limpio (sin etiquetas erróneas ni valores corruptos), porque datos de mala calidad producen modelos sesgados o inexactos.
Además, la cantidad de datos importa. Como muestra la Figura 1, cuando el conjunto de entrenamiento es pequeño las diferencias entre algoritmos son grandes; a medida que aportamos más datos, las técnicas de machine learning convergen hacia un rendimiento similar. Por eso se dice que, a menudo, más datos valen más que un algoritmo más sofisticado.
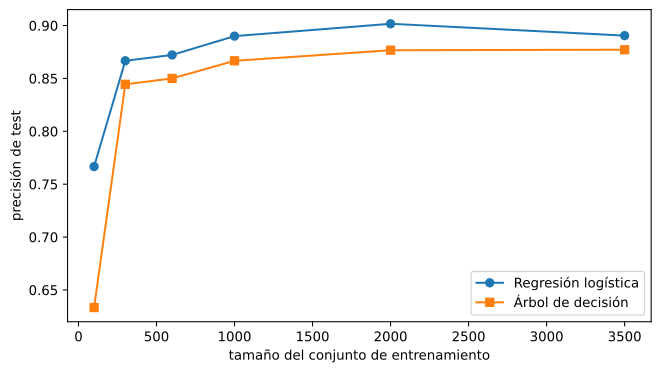
Figura 1: Precisión de test al aumentar el tamaño del conjunto de entrenamiento. Más datos suelen mejorar (y acercar) el rendimiento de distintos algoritmos.
De hecho, una de las razones por las que las redes neuronales se han vuelto tan potentes es el acceso masivo a datos. Estos modelos necesitan un volumen considerable de ejemplos para aprender patrones útiles y generalizar correctamente. Cuando el conjunto de datos es pequeño, los algoritmos clásicos suelen funcionar mejor porque tienen un inductive bias más adecuado y no requieren tanta información para estabilizar su aprendizaje.
Pero cuando el conjunto de datos crece y otros algoritmos ya han alcanzado su límite, las redes neuronales siguen mejorando: su capacidad para extraer representaciones complejas escala con la cantidad de datos.
4 Sobreajuste y subajuste
El sobreajuste (overfitting) ocurre cuando la hipótesis se adapta demasiado bien al conjunto de entrenamiento, llevando el error casi a cero, pero falla con ejemplos nuevos. El subajuste (underfitting) es lo contrario: el modelo es tan rígido que ni siquiera captura la tendencia de los datos de entrenamiento.
Un ejemplo clásico es predecir el precio de la vivienda en función de su tamaño. Una recta (regresión lineal) puede quedarse corta (subajuste), mientras que un polinomio de grado muy alto pasa por todos los puntos de entrenamiento pero traza curvas absurdas entre ellos (sobreajuste). Un modelo óptimo se ajusta a la tendencia sin perseguir el ruido.
El diagnóstico es directo comparando errores:
- Error de entrenamiento muy bajo (a veces casi cero).
- Error de prueba mucho más alto.
Si ambos errores son altos, el modelo sufre de subajuste. Encontrar el punto medio es el objetivo de todo el proceso de aprendizaje, que suele ser iterativo: se plantea una idea, se configura el algoritmo, se entrena y se evalúa.
La Figura 2 ilustra las tres situaciones sobre un mismo conjunto ruidoso.
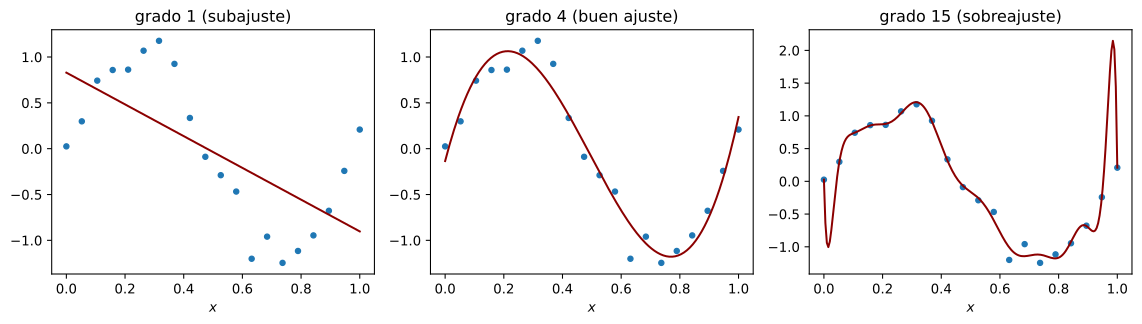
Figura 2: Ajuste polinómico de un mismo conjunto ruidoso: grado 1 (subajuste), grado 4 (buen ajuste) y grado 15 (sobreajuste).
5 Sesgo y varianza
Estas dos palabras dan nombre al fenómeno:
- Sesgo (bias): error debido a suposiciones demasiado simplistas del modelo. Un modelo con mucho sesgo subajusta.
- Varianza (variance): sensibilidad del modelo a los cambios en el conjunto de entrenamiento. Un modelo con mucha varianza sobreajusta.
La Figura 3 muestra la curva clásica: al aumentar la complejidad del modelo (por ejemplo, el grado del polinomio), el error de entrenamiento cae sin parar, pero el error de prueba primero baja y luego sube formando una U. El mínimo de esa U es el punto de equilibrio entre sesgo y varianza.
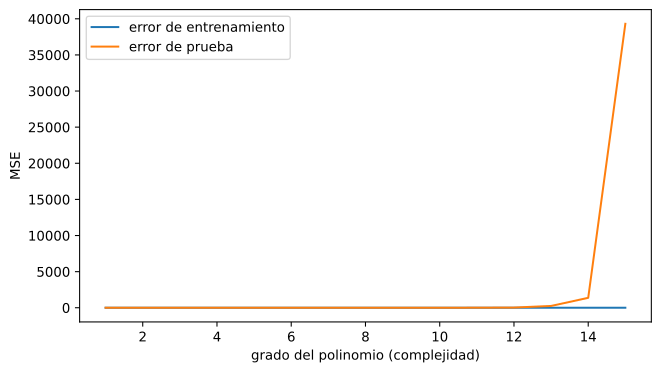
Figura 3: Error de entrenamiento (baja siempre) y de prueba (forma de U) en función de la complejidad del modelo.
6 Diagnosticar sesgo y varianza con los errores
Además de mirar las curvas, una forma muy práctica de saber si el problema es de sesgo o de varianza es comparar el error en el conjunto de entrenamiento y en un conjunto de desarrollo/validación (dev). Supongamos que el error óptimo (irreducible) es 0 %:
| Caso | Error entrenamiento | Error dev | Diagnóstico |
|---|---|---|---|
| 1 | 1 % | 11 % | Alta varianza (sobreajuste) |
| 2 | 15 % | 16 % | Alto sesgo (subajuste) |
| 3 | 15 % | 30 % | Alto sesgo y alta varianza (el peor caso) |
| 4 | 0.5 % | 1 % | Bajo sesgo y baja varianza (modelo ideal) |
La regla general es: un error alto en entrenamiento indica alto sesgo; cuanto mayor sea el error de dev respecto al de entrenamiento, mayor es el problema de varianza. (Si el error óptimo fuera, por ejemplo, 15 %, el caso 2 sería en realidad un buen modelo de bajo sesgo y baja varianza.)
7 Qué hacer en cada caso
Una vez diagnosticado, el remedio apunta en direcciones opuestas:
- Alto sesgo (subajuste): el modelo es demasiado simple. Hay que aumentar su capacidad: usar un modelo más flexible (más grados en un polinomio, árboles más profundos, una red más grande), entrenar más épocas o probar otra arquitectura. También ayuda reducir la regularización si la estamos aplicando de sobra.
- Alta varianza (sobreajuste): el modelo memoriza. Los remedios principales son aumentar los datos de entrenamiento, seleccionar menos características, aplicar regularización (L2, como veremos a continuación), y, en redes neuronales, data augmentation o early stopping.
Es decir: para el sobreajuste conviene más datos; para el subajuste conviene un modelo más grande. Esa es la intuición correcta, siempre buscando el punto mínimo de la U de la Figura 3.
8 Validación cruzada (K-fold Cross Validation)
Ya sabemos que necesitamos dividir los datos en entrenamiento, validación y prueba. Pero usar un solo conjunto de validación puede introducir sesgo: si el conjunto de validación es poco representativo, la evaluación será engañosa.
La validación cruzada K-fold resuelve esto rotando los conjuntos de entrenamiento y validación.
8.1 El algoritmo
- Dividir los datos de entrenamiento en \(K\) pliegues (folds) iguales.
- Para cada pliegue \(k = 1, \ldots, K\):
- Usar el pliegue \(k\) como validación.
- Usar los otros \(K-1\) pliegues como entrenamiento.
- Entrenar el modelo y evaluar en el pliegue de validación.
- Promediar las \(K\) puntuaciones de validación.
La Figura 4 muestra el proceso con \(K=5\) pliegues:
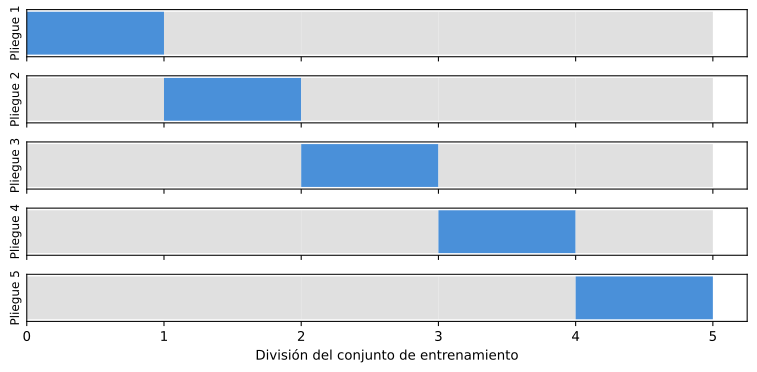
Figura 4: Validación cruzada 5-fold: cada pliegue se usa una vez como validación, mientras los otros 4 son entrenamiento.
8.2 ¿Por qué funciona?
Con un solo conjunto de validación, el modelo “ve” esos datos indirectamente (a través de la selección de hiperparámetros). Con K-fold, cada dato de entrenamiento se usa como validación exactamente una vez, evitando que la información se filtre al modelo.
8.3 K-fold estratificado
Para problemas de clasificación con clases desbalanceadas, se usa Stratified K-fold, que asegura que cada pliegue tenga la misma proporción de clases que el conjunto completo.
from sklearn.model_selection import cross_val_score
from sklearn.ensemble import RandomForestClassifier

# Validación cruzada 5-fold con estratificación
scores = cross_val_score(
    RandomForestClassifier(n_estimators=100),
    X_train, y_train,
    cv=5,  # 5-fold
    scoring='accuracy'
)
print(f"Precisión media: {scores.mean():.4f} ± {scores.std():.4f}")
9 Métricas de evaluación
La precisión (accuracy) no siempre cuenta toda la historia. Para problemas con clases desbalanceadas o donde ciertos errores son más costosos que otros, necesitamos métricas más detalladas.
9.1 Matriz de confusión
La matriz de confusión muestra las predicciones del modelo vs. las etiquetas reales:
| Predicho: Positivo | Predicho: Negativo | |
|---|---|---|
| Real: Positivo | VP (Verdadero Positivo) | FN (Falso Negativo) |
| Real: Negativo | FP (Falso Positivo) | VN (Verdadero Negativo) |
from sklearn.metrics import confusion_matrix, ConfusionMatrixDisplay

cm = confusion_matrix(y_val, y_pred)
print("Matriz de confusión:")
print(cm)

# Visualización
ConfusionMatrixDisplay.from_estimator(clf, X_val, y_val, values_format='d')
9.2 Accuracy (Exactitud)
Proporción de predicciones correctas. Funciona bien cuando las clases están balanceadas.
9.3 Precision (Precisión)
De todos los que el modelo predijo como positivos, ¿cuántos son realmente positivos? Importante cuando los falsos positivos son costosos (p. ej., spam: no quieres clasificar un email importante como spam).
from sklearn.metrics import precision_score
print(f"Precision: {precision_score(y_true, y_pred):.4f}")
9.4 Recall (Exhaustividad / Sensibilidad)
De todos los positivos reales, ¿cuántos detectó el modelo? Importante cuando los falsos negativos son costosos (p. ej., cáncer: no quieres perder un caso positivo).
9.5 F1-Score
Promedio armónico de Precision y Recall. Útil cuando necesitas un equilibrio entre ambas métricas.
9.6 Curva ROC y AUC
La curva ROC grafica la tasa de verdaderos positivos (recall) vs. la tasa de falsos positivos (\(FP / (FP + VN)\)) en diferentes umbrales de clasificación.
- AUC = 1.0: Clasificador perfecto.
- AUC = 0.5: Sin poder discriminativo (azar).
- AUC \< 0.5: Peor que el azar.
9.7 Curva PR (Precisión-Recall)
La curva PR grafica Precision vs. Recall en diferentes umbrales. Es más informativa que ROC cuando las clases están desbalanceadas.
- AUC-PR = 1.0: Perfecto.
- AUC-PR baja: Mal rendimiento en la clase minoritaria.
from sklearn.metrics import PrecisionRecallDisplay

PrecisionRecallDisplay.from_estimator(clf, X_val, y_val)
9.8 Error cuadrático medio (MSE)
Para problemas de regresión:
from sklearn.metrics import mean_squared_error
print(f"MSE: {mean_squared_error(y_true, y_pred):.4f}")
9.9 Error absoluto medio (MAE) y raíz del MSE (RMSE)
El MSE penaliza cuadráticamente: un error de 10 pesa 100 veces más que uno de 1. Dos alternativas lo complementan:
- MAE: error promedio en las unidades originales (euros, metros). Al no elevar al cuadrado, es robusto frente a atípicos: un solo error gigante no domina la métrica.
- RMSE: también en unidades originales, pero conserva la penalización fuerte a errores grandes del MSE. Útil cuando esos errores son los que más duelen (p. ej., una rotura de stock).
from sklearn.metrics import mean_absolute_error, root_mean_squared_error
print(f"MAE:  {mean_absolute_error(y_true, y_pred):.4f}")
print(f"RMSE: {root_mean_squared_error(y_true, y_pred):.4f}")
Regla práctica: si MAE y RMSE difieren mucho, hay atípicos con errores grandes tirando del RMSE.
9.10 Coeficiente de determinación (\(R^2\))
MSE, MAE y RMSE dependen de la escala (un RMSE de 100 € es bueno o malo según el precio medio). El \(R^2\) mide qué proporción de la varianza del objetivo explica el modelo, en una escala comparable entre problemas:
- \(R^2 = 1\): predicción perfecta.
- \(R^2 = 0\): el modelo equivale a predecir siempre la media \(\bar{y}\).
- \(R^2 < 0\): peor que la media (el modelo no sirve).
Nota
En regresión no se habla de «precisión» como porcentaje de aciertos (eso es clasificación): un valor continuo casi nunca coincide exactamente con la predicción. Se habla de magnitud del error (MAE, RMSE) y de varianza explicada (\(R^2\)).
9.11 Resumen de métricas
| Métrica | Tipo | Cuándo usarla |
|---|---|---|
| Accuracy | Clasificación | Clases balanceadas |
| Precision | Clasificación | Falsos positivos costosos |
| Recall | Clasificación | Falsos negativos costosos |
| F1-Score | Clasificación | Equilibrio precision/recall |
| AUC-ROC | Clasificación | Capacidad discriminativa global |
| AUC-PR | Clasificación | Clases desbalanceadas |
| MSE | Regresión | Error promedio al cuadrado |
| MAE | Regresión | Error en unidades originales, robusto |
| RMSE | Regresión | Unidades originales, penaliza errores grandes |
| \(R^2\) | Regresión | Varianza explicada, comparable entre problemas |
10 Regularización
Si obligamos a los parámetros a ser pequeños, el modelo se vuelve más suave y simple, y por tanto menos propenso a sobreajustarse. Una forma común de lograrlo es añadir a la función de coste \(J\) una penalización proporcional al cuadrado de los pesos:
El hiperparámetro \(\lambda\) controla la fuerza de la penalización:
- \(\lambda\) pequeño: poca regularización, riesgo de sobreajuste.
- \(\lambda\) grande: los pesos se reducen tanto que el modelo se vuelve rígido (subajuste).
Esta es la conocida como regularización L2 o de Ridge. Observa que ya apareció en otro capítulo: en las Máquinas de Vectores de Soporte el parámetro \(C\) actúa como el inverso de la regularización (un \(C\) grande equivale a una regularización débil).
La Figura 2 mostraba el sobreajuste con un polinomio de grado 15. La demo siguiente compara ese ajuste sin regularizar frente a la versión regularizada: el error de prueba baja al suavizar el modelo.
import numpy as np
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import LinearRegression, Ridge
from sklearn.model_selection import train_test_split

rng = np.random.default_rng(0)
x = np.linspace(0, 1, 30)
y = np.sin(2 * np.pi * x) + rng.normal(0, 0.30, size=x.shape)
X_tr, X_te, y_tr, y_te = train_test_split(
    x.reshape(-1, 1), y, test_size=0.5, random_state=0)

for nombre, modelo in [
    ("sin regularizar",
     Pipeline([("p", PolynomialFeatures(15)), ("lr", LinearRegression())])),
    ("Ridge (regularizado)",
     Pipeline([("p", PolynomialFeatures(15)), ("lr", Ridge(alpha=0.1))])),
]:
    m = modelo.fit(X_tr, y_tr)
    print(nombre, "-> error de prueba:",
          round(np.mean((m.predict(X_te) - y_te) ** 2), 4))
sin regularizar -> error de prueba: 187257.4421
Ridge (regularizado) -> error de prueba: 0.0871
Figura 5
10.1 Regularización L1 (Lasso)
La regularización L2 reduce los pesos pero nunca los hace exactamente cero. La L1, introducida por Tibshirani (1996), usa la suma del valor absoluto de los pesos como penalización:
¿Por qué esto importa? La penalización L1 fuerza a que muchos pesos sean exactamente cero, lo que equivale a una selección automática de características. En un dataset con 100 variables, Lasso puede devolver un modelo que solo usa 10 de ellas, haciendo el modelo más interpretable y reduciendo el costo de inferencia.
Intuición geométrica. En 2D, la región factible de L2 es un círculo (\(w_1^2 + w_2^2 \leq t\)) y la de L1 es un rombo (\(|w_1| + |w_2| \leq t\)). Las curvas de nivel de \(J\) son elipses. El punto de tangencia entre la elipse y la región factible es donde está el mínimo. Como los vértices del rombo están sobre los ejes, la tangencia tiende a caer en \(w_j = 0\), eliminando variables.
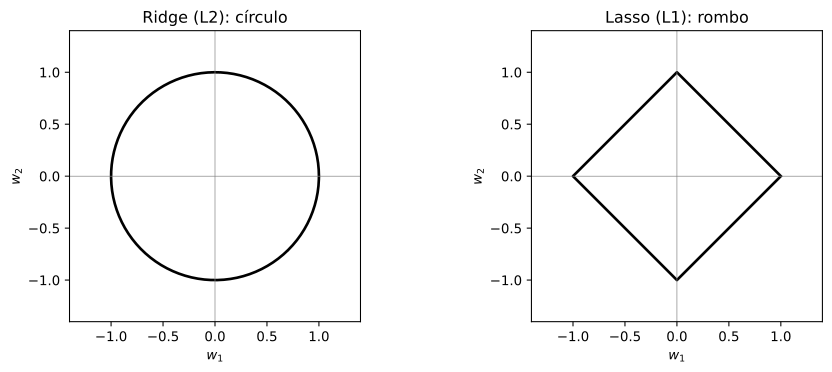
Figura 6: Ridge vs Lasso: la región factible de L1 (rombo) tiende a producir intersecciones en los ejes, forzando pesos a cero.
La demo siguiente muestra cómo Lasso reduce a cero los pesos de las características menos relevantes:
from sklearn.linear_model import Lasso
from sklearn.preprocessing import StandardScaler
from sklearn.datasets import make_regression
import numpy as np

X, y = make_regression(n_samples=100, n_features=20,
                       n_informative=5, noise=10, random_state=0)
scaler = StandardScaler().fit(X)
X_scaled = scaler.transform(X)

lasso = Lasso(alpha=1.0).fit(X_scaled, y)
n_no_cero = np.sum(lasso.coef_ != 0)
print(f"Características seleccionadas: {n_no_cero}/20")
print(f"Pesos no nulos: {lasso.coef_[lasso.coef_ != 0].round(2)}")
Características seleccionadas: 11/20
Pesos no nulos: [ 5.509e+01 -6.100e-01  3.641e+01 -2.380e+00  9.800e-01 -1.000e-02
  3.905e+01  1.110e+00  7.940e+00  7.270e+00  4.200e-01]
10.2 Regularización Elastic Net
Elastic Net (Zou & Hastie, 2005) combina L1 y L2 en una sola penalización:
En la práctica se parametriza con un solo hiperparámetro \(r \in [0,1]\) que mezcla ambas penalizaciones:
- \(r = 1\): solo L1 (puro Lasso).
- \(r = 0\): solo L2 (puro Ridge).
- \(0 < r < 1\): combinación de ambos.
¿Cuándo usar Elastic Net en vez de Lasso puro? Cuando hay características altamente correlacionadas. Lasso tiende a elegir solo una de ellas e ignorar las demás, lo cual puede ser inestable. Elastic Net agrupa las correlacionadas y las selecciona o descarta juntas, dando un modelo más estable.
from sklearn.linear_model import ElasticNet, Lasso, Ridge
from sklearn.preprocessing import StandardScaler
from sklearn.datasets import make_regression
import numpy as np

X, y = make_regression(n_samples=100, n_features=20,
                       n_informative=5, noise=10, random_state=0)
X_scaled = StandardScaler().fit_transform(X)

for nombre, modelo in [
    ("Ridge", Ridge(alpha=1.0)),
    ("Lasso", Lasso(alpha=1.0)),
    ("ElasticNet (r=0.5)", ElasticNet(alpha=1.0, l1_ratio=0.5)),
]:
    m = modelo.fit(X_scaled, y)
    n = np.sum(m.coef_ != 0)
    print(f"{nombre:20s}  pesos no nulos: {n:2d}/20  "
          f"error train: {np.mean((m.predict(X_scaled)-y)**2):.2f}")
Ridge                 pesos no nulos: 20/20  error train: 100.65
Lasso                 pesos no nulos: 11/20  error train: 116.23
ElasticNet (r=0.5)    pesos no nulos: 20/20  error train: 799.93
10.3 Comparación de técnicas de regularización
| Técnica | Penalización | Selección de variables | Cuándo usarla |
|---|---|---|---|
| Ridge (L2) | \(\lambda \sum w_j^2\) | No (reduce todos) | Variables correlacionadas, todas relevantes |
| Lasso (L1) | $\lambda \sum | w_j | $ |
| Elastic Net | $\lambda(r\sum | w_j | + \frac{1-r}{2}\sum w_j^2)$ |
| Early stopping | — | No | Redes neuronales, entrenamiento iterativo |
| Dropout | — | No | Redes neuronales profundas |
| Data augmentation | — | No | Imágenes, datos insuficientes |
11 Otras técnicas de regularización
La regularización L2 es la más general, pero existen otras formas de combatir la varianza. Las dos siguientes merecen una explicación más detallada porque se usan constantemente en la práctica.
11.1 Aumento de datos (data augmentation)
A menudo la mejor cura para el sobreajuste es más datos, pero conseguirlos puede ser caro o imposible. El data augmentation consiste en generar nuevas muestras de entrenamiento “sintéticas” a partir de las existentes, aplicando transformaciones que no cambian la etiqueta.
Por ejemplo, en visión por computadora (clasificar gatos frente a perros): * Volteo horizontal: un gato es un gato aunque mire a un lado o a otro. * Rotación, zoom y recortes aleatorios, distorsiones de color: el objeto sigue siendo el mismo. En OCR (reconocimiento de dígitos), se pueden rotar y distorsionar levemente los “4” para que el modelo aprenda que un 4 sigue siendo un 4 bajo distintas escrituras.
La clave es que las transformaciones preserven la etiqueta: no sirve voltear una imagen si eso cambia su significado. El aumento de datos es, en el fondo, una regularización, porque expande el conjunto de entrenamiento y obliga al modelo a aprender invarianzas (reconocer el patrón pese a pequeñas variaciones). En dominios sin imágenes también aplica: en series temporales se añade ruido o se desplaza ligeramente la señal; en texto, sinónimos o traducción ida y vuelta.
La Figura 7 muestra la idea en 2D: a partir de pocos puntos originales generamos copias con pequeñas perturbaciones para “rellenar” el espacio de entrenamiento.
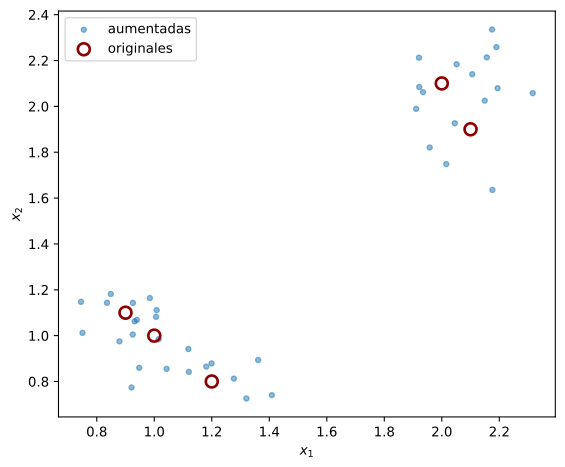
Figura 7: Aumento de datos: de pocos puntos originales (círculos) se generan muestras sintéticas (puntos) con pequeñas perturbaciones, ampliando el conjunto de entrenamiento.
11.2 Parada temprana (early stopping)
La parada temprana es una regularización que detiene el entrenamiento antes de que el modelo sobreajuste del todo. Mientras se entrena, se monitoriza el error tanto en entrenamiento como en validación (dev):
- El error de entrenamiento baja monótonamente con cada iteración.
- El error de validación baja al principio, pero en algún punto empieza a subir: es la señal de que el modelo está memorizando el ruido.
Se detiene el entrenamiento en el instante en que el error de validación es mínimo y se guardan esos parámetros. La Figura 8 ilustra ese momento exacto.
¿Por qué funciona? Al inicio, los pesos \(W\) se inicializan pequeños; conforme avanza el entrenamiento, crecen. Parar “a media altura” deja los pesos con norma media, lo cual tiene el mismo efecto que la regularización L2: pesos pequeños \(\Rightarrow\) modelo más simple \(\Rightarrow\) menos sobreajuste.
Crítica (principio de ortogonalización). En ideal, optimizar la función de coste \(J\) y evitar el sobreajuste deberían ser tareas separadas (una para el descenso de gradiente, otra para L2/dropout). La parada temprana las mezcla: sacrifica minimizar \(J\) a cambio de menos varianza. Por eso muchos profesionales prefieren usar L2 y entrenar todo lo posible. Su gran ventaja sigue siendo la eficiencia: una sola pasada de entrenamiento basta para obtener un modelo razonable.
El código de la Figura 8 busca exactamente ese mínimo: mejor = ep[np.argmin(err_dev)].
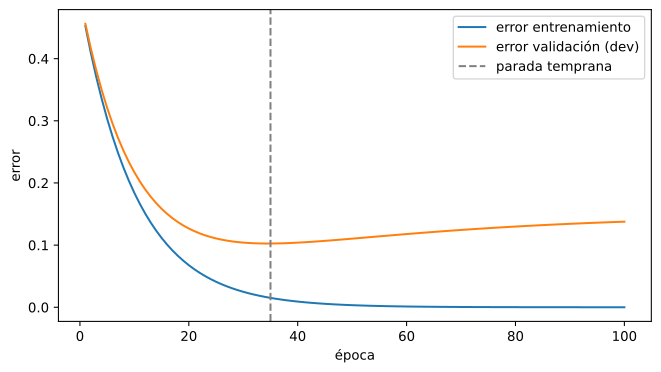
Figura 8: Early stopping: el error de entrenamiento baja siempre, pero el de validación alcanza un mínimo y luego sube; se detiene en ese mínimo.
11.3 Otras opciones
- Selección de características: cuando hay muchas variables y pocos datos, eliminar las menos relevantes reduce el sobreajuste (a cambio de descartar parte de la información).
- Dropout (redes neuronales): desactivar neuronas al azar durante el entrenamiento, lo que obliga a la red a ser más robusta y actúa como una regularización adaptativa de los pesos.
Todas estas técnicas se suman a la L2 y convienen especialmente cuando el modelo ya muestra alta varianza.