Entrenamiento y optimización
1 Introducción
Ajustar un modelo no es solo elegir el algoritmo: también importa cómo se entrena. Este capítulo reúne las técnicas fundamentales para entrenar redes neuronales de forma eficiente: desde el descenso de gradiente por minilotes hasta los optimizadores modernos (Momentum, RMSprop, Adam), pasando por la normalización por lotes y la búsqueda de hiperparámetros.
2 Convergencia del descenso de gradiente
El objetivo del descenso de gradiente es encontrar los parámetros que minimicen la función de coste \(J\). Una forma sencilla de vigilarlo es dibujar la curva de aprendizaje: el valor de \(J\) en cada iteración.
Si el algoritmo funciona bien, \(J\) debe bajar iteración tras iteración y acabar estabilizándose (aplanándose) cuando converge. Cuando el entrenamiento no converge, en cambio, \(J\) baja al principio, parece estabilizarse un instante y luego remonta en forma de U, porque la optimización deja de acercarse al mínimo y empieza a alejarse. Dos señales de alarma:
- Si \(J\) sube de forma sostenida en lugar de bajar, el entrenamiento no está convergiendo (conviene revisar el proceso de optimización o buscar un error en el código).
- Para decidir cuándo parar de forma automática se usa una prueba de convergencia: si la disminución de \(J\) entre iteraciones es menor que un umbral \(\varepsilon\) (por ejemplo, \(0.001\)), consideramos que ya convergió.
La Figura 1 compara las dos situaciones cualitativas: una convergencia correcta, donde \(J\) baja suavemente hasta aplanarse, frente a un entrenamiento que no converge, donde \(J\) baja, se aplana un momento y luego remonta. (Es una ilustración conceptual del comportamiento típico de la curva de aprendizaje; en problemas reales, sobre todo con redes neuronales, es frecuente observar esta forma de U cuando la optimización deja de estabilizarse.)
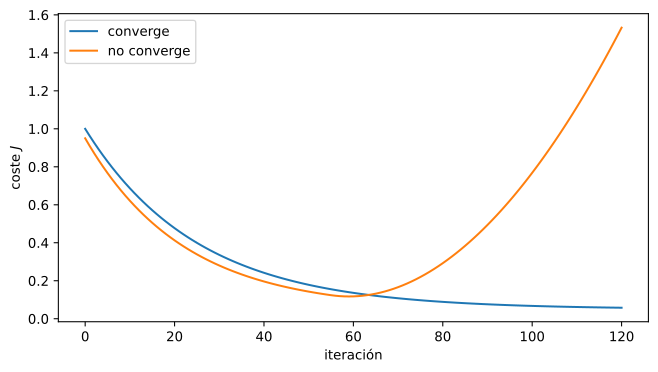
Figura 1: Esquema conceptual de la curva de aprendizaje: en una convergencia correcta J baja y se aplana; si el entrenamiento no converge, J baja, se aplana un momento y luego remonta en forma de U.
3 Normalización de entradas
Antes de entrenar (sobre todo con descenso de gradiente o con métodos basados en distancias, como KNN o PCA), conviene normalizar las variables. El proceso tiene dos pasos aplicados a cada característica:
- Centrado: restar la media \(\mu\) de la característica, para que quede con media cero.
- Escalado: dividir por la desviación típica \(\sigma\), para que la varianza sea 1.
¿Por qué importa? Sin normalizar, las características con mayor escala dominan el cálculo aunque sean menos relevantes. En métodos basados en distancias (KNN, PCA, k-medias) una variable con valores grandes contribuye mucho más a la distancia que otra en una escala pequeña, así que el algoritmo la trata como si fuera más importante. Lo mismo pasa con el descenso de gradiente: si un parámetro tiene una escala muy distinta, la superficie de coste queda alargada y el paso de aprendizaje afecta de forma desigual a cada dimensión. Al centrar y escalar, todas las variables compiten en pie de igualdad.
Los valores de \(\mu\) y \(\sigma\) se calculan solo con el conjunto de entrenamiento, y se aplican tal cual al de prueba (no se recalculan). Así ambos pasan por la misma transformación.
Veamos un ejemplo numérico con dos características de escalas muy distintas:
| Ejemplo | \(x_1\) (escala grande) | \(x_2\) (escala pequeña) |
|---|---|---|
| 1 | 100 | 2 |
| 2 | 102 | 3 |
| 3 | 98 | 1 |
La media de \(x_1\) es \(100\) y la de \(x_2\) es \(2\). Tras centrar, \(x_1\) queda en \(\{0, 2, -2\}\) y \(x_2\) en \(\{0, 1, -1\}\). Las desviaciones típicas son \(\sigma_1 \approx 1.63\) y \(\sigma_2 \approx 0.82\), de modo que tras escalar ambas características quedan en el mismo rango. Comprobémoslo:
import numpy as np
from sklearn.preprocessing import StandardScaler

X = np.array([[100., 2], [102, 3], [98, 1]])
sc = StandardScaler().fit(X)
print("medias (mu):", sc.mean_)
print("desviaciones (sigma):", sc.scale_)
print("datos normalizados:\n", np.round(sc.transform(X), 3))
medias (mu): [100.   2.]
desviaciones (sigma): [1.63299316 0.81649658]
datos normalizados:
 [[ 0.     0.   ]
 [ 1.225  1.225]
 [-1.225 -1.225]]
La Figura 2 muestra el efecto visual: de un conjunto alargado (una variable domina) pasamos a uno equilibrado.
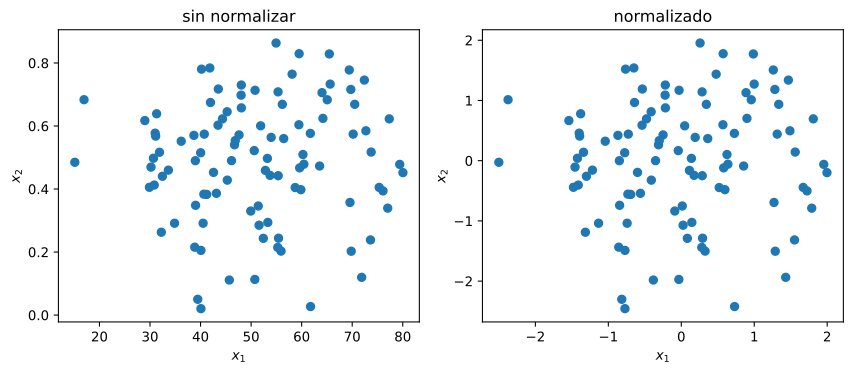
Figura 2: Antes de normalizar, una variable domina la escala; tras centrar y escalar, ambas son comparables.
4 Descenso de gradiente por minilotes
El descenso de gradiente por lotes (batch) procesa todo el conjunto de entrenamiento para dar un solo paso. Si hay millones de ejemplos, cada paso es lentísimo. El mini-batch divide los datos en subconjuntos pequeños (p. ej. de 32 o 64 ejemplos) y actualiza los parámetros después de cada uno, permitiendo avanzar mucho antes de terminar de ver todos los datos.
Una época es una pasada completa por todo el conjunto de entrenamiento. Tras varias épocas, el modelo suele converger. La Figura 3 compara el coste por época del batch (suave) frente al mini-batch (más ruidoso, pero cada época contiene muchos más pasos de actualización).
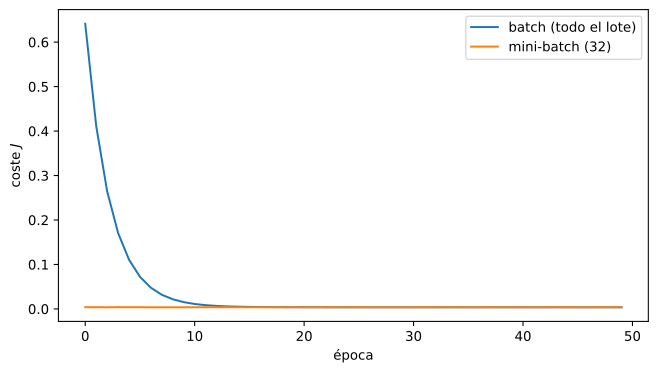
Figura 3: Coste por época: batch (suave, un paso por época) frente a mini-batch de 32 (más pasos y algo de ruido, pero avanza antes).
4.1 ¿Por qué funciona el mini-batch?
El problema surge cuando el número de ejemplos \(M\) es muy grande (por ejemplo, 5 millones). Con el descenso de gradiente por lotes, tienes que procesar todos los \(M\) ejemplos para calcular un solo paso de gradiente. Esto hace que cada actualización sea extremadamente lenta.
La idea del mini-batch es permitir que el algoritmo comience a hacer progreso y actualice los parámetros incluso antes de terminar de procesar todo el conjunto de entrenamiento.
Ventajas del mini-batch:
- Mayor velocidad de actualización: En una sola época, el batch realiza 1 actualización de parámetros. El mini-batch realiza \(M / \text{tamaño\_minilote}\) actualizaciones.
- Proceso paralelizable: La vectorización permite procesar los ejemplos del minilote casi simultáneamente en GPUs.
- Convergencia más rápida: Aunque los gradientes son “ruidosos”, las actualizaciones frecuentes permiten que el optimizador se mueva hacia la solución más rápidamente en la práctica.
4.2 Tamaño del minilote
El tamaño del minilote es un hiperparámetro crucial:
- Tamaño = \(M\) (batch completo): Gradiente preciso pero muy lento para datos grandes.
- Tamaño = 1 (SGD puro): Muy ruidoso y pierde la ventaja de la vectorización.
- Tamaño intermedio (mini-batch): El punto óptimo en la práctica.
Recomendaciones:
- Si \(M < 2000\): usar batch completo.
- Si \(M\) es grande: tamaños típicos de 64 a 512 (potencias de 2 para eficiencia en memoria).
- Asegurar que el minilote quepa en la memoria de la GPU.
Nota
Curva de coste mini-batch: Es normal que la función de costo oscile en cada iteración porque cada minilote es una muestra diferente. La tendencia general debe ser decreciente, pero no monótona como en el batch completo.
5 Promedios ponderados exponenciales
Los promedios ponderados exponenciales (EWA, por sus siglas en inglés) son la base de los optimizadores modernos (Momentum, RMSprop, Adam). La idea es mantener un promedio móvil de los gradientes para suavizar las actualizaciones.
5.1 La fórmula fundamental
Donde: - \(v_t\) es el promedio acumulado en el paso \(t\) - \(\beta\) es el hiperparámetro de suavizado (típicamente 0.9) - \(\theta_t\) es el valor actual (temperatura, gradiente, etc.)
Intuición: \(v_t\) es aproximadamente un promedio de los últimos \(\frac{1}{1-\beta}\) valores.
| \(\beta\) | Ventana efectiva |
|---|---|
| 0.9 | ~10 valores |
| 0.98 | ~50 valores |
| 0.999 | ~1000 valores |
5.2 Ejemplo con temperaturas
Imagina que registramos la temperatura diaria en Londres. Con \(\beta = 0.9\):
Si expandimos, vemos que \(v_{100}\) es una suma ponderada donde el peso decae exponencialmente: \(\theta_{100}\) tiene peso 0.1, \(\theta_{99}\) tiene peso \(0.9 \times 0.1 = 0.09\), \(\theta_{98}\) tiene peso \(0.9^2 \times 0.1 = 0.081\), etc.
Ventaja computacional: Solo necesitas almacenar un número real (\(v_{t-1}\)) en memoria. Cada actualización es una operación de una sola línea.
5.3 Corrección de sesgo
Cuando inicializamos \(v_0 = 0\), las primeras estimaciones están sesgadas hacia cero. Para corregirlo:
A medida que \(t\) crece, \(\beta^t \to 0\) y la corrección se vuelve insignificante. En la práctica, muchas implementaciones omiten la corrección porque el sesgo se disipa rápidamente.
6 Descenso de gradiente con momento
El descenso de gradiente estándar sufre de oscilaciones lentas cuando la función de coste tiene contornos alargados. El momento resuelve esto usando un EWA de los gradientes.
6.1 El algoritmo
En cada iteración \(t\):
Paso 1: Calcular gradientes \(dw\), \(db\) del mini-lote actual.
Paso 2: Actualizar promedios ponderados:
Paso 3: Actualizar parámetros:
6.2 Analogía: bola rodando
Piensa en una bola rodando por una colina:
- Los gradientes son la fuerza que acelera la bola.
- Los términos de momento (\(v_{dw}\), \(v_{db}\)) representan la velocidad de la bola.
- \(\beta\) es la fricción: evita que la bola acelere indefinidamente.
¿Por qué funciona?
- Amortigua oscilaciones: En direcciones donde los gradientes oscilan (cambian de signo), los promedios se cancelan y el paso es pequeño.
- Acelera en direcciones consistentes: Donde los gradientes apuntan en la misma dirección, los promedios acumulan impulso y el paso es grande.
6.3 Hiperparámetros
- \(\alpha\) (tasa de aprendizaje): Determina el tamaño de los pasos.
- \(\beta\) (momento): Valor típico 0.9 (promedio de ~10 iteraciones).
- Corrección de sesgo: En la práctica, no se suele aplicar porque después de ~10 iteraciones el sesgo es insignificante.
Tip
El descenso de gradiente con momento casi siempre supera al estándar en velocidad de convergencia. Es una de las primeras y más importantes mejoras en optimización para aprendizaje profundo.
7 RMSprop
RMSprop (Root Mean Square Propagation) ajusta la tasa de aprendizaje para cada parámetro individualmente, usando un EWA de los cuadrados de los gradientes.
7.1 El algoritmo
En cada iteración \(t\):
Paso 1: Calcular gradientes \(dw\), \(db\).
Paso 2: Actualizar promedios de cuadrados:
Paso 3: Actualizar parámetros:
Donde \(\epsilon\) (típicamente \(10^{-8}\)) evita divisiones por cero.
7.2 ¿Por qué funciona?
Si un gradiente ha sido consistentemente grande para un parámetro, \(S_{dw}\) será grande y el denominador \(\sqrt{S_{dw}}\) será grande, lo que reduce la tasa de aprendizaje para ese parámetro. Si el gradiente ha sido pequeño, la tasa de aprendizaje se mantiene alta.
Resultado: El algoritmo avanza más rápido en direcciones con gradientes estables y pequeños, y con más cautela en direcciones con gradientes grandes e inestables.
7.3 Hiperparámetros
- \(\beta_2\): Valor típico 0.999 (promedio más largo que Momentum).
- \(\epsilon\): \(10^{-8}\) (rara vez se ajusta).
Nota
RMSprop no se publicó formalmente en un artículo, sino que se popularizó a través de un curso de Coursera impartido por Geoffrey Hinton.
8 Adam
Adam (Adaptive Moment Estimation) combina las fortalezas de Momentum y RMSprop. Es el optimizador más utilizado en la práctica.
8.1 El algoritmo
Inicialización:
En cada iteración \(t\):
Paso 1: Calcular gradientes \(dw\), \(db\).
Paso 2: Primer momento (Momentum):
Paso 3: Segundo momento (RMSprop):
Paso 4: Corrección de sesgo:
Paso 5: Actualizar parámetros:
8.2 Valores por defecto recomendados
| Hiperparámetro | Valor por defecto | Descripción |
|---|---|---|
| \(\alpha\) | Ajustar | Tasa de aprendizaje (el más importante) |
| \(\beta_1\) | 0.9 | Primer momento (Momentum) |
| \(\beta_2\) | 0.999 | Segundo momento (RMSprop) |
| \(\epsilon\) | \(10^{-8}\) | Estabilidad numérica |
Importante
En la práctica, los valores por defecto de \(\beta_1\), \(\beta_2\) y \(\epsilon\) funcionan excepcionalmente bien. El único hiperparámetro que necesitas ajustar habitualmente es la tasa de aprendizaje \(\alpha\).
8.3 ¿Por qué “Adam”?
El nombre proviene de “Adaptive Moment Estimation”:
- Adaptive: Ajusta la tasa de aprendizaje para cada parámetro individualmente.
- Moment Estimation: Calcula los “momentos” de los gradientes:
- Primer momento: la media (relacionado con Momentum).
- Segundo momento: la media de los cuadrados (relacionado con RMSprop).
9 Decadencia de la tasa de aprendizaje
Si mantienes una tasa de aprendizaje \(\alpha\) fija y alta, el algoritmo puede oscilar alrededor del mínimo sin converger. La decadencia de la tasa de aprendizaje resuelve esto reduciendo \(\alpha\) con el tiempo.
9.1 Fórmulas comunes
Decadencia por tiempo (time-based):
Decadencia exponencial:
Decadencia por etapas: Reducir \(\alpha\) un factor (p. ej. 0.1) cada N épocas.
9.2 Recomendación
La decadencia de la tasa de aprendizaje es una optimización secundaria. Primero encuentra un buen valor fijo para \(\alpha_0\) con un buen optimizador (como Adam). Una vez que tienes una buena base, la decadencia puede ayudarte a exprimir un rendimiento adicional.
10 Óptimos locales y puntos de silla
Una preocupación común es quedar atrapado en óptimos locales malos. Sin embargo, la teoría moderna muestra que este no es el principal problema en redes neuronales de alta dimensión.
10.1 Los puntos de silla son más comunes
En un espacio con 20,000 dimensiones, para que un punto sea un óptimo local, la función debe curvarse hacia arriba en todas las 20,000 direcciones. La probabilidad es casi \(2^{-20,000}\).
Lo que sí encontramos son puntos de silla: puntos donde el gradiente es cero, pero en algunas direcciones la función sube y en otras baja. Los algoritmos de optimización pueden “escapar” de estos puntos.
10.2 El verdadero problema: las mesetas
Las mesetas son regiones donde el gradiente es muy cercano a cero. El algoritmo avanza extremadamente lento, como arrastrándose por una superficie casi horizontal.
Los optimizadores modernos (Momentum, RMSprop, Adam) están diseñados para acumular impulso en mesetas, permitiendo pasar más rápido por estas regiones planas.
Tip
Conclusión práctica: No te preocupes por los óptimos locales en redes neuronales grandes. Preocúpate por las mesetas y usa optimizadores como Adam que las navegan eficientemente.
11 Normalización por lotes (Batch Normalization)
La Normalización por Lotes (Batch Normalization o Batch Norm) es una de las innovaciones más importantes en aprendizaje profundo. Normaliza los valores internos de la red para que cada capa reciba entradas con una distribución más estable.
11.1 La intuición
Ya sabemos que normalizar las características de entrada (\(X\)) acelera el aprendizaje. Batch Norm extiende esta idea a las capas intermedias de la red.
Aunque podríamos normalizar las activaciones \(A^{[l]}\), en la práctica es más efectivo normalizar los valores antes de la función de activación, es decir, \(Z^{[l]}\).
11.2 El algoritmo
Para cada capa \(l\), dado un mini-lote de \(m\) ejemplos \(Z^{[l]} = [z^{[l](1)}, z^{[l](2)}, \ldots, z^{[l](m)}]\):
Paso 1: Calcular media y varianza por neurona (por fila):
Paso 2: Normalizar:
Paso 3: Escalar y desplazar (con parámetros aprendibles \(\gamma\) y \(\beta\)):
Nota
Los parámetros \(\gamma\) y \(\beta\) permiten a la red “deshacer” la normalización si lo considera óptimo, o ajustar la distribución a una media y varianza diferentes.
11.3 Integración en la red
Tradicionalmente: 1. \(Z^{[l]} = W^{[l]}A^{[l-1]} + b^{[l]}\) 2. \(A^{[l]} = g^{[l]}(Z^{[l]})\)
Con Batch Norm: 1. \(Z^{[l]} = W^{[l]}A^{[l-1]} + b^{[l]}\) 2. \(\tilde{Z}^{[l]} = \text{BatchNorm}(Z^{[l]})\) 3. \(A^{[l]} = g^{[l]}(\tilde{Z}^{[l]})\)
Nota: Cuando se usa Batch Norm, el parámetro del sesgo \(b^{[l]}\) se puede eliminar porque la normalización lo cancela (se puede poner siempre a cero).
11.4 ¿Por qué funciona?
11.4.1 1. Estabilización de entradas
Al normalizar los valores \(Z^{[l]}\) de cada neurona, asegura que las entradas a las capas subsiguientes tengan una distribución más consistente. Los pesos no tienen que adaptarse a rangos de entrada constantemente cambiantes.
11.4.2 2. Mitigación del cambio de covarianza interno
En una red profunda, cada capa recibe activaciones de la capa anterior. A medida que los parámetros se actualizan, la distribución de las activaciones cambia constantemente. Esto obliga a las capas posteriores a reajustarse continuamente.
Batch Norm limita la cantidad en que la distribución puede cambiar, desacoplando el aprendizaje entre capas.
11.4.3 3. Efecto regularizador ligero
La media y varianza se calculan por mini-lote, lo que introduce un pequeño ruido en las activaciones. Este ruido, similar al de Dropout, impide que las neuronas dependan demasiado de unidades específicas.
Nota: El efecto regularizador es pequeño. No confíes en Batch Norm como tu principal estrategia de regularización; aún puedes combinarlo con Dropout.
11.5 Entrenamiento vs Predicción
Durante el entrenamiento: Se usa la media y varianza del mini-lote actual.
Durante la predicción: No hay mini-lote. Se usa un promedio móvil exponencial de las medias y varianzas calculadas durante el entrenamiento.
Esto permite hacer inferencia con un solo ejemplo de entrada.
12 Dropout
Dropout es una técnica de regularización para redes neuronales que funciona desactivando aleatoriamente neuronas durante el entrenamiento. En cada iteración, cada neurona tiene una probabilidad \(p\) de ser “apagada” (puesta a cero). Esto obliga a la red a no depender de ninguna neurona específica, forzando representaciones más robustas.
12.1 La intuición
Imagina una red neuronal donde, en cada ejemplo de entrenamiento, algunas neuronas desaparecen aleatoriamente. La red no puede “confiar” en ninguna neurona en particular, así que aprende representaciones más distribuidas y robustas.
Es como si, en un equipo de trabajo, cada día faltara un miembro aleatorio. El equipo debe organizarse para que el trabajo se pueda hacer sin depender de una sola persona.
12.2 El algoritmo
12.2.1 Forward propagation con Dropout
Para cada capa \(l\) con activaciones \(A^{[l]}\):
Paso 1: Generar máscara aleatoria:
Paso 2: Apagar neuronas:
Paso 3: Escalar para compensar:
Importante
¿Por qué escalar? Si desactivamos el 50% de las neuronas, la salida esperada se reduce a la mitad. Al dividir por keep_prob, mantenemos la magnitud esperada de las activaciones, evitando que la siguiente capa reciba señales más débiles.
12.2.2 Backward propagation con Dropout
El mismo mask \(D^{[l]}\) se usa para apagar los gradientes correspondientes:
Esto garantiza que las neuronas desactivadas no reciban gradientes durante la retropropagación.
12.3 Código ejemplo
import numpy as np

def relu(Z):
    return np.maximum(0, Z)

def sigmoid(Z):
    return 1 / (1 + np.exp(-Z))

def forward_with_dropout(X, parameters, keep_prob=0.5):
    np.random.seed(1)
    W1, b1 = parameters["W1"], parameters["b1"]
    W2, b2 = parameters["W2"], parameters["b2"]
    W3, b3 = parameters["W3"], parameters["b3"]

    Z1 = np.dot(W1, X) + b1
    A1 = relu(Z1)
    D1 = (np.random.rand(*A1.shape) < keep_prob).astype(int)
    A1 = A1 * D1 / keep_prob

    Z2 = np.dot(W2, A1) + b2
    A2 = relu(Z2)
    D2 = (np.random.rand(*A2.shape) < keep_prob).astype(int)
    A2 = A2 * D2 / keep_prob

    Z3 = np.dot(W3, A2) + b3
    A3 = sigmoid(Z3)

    cache = (Z1, D1, A1, W1, b1, Z2, D2, A2, W2, b2, Z3, A3, W3, b3)
    return A3, cache

def backward_with_dropout(X, Y, cache, keep_prob):
    m = X.shape[1]
    (Z1, D1, A1, W1, b1, Z2, D2, A2, W2, b2, Z3, A3, W3, b3) = cache

    dZ3 = A3 - Y
    dW3 = 1./m * np.dot(dZ3, A2.T)
    db3 = 1./m * np.sum(dZ3, axis=1, keepdims=True)
    dA2 = np.dot(W3.T, dZ3)
    dA2 = dA2 * D2 / keep_prob
    dZ2 = np.multiply(dA2, (A2 > 0).astype(int))
    dW2 = 1./m * np.dot(dZ2, A1.T)
    db2 = 1./m * np.sum(dZ2, axis=1, keepdims=True)
    dA1 = np.dot(W2.T, dZ2)
    dA1 = dA1 * D1 / keep_prob
    dZ1 = np.multiply(dA1, (A1 > 0).astype(int))
    dW1 = 1./m * np.dot(dZ1, X.T)
    db1 = 1./m * np.sum(dZ1, axis=1, keepdims=True)

    return {"dW1": dW1, "db1": db1, "dW2": dW2, "db2": db2, "dW3": dW3, "db3": db3}
12.4 Predicción sin Dropout
Durante la predicción, NO se aplica Dropout. Todas las neuronas están activas. No se genera máscara aleatoria ni se escala.
def predict(X, parameters):
    a3, _ = forward_propagation(X, parameters)  # sin dropout
    return (a3 > 0.5).astype(int)
12.5 Hiperparámetro keep_prob
keep_prob |
Neuronas activas | Uso típico |
|---|---|---|
| 1.0 | 100% (sin dropout) | Predicción |
| 0.8 | 80% | Capas de entrada |
| 0.5 | 50% | Capas ocultas (más agresivo) |
Recomendación: Usar el mismo keep_prob para todas las capas ocultas. Empezar con 0.5 y ajustar según el sobreajuste.
12.6 Efecto regularizador
Dropout introduce ruido en las activaciones, similar a Batch Norm. Esto impide que las neuronas se especialicen demasiado en patrones específicos del entrenamiento, forzando representaciones más generalizables.
Nota
Dropout + L2: Se pueden combinar. Dropout regulariza desactivando neuronas; L2 regulariza penalizando pesos grandes. Juntos suelen dar mejores resultados que cualquiera de los dos por separado.
12.7 Cuándo usar Dropout
- Redes grandes con muchas capas/parámetros
- Cuando hay mucho sobreajuste (error de entrenamiento bajo, error de validación alto)
- No usar en redes pequeñas o cuando no hay sobreajuste
13 Búsqueda de hiperparámetros
13.1 Jerarquía de importancia
No todos los hiperparámetros son igual de importantes:
| Prioridad | Hiperparámetro | Valor típico |
|---|---|---|
| 1 (Crucial) | Tasa de aprendizaje \(\alpha\) | Ajustar |
| 2 (Importante) | \(\beta\) del momento | 0.9 |
| Tamaño del mini-lote | 64-512 | |
| Unidades ocultas | Ajustar | |
| 3 (Secundario) | Número de capas | Ajustar |
| Decadencia de \(\alpha\) | Ajustar | |
| 4 (Fijo) | \(\beta_1\), \(\beta_2\), \(\epsilon\) de Adam | 0.9, 0.999, \(10^{-8}\) |
13.2 Estrategias de búsqueda
13.2.1 Muestreo aleatorio (recomendado)
En lugar de búsqueda en cuadrícula, usa muestreo aleatorio. Si un hiperparámetro es mucho más importante que otro, la cuadrícula “desperdicia” recursos probando valores del parámetro menos importante.
13.2.2 Búsqueda por refinamiento (coarse-to-fine)
- Búsqueda gruesa: Muestreo aleatorio en un rango amplio.
- Refinamiento: “Acercar el zoom” a la región con mejores resultados y muestrear más densamente.
13.3 Escala correcta al muestrear
13.3.1 Tasa de aprendizaje
Si quieres probar valores entre 0.0001 y 1, no uses escala lineal (90% de las muestras caerían entre 0.1 y 1). Usa escala logarítmica:
13.3.2 Beta del momento
Para \(\beta\) entre 0.9 y 0.999, muestrea \(1 - \beta\) en escala logarítmica:
13.4 Enfoques: Panda vs Caviar
| Enfoque | Cuándo usarlo | Descripción |
|---|---|---|
| 🐼 Panda | Pocos recursos computacionales | Entrena un modelo a la vez, ajusta manualmente |
| 🐠 Caviar | Muchos recursos computacionales | Entrena muchos modelos en paralelo, elige el mejor |
La elección depende de tu capacidad computacional. Si puedes entrenar muchos modelos en paralelo, el enfoque “Caviar” es más eficiente.
14 Resumen
| Técnica | Problema que resuelve | Impacto |
|---|---|---|
| Mini-batch GD | Batch completo demasiado lento | Convergencia más rápida |
| Momentum | Oscilaciones en valles estrechos | Pasos más directos |
| RMSprop | Tasas de aprendizaje desiguales | Adaptación por parámetro |
| Adam | Combina Momentum + RMSprop | Optimizador estándar |
| LR Decay | Oscilaciones alrededor del mínimo | Convergencia fina |
| Batch Norm | Distribuciones cambiantes entre capas | Entrenamiento más estable |
| Dropout | Sobreajuste en redes grandes | Regularización adaptativa |
| Búsqueda de hiperparámetros | Configuración subóptima | Mejor rendimiento |
Tip
Receta práctica: Usa Adam con los valores por defecto, un mini-batch de 128-256, y enfócate en encontrar una buena tasa de aprendizaje. Añade Batch Norm si la red es profunda. Usa Dropout si hay sobreajuste. Añade decadencia de \(\alpha\) solo si necesitas afinar la convergencia final.