Redes neuronales convolucionales (CNN)
1 ¿Por qué redes convolucionales?
En los capítulos anteriores estudiamos las redes neuronales totalmente conectadas (MLP), donde cada neurona de una capa se conecta con todas las neuronas de la capa anterior. Aunque este modelo es muy potente para datos tabulares, presenta dos limitaciones graves al aplicarlo a imágenes y visión por computadora:
- Explosión en el número de parámetros: Una fotografía estándar a color puede medir \(1000 \times 1000\) píxeles con 3 canales de color (RGB), lo que supone \(3\,000\,000\) de valores de entrada. Si conectamos esa entrada a una primera capa oculta modesta de apenas 1000 neuronas, necesitaríamos \(3 \times 10^9\) (3 mil millones) de pesos. Entrenar tal cantidad de parámetros es computacionalmente muy costoso y causaría un sobreajuste (overfitting). Un exceso de parámetros en un modelo de inteligencia artificial o aprendizaje automático necesita ser acompañado de muchísimos datos para evitar el sobreajuste (overfitting) y garantizar que el modelo aprenda reglas generales en lugar de memorizar el ruido.
- Pérdida de la estructura espacial: Una red densa aplana la imagen en un vector unidimensional largo, ignorando por completo que los píxeles adyacentes (arriba, abajo, izquierda, derecha) guardan una relación espacial íntima. Un gato sigue siendo un gato tanto si está en la esquina superior izquierda como en el centro de la foto (invarianza frente a traslaciones).
Para resolver estos problemas nacieron las redes neuronales convolucionales (Convolutional Neural Networks o CNN). En lugar de multiplicar toda la imagen por matrices grandes, las CNN aplican una operación matemática local y repetitiva llamada convolución.
2 La operación de convolución
Una imagen en escala de grises se representa como una matriz numérica bidimensional de dimensiones \(H \times W\) (alto \(\times\) ancho), donde cada celda contiene la intensidad lumínica del píxel (por ejemplo, de 0 a 255 o normalizado entre 0 y 1).
La convolución consiste en deslizar una pequeña matriz de pesos, denominada filtro o kernel (típicamente de tamaño \(3 \times 3\) o \(5 \times 5\)), a lo largo y ancho de la imagen. En cada posición:
- Se superpone el kernel sobre una región del mismo tamaño en la imagen.
- Se multiplican los valores correspondientes elemento a elemento.
- Se suman todos los productos resultantes para producir un único número escalar.
Al repetir este proceso en todas las posiciones posibles, se genera una nueva matriz llamada mapa de características (feature map o mapa de activaciones).
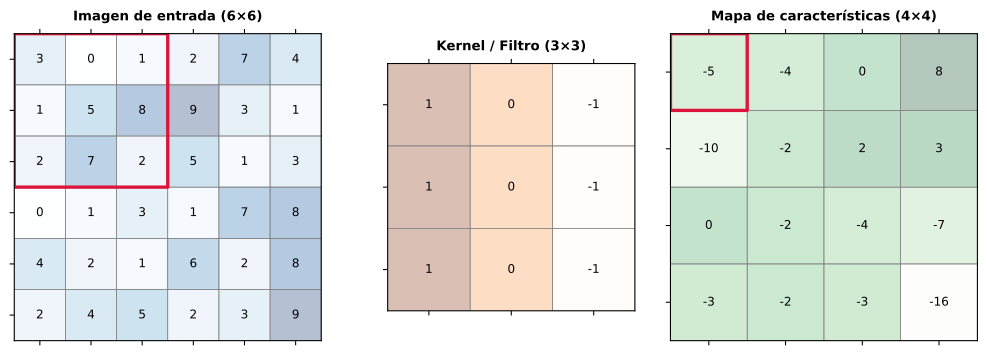
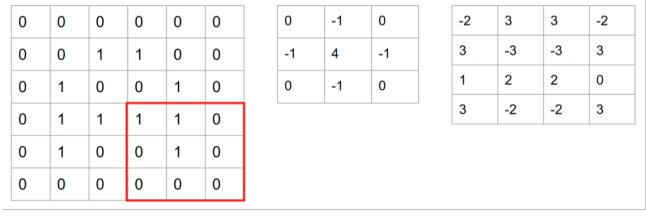
Figura 1: Operación de convolución: el kernel 3×3 (centro) se superpone sobre la esquina superior izquierda de la imagen 6×6 (izquierda), multiplica elemento a elemento y suma los resultados para calcular el primer valor (en rojo) del mapa de características 4×4 (derecha).
2.1 Ejemplo numérico paso a paso
Veamos el cálculo de la primera celda destacada en la Figura 1. La ventana superior izquierda de la imagen (\(3 \times 3\)) es:
Multiplicamos posición por posición y sumamos:
A continuación, desplazamos el kernel una columna hacia la derecha para calcular \(\text{Salida}_{(0,1)}\):
Repitiendo el desplazamiento fila a fila y columna a columna obtenemos la matriz completa de \(4 \times 4\).
Convolución matemática vs. Correlación cruzada en Deep Learning
En matemáticas puras y procesamiento digital de señales, la operación formal de convolución \((f * g)\) exige voltear (flip) el kernel horizontal y verticalmente (\(180^\circ\)) antes de multiplicar y sumar:
En el aprendizaje profundo, por convención universal, omitimos ese volteo y deslizamos el filtro directamente tal cual:
Esta operación se denomina técnicamente correlación cruzada (cross-correlation). En la práctica de las redes neuronales, como los pesos del kernel se inicializan aleatoriamente y se aprenden de forma automática durante el entrenamiento, prescindir del volteo simplifica el código sin afectar en absoluto a la capacidad expresiva ni al rendimiento del modelo.
2.2 Desplazamiento del kernel sobre la matriz
El kernel se mueve sistemáticamente por toda la superficie de la imagen. La secuencia visual muestra cómo se colocan los pesos sobre la matriz de entrada, multiplicando cada valor de la selección por el número correspondiente del kernel y sumando el total para producir cada celda de salida:
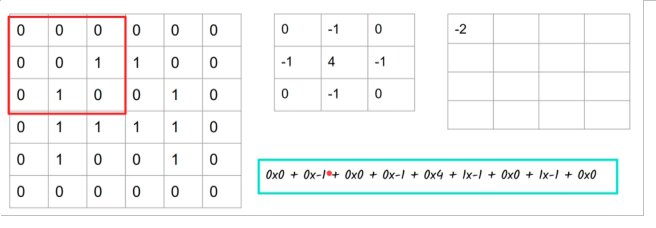
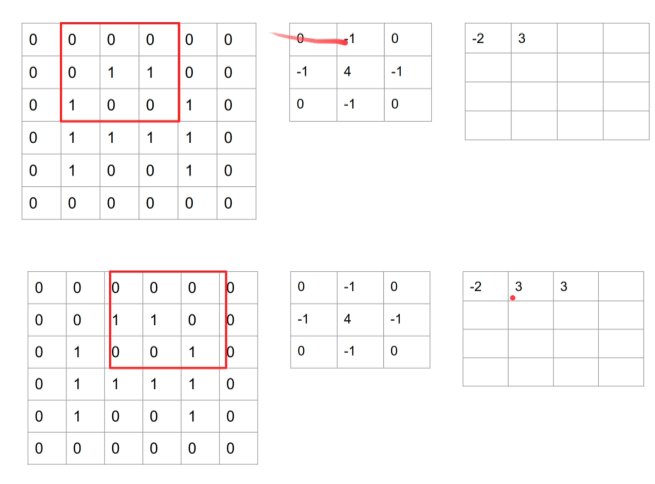
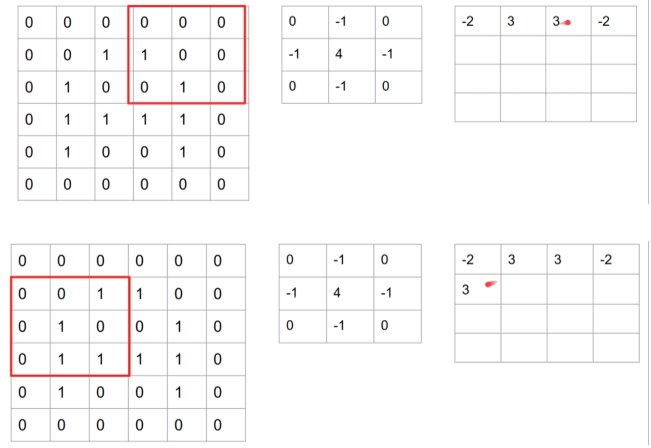
(a) 1. Primera posición: esquina superior izquierda
2.3 De los filtros clásicos (Sobel y Scharr) a los filtros aprendibles
En el ejemplo anterior utilizamos un filtro de detección de bordes verticales con valores positivos a la izquierda (\(+1\)) y negativos a la derecha (\(-1\)):
- Transición de claro a oscuro (borde positivo): Si la imagen pasa de valores altos de píxel (brillante, p. ej. 10) a valores bajos (oscuro, p. ej. 0), la convolución produce un valor positivo grande (\(+30\)).
- Transición de oscuro a claro (borde negativo): Si la imagen pasa de valores oscuros a claros (\(0 \to 10\)), el resultado será un valor negativo grande (\(-30\)).
- Para detectar la presencia del contorno sin importar el sentido de la luz, suele tomarse el valor absoluto del resultado.
Históricamente, en visión artificial clásica, los investigadores diseñaron manualmente matrices de pesos con propiedades matemáticas específicas:
- Filtro de Sobel (vertical): Concede el doble de peso a la fila central para ofrecer mayor robustez ante el ruido:
- Filtro de Scharr (vertical): Una variante con mayor precisión en la orientación del gradiente:
Al transponer o rotar estos filtros \(90^\circ\), se obtienen sus homólogos para la detección de bordes horizontales.
El gran cambio de paradigma en Deep Learning
En lugar de programar filtros artesanales como Sobel o Scharr, en las redes convolucionales los números de cada kernel son parámetros entrenables (\(w_{ij}\)). Mediante el algoritmo de retropropagación (backpropagation), la red aprende automáticamente los filtros más óptimos para cada tarea: detectores de bordes a \(45^\circ\), \(60^\circ\), combinaciones de colores, curvas o texturas complejas, superando ampliamente a los diseños manuales.
3 La analogía con las redes neuronales: pesos compartidos
¿Cómo se relaciona esta operación con las neuronas que hemos estudiado?
Cada celda del mapa de características no es más que una neurona artificial:
- Recibe como entradas un pequeño grupo local de píxeles (su campo receptivo o local receptive field).
- Multiplica esas entradas por unos pesos (\(w_{ij}\), los valores del kernel).
- Suma un término de sesgo (\(b\)).
- Aplica una función de activación no lineal, casi siempre ReLU (\(a = \max(0, z)\)).
La Figura 3 ilustra esta equivalencia: si “estiramos” la ventana \(3 \times 3\) de la imagen en un vector columna de 9 entradas, el cálculo de una celda del mapa de características es idéntico a una neurona tradicional. Cada posición del kernel (con su correspondiente color) actúa como el peso \(w\) que multiplica a su píxel de entrada, sumando el sesgo \(b\) (representado por el punto rojo).
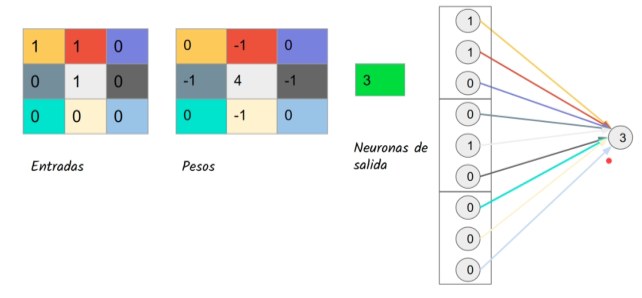
Figura 3: Equivalencia entre convolución 2D y neurona densa: la matriz de entrada 3×3 y el kernel de pesos se corresponden exactamente con una neurona clásica de 9 entradas ponderadas más sesgo.
La diferencia fundamental respecto a una red totalmente conectada radica en dos principios:
- Conexiones locales dispersas (sparse connectivity): En lugar de conectar cada neurona a todos los píxeles de la imagen, cada una solo se conecta a su vecindario local (\(3 \times 3 = 9\) píxeles).
- Pesos compartidos (weight sharing): Todas las neuronas del mismo mapa de características comparten exactamente el mismo kernel \(W\) y el mismo sesgo \(b\) (las mismas 9 flechas de colores se reutilizan al deslizar la ventana).
Esto significa que para procesar una imagen de cualquier tamaño con un filtro \(3 \times 3\), solo necesitamos aprender \(3 \times 3 + 1 = 10\) parámetros (9 pesos y 1 sesgo)
4 Hiperparámetros de la convolución: Padding y Stride
Al aplicar una convolución surgen dos cuestiones prácticas:
- La imagen resultante se reduce de tamaño (una entrada \(6 \times 6\) con kernel \(3 \times 3\) genera una salida \(4 \times 4\)).
- Los píxeles de las esquinas y bordes se utilizan menos veces que los centrales, perdiendo información periférica.
Para controlar esto utilizamos dos hiperparámetros: Padding y Stride.
4.1 Padding (\(P\))
El padding consiste en rodear la imagen de entrada con un marco de filas y columnas de ceros (zero-padding).
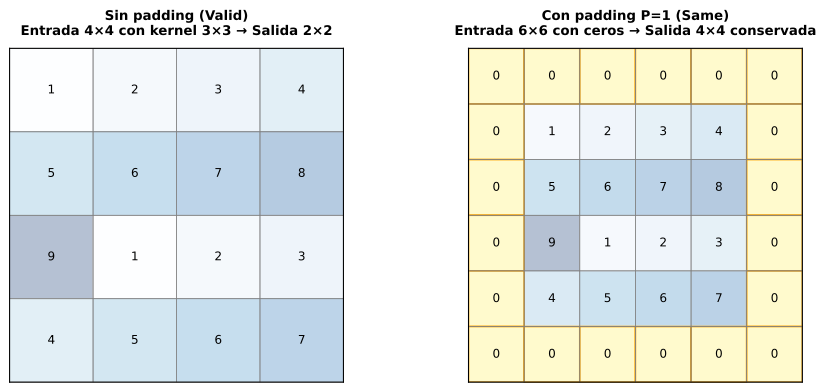
Figura 4: Comparativa de Padding: Sin padding (izquierda), la imagen se reduce. Con padding P=1 (derecha, marco amarillo de ceros), la salida conserva exactamente el tamaño original 4×4.
Distinguimos dos modos habituales:
- Valid: \(P = 0\). No se añade ningún relleno; la salida encoge en cada capa.
- Same: Se eligen suficientes ceros para que la salida tenga exactamente el mismo tamaño espacial que la entrada. Para un kernel impar de tamaño \(K\), el padding necesario es:
(Por ejemplo, para un kernel \(3 \times 3\), \(P = 1\); para \(5 \times 5\), \(P = 2\); para \(7 \times 7\), \(P = 3\)).
¿Por qué se utilizan casi siempre filtros de tamaño impar?
En la literatura de visión por computadora y aprendizaje profundo, es una convención prácticamente universal utilizar kernels de dimensiones impares (\(1\times1, 3\times3, 5\times5, 7\times7\)). Existen dos razones principales:
- Relleno simétrico perfecto: Si \(K\) es impar, la expresión \(P = \frac{K - 1}{2}\) da siempre un número entero exacto, permitiendo añadir exactamente el mismo número de ceros arriba, abajo, a la izquierda y a la derecha. Con un kernel par (p. ej., \(4 \times 4\)), tendríamos que añadir un padding asimétrico (\(1\) píxel por un lado y \(2\) por otro), rompiendo la simetría espacial.
- Píxel central bien definido: Un filtro de dimensión impar cuenta con una celda central unívoca \(\left(\frac{K+1}{2}, \frac{K+1}{2}\right)\). Esto permite anclar conceptualmente la salida convolucional a la posición exacta del píxel sobre el que está centrado el campo receptivo.
4.2 Stride (\(S\))
El stride (o paso) es el número de píxeles que se desplaza el kernel en cada salto:
- Stride = 1: el kernel avanza de 1 en 1 píxel (máxima resolución espacial).
- Stride = 2: el kernel salta de 2 en 2 píxeles, reduciendo el tamaño de la salida aproximadamente a la mitad.
4.3 Fórmula general de dimensiones
Si la entrada mide \(n_{\text{entrada}} \times n_{\text{entrada}}\), el kernel mide \(K \times K\), se usa un padding \(P\) y un stride \(S\), el tamaño de la matriz de salida \(n_{\text{salida}}\) es:
donde \(\lfloor \cdot \rfloor\) denota la función suelo (redondeo hacia abajo).
Comprobación con nuestro ejemplo inicial
Para una entrada de \(n=6\), kernel \(K=3\), sin padding (\(P=0\)) y paso \(S=1\):
Obtenemos exactamente la matriz de \(4 \times 4\).
5 Convolución sobre múltiples canales (Imágenes en color RGB)
Las fotografías reales suelen tener 3 canales de color (Rojo, Verde, Azul). Por tanto, la entrada no es una matriz plana, sino un volumen tridimensional de dimensiones \(H \times W \times C_{\text{in}}\), donde \(C_{\text{in}} = 3\).
Para realizar la convolución sobre una entrada multicanal, el kernel debe tener exactamente la misma profundidad de canales: su tamaño será \(K \times K \times C_{\text{in}}\) (por ejemplo, \(3 \times 3 \times 3 = 27\) pesos para un filtro \(3 \times 3\) sobre RGB).
¿Cómo se realiza el cálculo?
- Cada una de las matrices del filtro (\(K_{\text{R}}, K_{\text{G}}, K_{\text{B}}\)) opera sobre su canal correspondiente de la imagen (\(X_{\text{R}}, X_{\text{G}}, X_{\text{B}}\)).
- Se calculan las 3 convoluciones 2D independientes canal por canal.
- Se suman elemento a elemento los resultados de los 3 canales y se añade un único sesgo escalar \(b\).
El resultado de aplicar un filtro 3D completo es un único mapa de características bidimensional (\(H_{\text{out}} \times W_{\text{out}}\)), como ilustra la Figura 5.
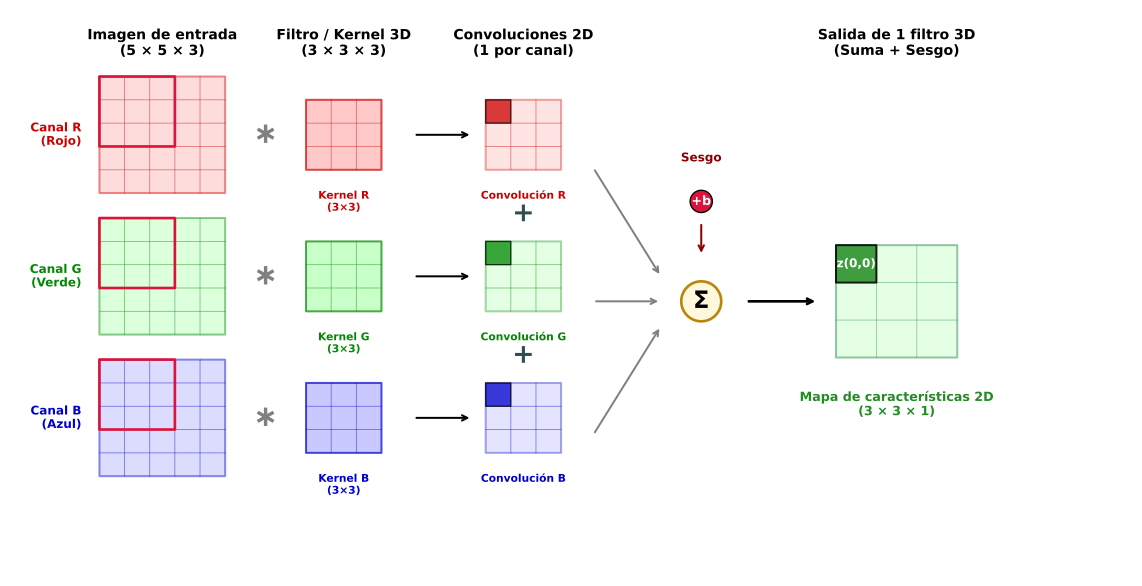
Figura 5: Convolución sobre una imagen RGB (3 canales): el kernel 3D tiene una matriz de pesos para cada canal (R, G, B). Cada canal se convoluciona por separado; luego se suman los 3 mapas resultantes celda a celda y se añade el sesgo b para producir un único mapa de características 2D.
6 Múltiples kernels: la profundidad de salida
Un solo filtro solo puede detectar un tipo específico de rasgo (por ejemplo, bordes verticales). Para que la red capture bordes horizontales, diagonales, curvas y combinaciones de colores simultáneamente, necesitamos aplicar múltiples kernels independientes.
Si tenemos una entrada multicanal y aplicamos dos kernels distintos (como muestra la Figura 6):
- El Kernel 1 (en naranja, detector de bordes verticales) opera sobre los 3 canales de entrada y suma sus resultados para generar el Mapa 1 (\(3 \times 3\)).
- El Kernel 2 (en verde azulado, detector de bordes horizontales) opera independientemente sobre los 3 canales de entrada y genera el Mapa 2 (\(3 \times 3\)).
- Ambos mapas 2D se apilan a lo largo del eje de profundidad, formando un volumen de salida 3D de dimensiones \(3 \times 3 \times 2\).
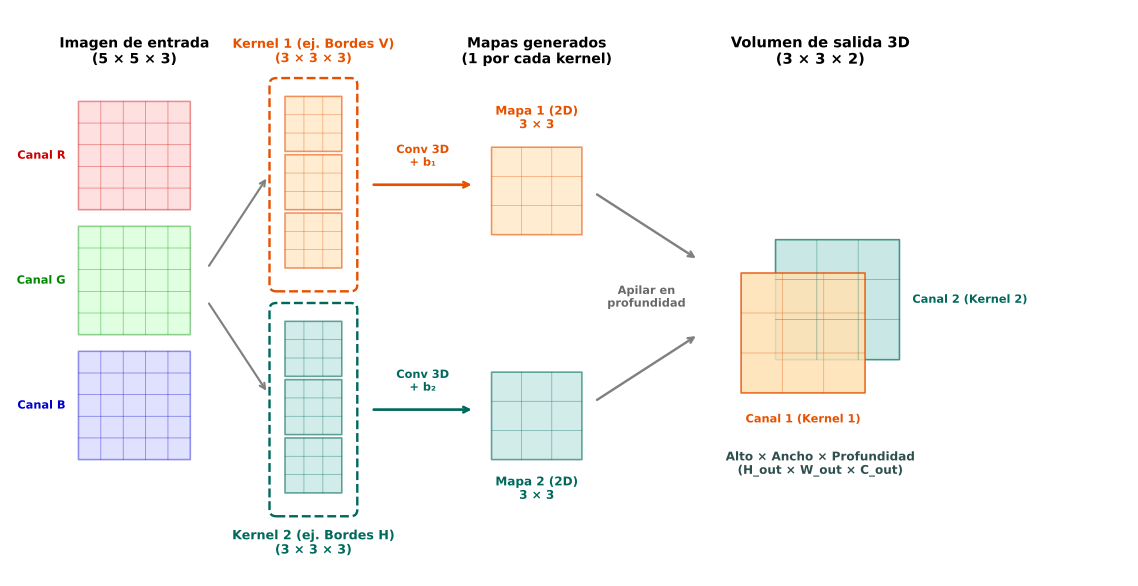
Figura 6: Múltiples kernels y volumen de salida: cada kernel 3D independiente (Kernel 1 y Kernel 2) procesa la totalidad de los canales de entrada y produce un mapa de características 2D. Al apilarlos en profundidad, la salida de la capa convolucional se convierte en un volumen 3D con tantos canales como kernels hayamos utilizado.
6.1 Conteo de parámetros en una capa convolucional
Calcular el número exacto de parámetros entrenables de una capa convolucional es directo a partir de las dimensiones anteriores.
Supongamos que una capa convolucional recibe una entrada RGB (\(C_{\text{in}} = 3\)) y aplica \(C_{\text{out}} = 10\) filtros de tamaño \(3 \times 3\):
- Pesos por filtro: Cada filtro tiene \(3 \times 3 \times 3 = 27\) pesos.
- Sesgo por filtro: Cada filtro añade \(1\) sesgo escalar (\(b\)).
- Total por filtro: \(27 + 1 = 28\) parámetros entrenables.
- Total de la capa (\(10\) filtros):
Independencia del tamaño de la imagen
Fíjate en una propiedad fundamental: el número de parámetros de la capa (280) no depende en absoluto del tamaño de la imagen de entrada (\(H \times W\)). Ya sea una foto pequeña de \(32 \times 32\) píxeles o una imagen médica de alta resolución de \(4000 \times 4000\) píxeles, la capa convolucional solo necesita aprender exactamente 280 números. Esto explica por qué las CNNs escalan a imágenes gigantescas sin sufrir la explosión combinatoria de parámetros de los MLP.
7 Capas de agrupación: Pooling
Tras una capa convolucional y su función de activación ReLU, es habitual intercalar una capa de pooling (o submuestreo). Su propósito es:
- Reducir la resolución espacial (\(H\) y \(W\)), disminuyendo la carga computacional y el número de parámetros de las capas posteriores.
- Aportar invarianza ante pequeñas deformaciones: si un rasgo se desplaza uno o dos píxeles, la salida del pooling sigue siendo prácticamente la misma.
La variante más común es el Max Pooling con ventana \(2 \times 2\) y stride \(S=2\): divide la matriz en bloques de \(2 \times 2\) no solapados y se queda únicamente con el valor máximo de cada bloque.
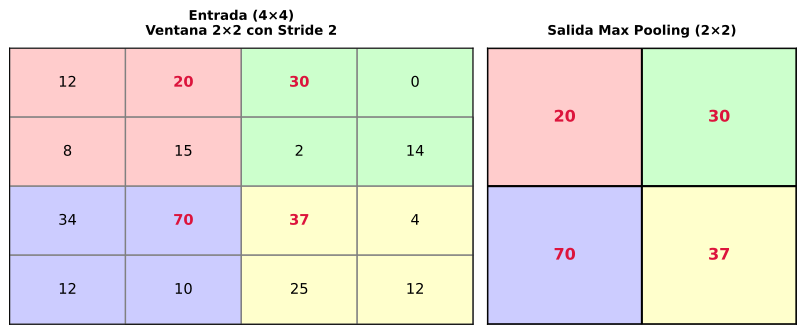
Figura 7: Max Pooling con ventana 2×2 y Stride 2: divide la matriz 4×4 en cuatro cuadrantes de 2×2 y selecciona el valor máximo de cada uno (en rojo), reduciendo las dimensiones espaciales a 2×2 sin añadir ningún parámetro entrenable.
El pooling no tiene pesos entrenables
A diferencia de las capas convolucionales o densas, una capa de pooling no tiene parámetros que aprender (\(W\) ni \(b\)). Es una operación de agregación puramente determinista que se aplica canal por canal de forma independiente, conservando intacto el número de canales \(C\).
7.1 Tipos de Pooling: Max Pooling vs. Average Pooling
Aunque el Max Pooling es la opción más extendida hoy en día, existen dos variantes importantes:
- Max Pooling: Toma el valor máximo del bloque. La intuición detrás de esta elección es que las magnitudes altas en los mapas de características corresponden a la detección nítida de un patrón o rasgo (por ejemplo, un borde o una curvatura). Al quedarse con el máximo, la red retiene la señal del rasgo independientemente de dónde haya caído exactamente dentro del bloque de \(2 \times 2\).
- Average Pooling (Pooling promedio): Calcula la media aritmética de todos los valores de la región. Fue muy utilizado en las primeras arquitecturas históricas (como LeNet-5), aunque en capas intermedias ha sido sustituido en gran medida por Max Pooling por su menor capacidad para resaltar rasgos prominentes.
- Global Average Pooling (GAP): Una variante moderna fundamental donde el tamaño de la ventana coincide exactamente con las dimensiones espaciales completas de la entrada (\(H \times W\)). En lugar de producir un mapa más pequeño, calcula un único promedio escalar para cada canal, colapsando un volumen de dimensiones \(H \times W \times C\) directamente en un vector unidimensional \(1 \times 1 \times C\). Arquitecturas modernas como ResNet utilizan GAP al final de la red en sustitución de la capa de aplanado (Flatten) y de las capas densas intermedias, reduciendo drásticamente los millones de parámetros que estas últimas requerían.
8 Arquitectura completa de una CNN
En una red convolucional típica para clasificación de imágenes, apilamos de forma secuencial:
- Bloques Convolución + Activación (ReLU) para extraer mapas de características.
- Capas de Pooling para reducir el tamaño espacial progresivamente.
- Aplanado (Flatten): El volumen final 3D (por ejemplo, \(6 \times 6 \times 32 = 1152\) valores) se aplana en un vector 1D.
- Capas Densas (MLP): Una o dos capas totalmente conectadas que combinan los patrones globales detectados.
- Capa de Salida: Una función Softmax (para multiclase) o Sigmoide (para clasificación binaria).
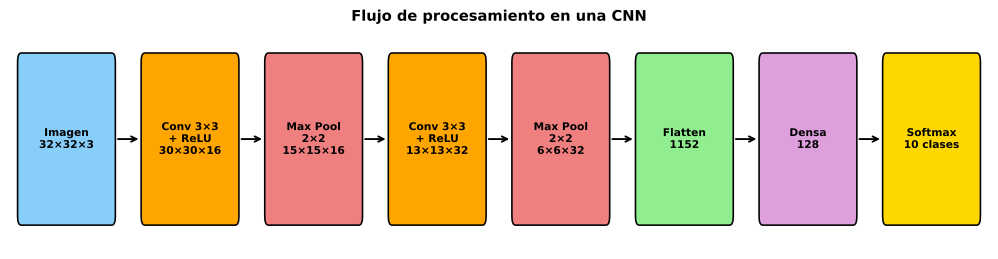
Figura 8: Flujo típico de una Red Neuronal Convolucional (CNN): las capas convolucionales y de pooling extraen representaciones visuales jerárquicas; la capa de aplanado (Flatten) conecta el volumen con capas densas para emitir las probabilidades finales mediante Softmax.
A medida que avanzamos en profundidad por la red:
- Las primeras capas convolucionales detectan rasgos simples y locales de bajo nivel: bordes, líneas orientadas y gradientes de color.
- Las capas intermedias combinan esos bordes para detectar texturas, curvas y partes de objetos (ojos, ruedas, esquinas).
- Las capas finales forman conceptos semánticos de alto nivel: caras completas, coches, animales o números.
9 Intuición de la retropropagación en CNNs
Cálculo matemático completo paso a paso
Para ver el desarrollo numérico manual exhaustivo con matrices reales, derivación celda a celda de \(\frac{\partial J}{\partial W}\) y \(\frac{\partial J}{\partial b}\), y su verificación numérica con gradient checking, consulta el capítulo complementario: Matemáticas y Backpropagation de la Capa Convolucional.
En el capítulo de Backpropagation vimos cómo el error se propaga hacia atrás mediante la regla de la cadena para calcular \(\frac{\partial L}{\partial w}\) y \(\frac{\partial L}{\partial b}\). En una capa convolucional el principio es idéntico, con una consideración especial debida a los pesos compartidos.
9.1 Gradiente respecto a los pesos del kernel (\(\partial L / \partial W\))
Recordemos que en una red densa la derivada respecto a un peso que conecta una entrada \(a_i\) con una neurona \(z_j\) es simplemente:
¿Qué ocurre cuando un mismo peso \(w\) se comparte y afecta a múltiples neuronas de salida? La Figura 9 ilustra el principio con el caso elemental de dos neuronas: si el peso \(w\) conecta la entrada \(a_1\) con \(a_3\) y, al mismo tiempo, conecta \(a_2\) con \(a_4\), cualquier cambio en \(w\) impactará en el coste global \(J\) (o pérdida \(L\)) a través de dos caminos distintos.
Por la regla de la cadena multivariable del cálculo diferencial, el gradiente total es la suma de las derivadas parciales de cada camino:
Como sabemos que \(\delta_k = \frac{\partial L}{\partial z_k} = \frac{\partial a_k}{\partial z_k} \cdot \frac{\partial L}{\partial a_k}\) y que \(\frac{\partial z_k}{\partial w} = a_{\text{entrada}}\), la expresión queda:
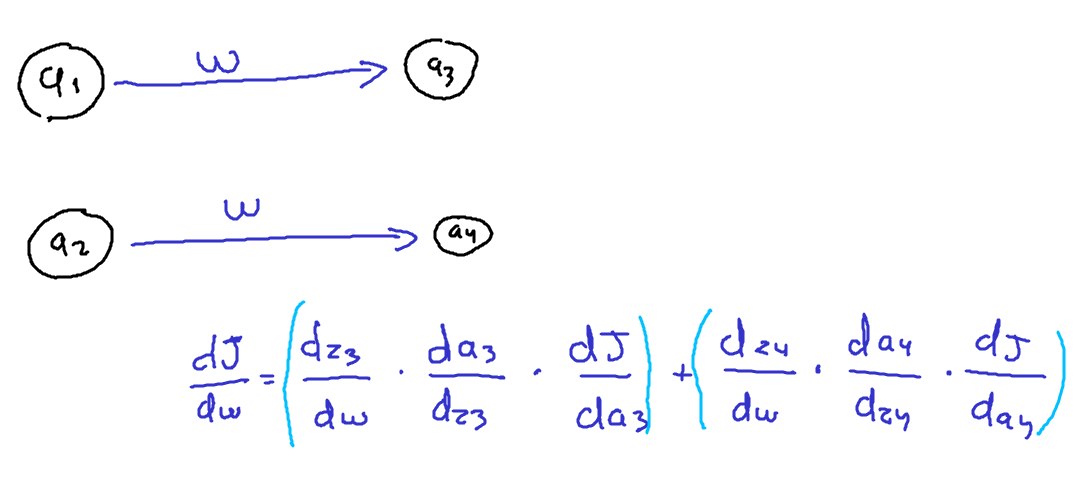 \(w\) influye en múltiples salidas ( \(a_3\) y \(a_4\) ), la derivada del error total respecto a \(w\) es la suma de las contribuciones de todos los caminos afectados." />
Figura 9: Regla de la cadena con pesos compartidos: cuando un mismo peso \(w\) influye en múltiples salidas ( \(a_3\) y \(a_4\) ), la derivada del error total respecto a \(w\) es la suma de las contribuciones de todos los caminos afectados.
En una capa convolucional completa, el mismo peso \(w_{ij}\) del kernel se utiliza repetidamente en todas las posiciones \((p,q)\) del mapa de características. Generalizando esta suma a toda la matriz:
donde \(\delta_{p,q} = \frac{\partial L}{\partial z_{p,q}}\) es la sensibilidad al error de la neurona \((p,q)\) en el mapa de características, y \(x\) es el píxel de entrada sobre el que operó dicho peso.
La derivada respecto a los pesos es otra convolución
Matemáticamente, calcular \(\frac{\partial L}{\partial W}\) equivale exactamente a hacer la convolución entre la imagen de entrada \(X\) y la matriz de errores \(\delta\).
9.2 Gradiente respecto al sesgo (\(\partial L / \partial b\))
Como todas las neuronas del mapa comparten el mismo sesgo escalar \(b\), su gradiente es simplemente la suma de todos los deltas de ese mapa:
9.3 Propagación del error hacia la capa anterior (\(\delta_{\text{entrada}}\))
Para pasar la señal de error a la capa previa, cada neurona de la entrada recibe las contribuciones de todos los deltas posteriores ponderados por los pesos del kernel que la cubrieron. Esto equivale formalmente a realizar una convolución de la matriz de deltas \(\delta\) con el kernel rotado \(180^\circ\) (la operación transpuesta de la convolución).
10 Comparativa: Red Densa (MLP) vs Red Convolucional (CNN)
| Característica | Red Densa (MLP) | Red Convolucional (CNN) |
|---|---|---|
| Estructura de entrada | Vector 1D aplanado | Matriz 2D o Volumen 3D (\(H \times W \times C\)) |
| Conexiones | Globales (todos con todos) | Locales (campos receptivos pequeños) |
| Parámetros | Millones (proporcional al tamaño de imagen) | Muy reducidos (pesos compartidos en kernels) |
| Invarianza espacial | Muy sensible a la posición del objeto | Invariante ante traslaciones espaciales |
| Dominio principal | Datos tabulares, características numéricas | Imágenes, visión artificial, audio espectrogramas |
Siguiente paso: Grandes arquitecturas
Tras comprender la base de las CNNs y el ejemplo pionero de LeNet-5, explora cómo la comunidad científica evolucionó estos conceptos hacia modelos profundos modernos en Arquitecturas clásicas y modernas de CNN (AlexNet, VGG, ResNet, Inception y MobileNet).