Reconocimiento Facial, Redes Siamesas y Triplet Loss
Navegación en esta sección
Capítulos anteriores del bloque de Visión Artificial: 1. Redes neuronales convolucionales (CNN) — convolución, padding, pooling y LeNet-5. 2. Matemáticas de la capa convolucional — cálculo manual y backpropagation. 3. Arquitecturas clásicas y modernas de CNN — AlexNet, VGG, ResNet, Inception y MobileNet. 4. Práctica en Visión Artificial — Transfer Learning y Data Augmentation. 5. Detección de Objetos y YOLO — localización con cuadros delimitadores. 6. Segmentación Semántica y U-Net — clasificación píxel a píxel.
Estás en Reconocimiento Facial y Redes Siamesas (One-Shot Learning, embeddings métricos, Triplet Loss y verificación facial).
1 Verificación Facial vs. Reconocimiento Facial
En los sistemas biométricos modernos (como el desbloqueo de smartphones, el control de accesos corporativos o los pasaportes electrónicos), es fundamental distinguir dos problemas con niveles de dificultad muy distintos:
- Verificación Facial (Face Verification): Problema uno a uno (\(1:1\)).
- El sistema recibe una imagen de entrada y una identidad declarada (un nombre o tarjeta de identificación).
- Su objetivo es responder a la pregunta: «¿Es esta persona quien dice ser?».
- Reconocimiento Facial (Face Recognition): Problema uno a muchos (\(1:N\)).
- El sistema recibe una imagen de entrada sin ninguna identidad previa y debe compararla contra una base de datos de \(K\) personas registradas.
- Su objetivo es responder a la pregunta: «¿Quién de las \(K\) personas registradas es esta persona (o es un desconocido)?».
1.1 El desafío estadístico del reconocimiento (\(1:N\))
Si un algoritmo de verificación tiene una tasa de acierto del \(99\%\) (un \(1\%\) de error de falso positivo por comparación), al utilizarlo en un sistema de reconocimiento con una base de datos de \(K = 100\) empleados:
¡El sistema fallará más de la mitad de las veces! Por esta razón, el reconocimiento facial exige funciones de similitud con precisiones extraordinariamente altas (\(> 99.9\%\)).
2 El problema del One-Shot Learning y el fracaso de Softmax
En la mayoría de aplicaciones de reconocimiento facial, nos enfrentamos al aprendizaje con una sola muestra (One-Shot Learning): el sistema debe ser capaz de reconocer con fiabilidad a un empleado habiendo visto únicamente una sola fotografía de su rostro (por ejemplo, la foto de su carnet de empleado).
2.1 ¿Por qué falla una red convolucional tradicional con Softmax?
Si intentáramos entrenar una CNN clásica con una capa Softmax de \(K\) neuronas (una para cada empleado de la empresa):
- Escasez extrema de datos: Entrenar una red convolucional con una sola imagen por persona provoca un sobreajuste (overfitting) inmediato; la red no aprenderá a generalizar variaciones de luz, peinado, ángulo o expresión.
- Inviabilidad de escalabilidad: Cada vez que un nuevo empleado se incorpora a la empresa, tendríamos que añadir una nueva neurona a la capa Softmax y reentrenar toda la red neuronal desde cero.
2.2 El cambio de paradigma: Aprendizaje Métrico (Metric Learning)
Para resolver el problema, abandonamos la clasificación directa y entrenamos la red para que aprenda una función de similitud métrica \(d(x_1, x_2)\):
- Si \(x_1\) y \(x_2\) son fotos de la misma persona \(\implies d(x_1, x_2)\) debe ser un número pequeño.
- Si \(x_1\) y \(x_2\) son fotos de personas distintas \(\implies d(x_1, x_2)\) debe ser un número grande.
Para verificar una identidad, comparamos la foto capturada con la foto registrada en la base de datos: si \(d(x_{\text{captura}}, x_{\text{registro}}) \le \tau\) (donde \(\tau\) es un umbral predeterminado), el acceso se concede. Si se añade un empleado nuevo, basta con almacenar su foto en la base de datos sin necesidad de reentrenar la red.
3 Redes Siamesas (Siamese Networks) y Embeddings Faciales
La arquitectura por excelencia para aprender esta función de distancia es la Red Siamesa (Taigman et al., DeepFace, 2014; Schroff et al., FaceNet, 2015).
Una red siamesa consta de dos ramas convolucionales idénticas que comparten exactamente los mismos pesos y parámetros \(W\):
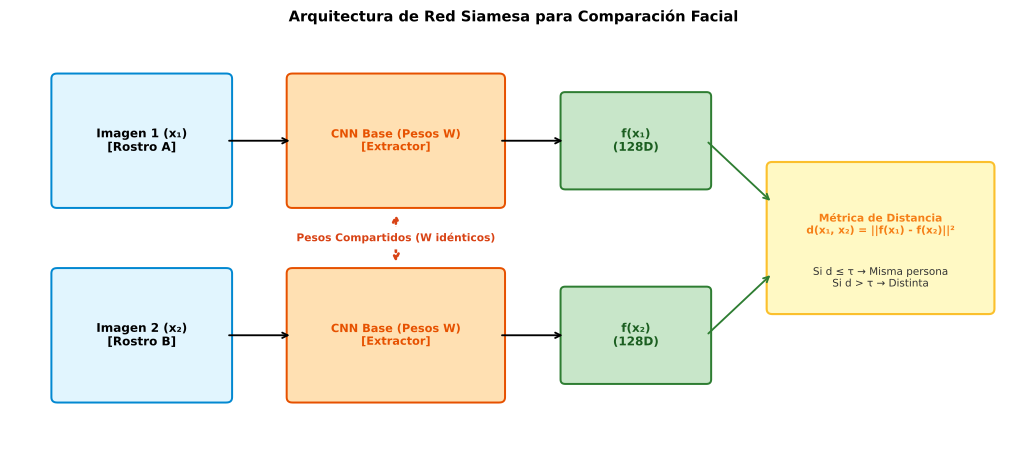
Figura 1: Arquitectura de Red Siamesa: dos imágenes (x₁ y x₂) se procesan por la misma CNN con pesos compartidos W para producir dos vectores densos de embedding f(x₁) y f(x₂) de 128 dimensiones. La distancia euclídea d(x₁, x₂) mide su grado de discrepancia.
3.1 Mecánica de los Embeddings
- La red convolucional procesa la imagen \(x\) y se detiene en su última capa densa, emitiendo un vector de características unidimensional de baja dimensión:
- Este vector \(f(x)\) se normaliza en la hiperesfera unitaria (\(\|f(x)\|_2 = 1\)), condensando los rasgos faciales invariantes (proporción entre ojos, forma de la nariz, mandíbula) en un embedding facial de 128 números.
- La distancia entre dos rostros se calcula como el cuadrado de la norma euclídea (\(L_2\)):
Optimización en producción: Pre-cálculo de embeddings
En un torno de acceso con 1.000 empleados, los vectores \(f(x_{\text{empleado}})\) de los 1.000 trabajadores se calculan una sola vez y se almacenan en una base de datos vectorial.
Cuando una persona se coloca frente a la cámara: 1. La CNN se ejecuta una sola vez sobre el nuevo rostro para generar su embedding de 128 números. 2. La comparación contra los 1.000 empleados se reduce a 1.000 restas vectoriales en memoria RAM, completándose en menos de 1 milisegundo (\(O(1)\)).
4 La Pérdida de Triplete (Triplet Loss)
Para entrenar la red siamesa de modo que aprenda embeddings compactos para la misma persona y separados para personas diferentes, FaceNet (Schroff et al., 2015) introdujo la función de pérdida de triplete (Triplet Loss).
El entrenamiento opera sobre grupos de tres imágenes simultáneas:
- Ancla (\(A\), Anchor): Fotografía base de una persona determinada.
- Positivo (\(P\), Positive): Otra fotografía distinta de la misma persona que el ancla.
- Negativo (\(N\), Negative): Fotografía de una persona diferente a la del ancla.
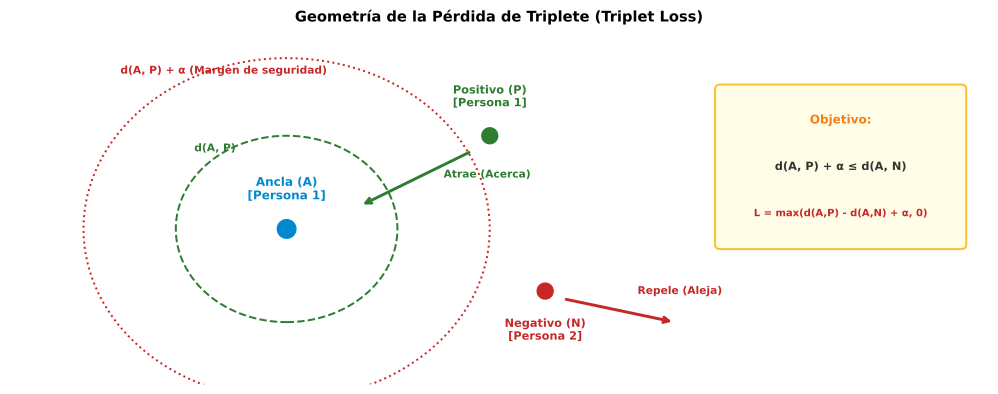
Figura 2: Geometría de la Pérdida de Triplete: el entrenamiento atrae el embedding positivo P hacia el ancla A y repele el negativo N más allá del margen de seguridad α.
4.1 Formulación matemática y el rol del margen \(\alpha\)
Queremos que la distancia entre el ancla y el positivo sea menor que la distancia entre el ancla y el negativo por al menos un margen de separación \(\alpha > 0\):
La función de pérdida para un triplete individual \((A, P, N)\) se define como:
¿Por qué es indispensable el margen α?
Si fijáramos \(\alpha = 0\), la red podría minimizar la pérdida fácilmente aprendiendo una solución trivial constante: emitir \(f(x) = \mathbf{0}\) para todas las imágenes del mundo. En ese caso:
La pérdida sería \(0\) pero la red no aprendería a distinguir ningún rostro. El margen \(\alpha\) (típicamente \(\alpha = 0.2\)) fuerza a la red a separar físicamente los grupos en el espacio latente.
4.2 Minería de Tripletes Difíciles (Hard Triplets Mining)
Si elegimos los tripletes \((A, P, N)\) de forma puramente aleatoria en el dataset, dos personas al azar (\(A\) y \(N\)) serán tan diferentes que naturalmente \(d(A, N) \gg d(A, P) + \alpha\). En esos casos, la pérdida será \(\mathcal{L} = 0\), los gradientes serán nulos y la red no aprenderá nada.
Para entrenar con máxima eficiencia, seleccionamos tripletes difíciles (Hard Triplets):
- Tripletes difíciles (Hard): \(d(A, N) < d(A, P)\) (el impostor está más cerca del ancla que la foto real de la misma persona).
- Tripletes semi-difíciles (Semi-Hard): \(d(A, P) < d(A, N) < d(A, P) + \alpha\) (el negativo está correctamente más lejos que el positivo, pero dentro del margen de seguridad \(\alpha\)).
5 Alternativa: Red Siamesa con Regresión Logística Binaria
En lugar de entrenar con tripletes, otra formulación popular consiste en plantear el reconocimiento facial como un problema de clasificación binaria sobre pares de imágenes:
- Alimentamos dos imágenes \((x_1, x_2)\) a la red siamesa para obtener sus embeddings \(f(x_1)\) y \(f(x_2)\).
- Calculamos el vector de diferencias absolutas elemento a elemento:
- Pasamos este vector de 128 diferencias a una neurona con activación Sigmoide:
- Entrenamos con la función de coste de Entropía Cruzada Binaria:
- \(y = 1\) si \(x_1\) y \(x_2\) son la misma persona (par positivo).
- \(y = 0\) si \(x_1\) y \(x_2\) son personas diferentes (par negativo).
6 Detección de Vitalidad (Liveness Detection) y Anti-Spoofing
Un sistema de reconocimiento facial en producción es vulnerable a ataques de presentación (Presentation Attacks / Spoofing), donde un atacante intenta suplantar una identidad utilizando: - Una fotografía impresa en papel o tarjeta. - La pantalla de un smartphone o tablet mostrando la foto de la víctima. - Una máscara 3D de silicona.
Para mitigar estos fraudes, los sistemas profesionales incorporan módulos de detección de vitalidad (Liveness Detection):
- Pruebas de vitalidad activa: Pedir al usuario que realice una acción aleatoria e interactiva (parpadear dos veces, sonreír o girar la cabeza).
- Análisis pasivo de textura y micro-reflejos: Redes convolucionales auxiliares entrenadas para detectar el brillo especular de pantallas de móvil, el patrón de impresión de tinta o la falta de micro-movimientos involuntarios.
- Sensores de profundidad e infrarrojos: Sensores 3D (como Face ID con proyector de puntos infrarrojos y cámara TrueDepth) que reconstruyen la geometría tridimensional del rostro, invalidando cualquier fotografía plana 2D.
7 Código interactivo en Python: Triplet Loss y Verificación de Embeddings
El siguiente script en Python implementa la función matemática de Triplet Loss y simula la verificación de identidades mediante distancia euclídea:
import numpy as np

# 1. Implementación de Triplet Loss
def triplet_loss(y_true, y_pred, alpha=0.2):
    """
    y_pred: tupla (anchor, positive, negative) cada uno de dimensión (N, 128)
    alpha: margen de separación
    """
    anchor, positive, negative = y_pred

    # Distancia euclídea al cuadrado ||f(A) - f(P)||^2
    d_pos = np.sum(np.square(anchor - positive), axis=-1)

    # Distancia euclídea al cuadrado ||f(A) - f(N)||^2
    d_neg = np.sum(np.square(anchor - negative), axis=-1)

    # Pérdida con margen
    loss = np.maximum(d_pos - d_neg + alpha, 0.0)
    return np.mean(loss), d_pos, d_neg

# Generamos embeddings sintéticos normalizados (3 muestras)
np.random.seed(42)
def generate_normalized_embedding():
    v = np.random.randn(1, 128)
    return v / np.linalg.norm(v)

# Persona 1: Ancla y Positivo (muy similares con ruido leve)
emb_A = generate_normalized_embedding()
emb_P = emb_A + np.random.randn(1, 128) * 0.05
emb_P = emb_P / np.linalg.norm(emb_P)

# Persona 2: Negativo (vector aleatorio diferente)
emb_N = generate_normalized_embedding()

loss_val, d_pos, d_neg = triplet_loss(None, (emb_A, emb_P, emb_N), alpha=0.2)

print("=" * 60)
print("1. EVALUACIÓN DE TRIPLET LOSS")
print("=" * 60)
print(f"Distancia Misma Persona d(A, P):  {d_pos[0]:.4f}")
print(f"Distancia Distinta Persona d(A, N): {d_neg[0]:.4f}")
print(f"Pérdida de Triplete (alpha=0.2):   {loss_val:.4f}\n")

# 2. Simulación de Verificación Facial con Umbral tau
tau = 0.5
print("=" * 60)
print("2. VERIFICACIÓN FACIAL CON UMBRAL τ = 0.5")
print("=" * 60)
print(f"¿Acceso concedido a Persona 1 (Positivo)? -> {d_pos[0] < tau} (d = {d_pos[0]:.4f} <= {tau})")
print(f"¿Acceso concedido a Persona 2 (Impostor)? -> {d_neg[0] < tau} (d = {d_neg[0]:.4f} <= {tau})")
============================================================
1. EVALUACIÓN DE TRIPLET LOSS
============================================================
Distancia Misma Persona d(A, P):  0.2528
Distancia Distinta Persona d(A, N): 1.9423
Pérdida de Triplete (alpha=0.2):   0.0000

============================================================
2. VERIFICACIÓN FACIAL CON UMBRAL τ = 0.5
============================================================
¿Acceso concedido a Persona 1 (Positivo)? -> True (d = 0.2528 <= 0.5)
¿Acceso concedido a Persona 2 (Impostor)? -> False (d = 1.9423 <= 0.5)
Siguiente paso: Creatividad y dimensiones superiores
Descubre cómo utilizar redes convolucionales para crear arte digital y procesar señales temporales y médicas en Transferencia de Estilo Neuronal (NST) y Convoluciones 1D/3D.