K-Vecinos más Cercanos (KNN)
1 Introducción
Muchos algoritmos (regresión logística, árboles de decisión, bosques aleatorios) construyen un modelo, esto es, a partir de los datos de entrenamiento aprenden un conjunto de parámetros (pesos, reglas, árboles) y luego descartan los datos originales. El modelo es una compresión de la experiencia pasada.
El algoritmo de los k-vecinos más cercanos (k-nearest neighbors, KNN) funciona de forma distinta: no construye nada durante el entrenamiento. Simplemente memoriza todos los ejemplos. Por eso se dice que es un método perezoso (lazy learning) o basado en instancias.
La intuición: si quieres saber si un correo es spam, comparas con los correos más parecidos que ya conoces. En KNN la predicción para un nuevo punto \(x\) se basa en los \(k\) ejemplos de entrenamiento más cercanos a \(x\):
- En clasificación: se predice la clase mayoritaria entre los \(k\) vecinos (votación).
- En regresión: se predice la media de los valores de esos \(k\) vecinos.
El único trabajo real del algoritmo es definir qué significa “cercano”, es decir, elegir una distancia.
2 La distancia lo es todo
Para medir qué tan cerca está un punto \(x\) de otro \(z\), lo más habitual es la distancia euclídea:
Esta es solo un caso particular de la distancia de Minkowski de orden \(p\):
- \(p = 2\): distancia euclídea (la del teorema de Pitágoras).
- \(p = 1\): distancia de Manhattan (suma de diferencias absolutas).
- \(p \to \infty\): distancia de Chebyshev (la mayor diferencia en una sola coordenada).
Importante
Como KNN decide por distancias, la escala de cada variable importa muchísimo. Si una variable vive en el rango \([0, 1000]\) y otra en \([0, 1]\), la primera dominará la distancia casi por completo, aunque la segunda sea la relevante. Por eso, antes de usar KNN, es casi obligatorio estandarizar las variables (por ejemplo, con StandardScaler).
3 Ejemplo numérico: calcular a mano la predicción
Supongamos que ya conocemos 5 ejemplos en dos dimensiones, con su etiqueta (\(0\) o \(1\)):
| Ejemplo | \(x_1\) | \(x_2\) | Etiqueta |
|---|---|---|---|
| A | 1.0 | 1.0 | 0 |
| B | 2.0 | 2.0 | 0 |
| C | 5.0 | 5.0 | 1 |
| D | 6.0 | 4.0 | 1 |
| E | 1.5 | 4.0 | 0 |
Queremos predecir la etiqueta del nuevo punto de consulta \(Q = (4.0, 3.5)\). Calculamos su distancia euclídea a cada ejemplo:
| Ejemplo | Cálculo de la distancia | Distancia | Etiqueta |
|---|---|---|---|
| A | \(\sqrt{(4-1)^2 + (3.5-1)^2} = \sqrt{15.25}\) | 3.91 | 0 |
| B | \(\sqrt{(4-2)^2 + (3.5-2)^2} = \sqrt{6.25}\) | 2.50 | 0 |
| C | \(\sqrt{(4-5)^2 + (3.5-5)^2} = \sqrt{3.25}\) | 1.80 | 1 |
| D | \(\sqrt{(4-6)^2 + (3.5-4)^2} = \sqrt{4.25}\) | 2.06 | 1 |
| E | \(\sqrt{(4-1.5)^2 + (3.5-4)^2} = \sqrt{6.50}\) | 2.55 | 0 |
Ordenados de menor a mayor distancia: C (1.80), D (2.06), B (2.50), E (2.55), A (3.91).
- Con \(k = 3\), miramos los tres más cercanos: C (1), D (1), B (0). Hay dos votos para la clase 1, así que KNN predice 1.
- Con \(k = 5\), usamos todos: a los anteriores se suman E (0) y A (0). Ahora la clase 0 tiene tres votos frente a dos de la clase 1, así que KNN predice 0.
¡El mismo punto cambia de predicción solo por el valor de \(k\)! Eso ilustra por qué elegir \(k\) es la decisión clave del método. Verifiquémoslo con código:
import numpy as np
from sklearn.neighbors import KNeighborsClassifier

X = np.array([[1.0, 1.0], [2.0, 2.0], [5.0, 5.0],
              [6.0, 4.0], [1.5, 4.0]])
y = np.array([0, 0, 1, 1, 0])
Q = np.array([[4.0, 3.5]])

for k in [3, 5]:
    knn = KNeighborsClassifier(n_neighbors=k).fit(X, y)
    print(f"k = {k}  -> predicción: {knn.predict(Q)[0]}")
k = 3  -> predicción: 1
k = 5  -> predicción: 0
4 Elegir k: el equilibrio entre sesgo y varianza
El parámetro \(k\) controla la suavidad de las decisiones:
- \(k\) pequeño (ej. 1): el modelo presta atención a un solo vecino. La frontera es muy irregular y ruidosa: varianza alta, sobreajuste.
- \(k\) grande: se promedia sobre muchos vecinos, la frontera se suaviza y se ignoran detalles locales: sesgo alto, puede subajustar.
La Figura 1 muestra este efecto: con \(k=1\) la frontera es tan recortada que rodea cada punto; con \(k=15\) se vuelve mucho más suave y general.
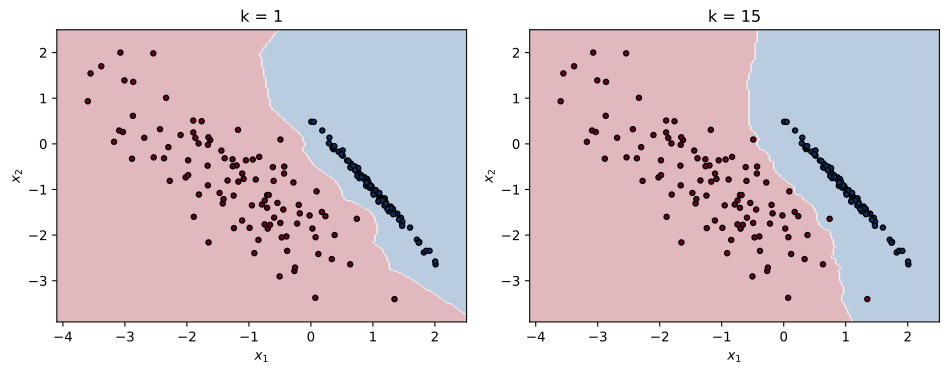
Figura 1: Frontera de decisión de KNN con k = 1 (izquierda) y k = 15 (derecha). Un k mayor suaviza la frontera.
La Figura 2 confirma el patrón clásico: la precisión de entrenamiento es máxima en \(k=1\) (memoriza) y cae al crecer \(k\); la precisión de test es peor tanto para \(k\) muy pequeño como muy grande, y alcanza su mejor valor en un punto intermedio. Por eso \(k\) se elige casi siempre por validación.
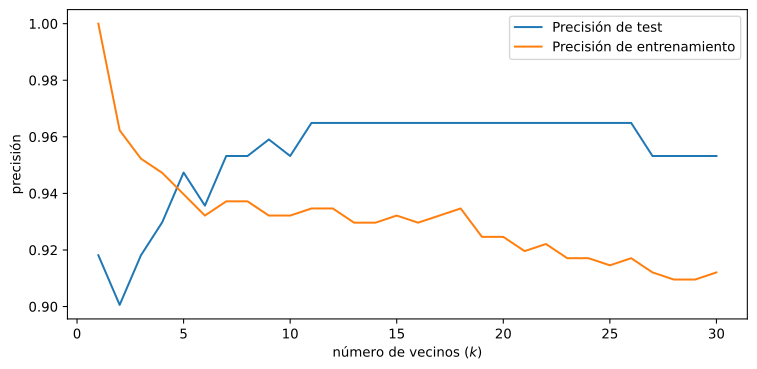
Figura 2: Precisión de entrenamiento y de test al variar k. El error de test es mínimo para un k intermedio (forma de U).
5 El escalado de variables importa de verdad
Como vimos, KNN depende de las distancias, y unas variables con escala mayor pueden “ahogar” a las demás. Para verlo con claridad, construimos un ejemplo con dos variables informativas y una tercera irrelevante pero 1000 veces mayor en escala. La Figura 3 compara la precisión de test de KNN sin estandarizar frente a con StandardScaler: sin escalar, la variable gigante domina la distancia y KNN apenas acierta; al estandarizar, todas las variables compiten en igualdad y la precisión sube enormemente.
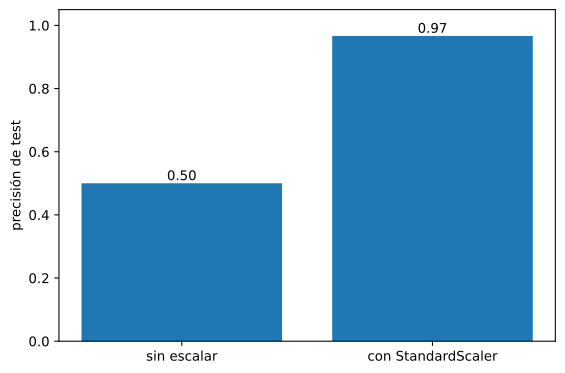
Figura 3: Precisión de test de KNN en un ejemplo didáctico con una variable irrelevante 1000 veces mayor que el resto: sin escalar, esa variable domina la distancia y KNN acierta poco; con StandardScaler, todas compiten en igualdad y la precisión sube mucho.
6 Cuándo usar KNN
Ventajas
- Extremadamente simple de entender y explicar.
- No asume ninguna forma para los datos (es no paramétrico): puede representar fronteras muy complejas.
- Funciona razonablemente bien con pocos ajustes, sobre todo tras estandarizar.
Desventajas
- Cada consulta requiere calcular la distancia a todos los ejemplos de entrenamiento. Es lento con datasets grandes.
- En muchas dimensiones, todas las distancias se parecen y “cercano” deja de ser útil.
- Es sensible a variables irrelevantes y a ruido, salvo que se seleccionen bien las características.
7 Escalabilidad: de KNN exacto a la búsqueda aproximada (ANN)
Hemos visto que, para predecir, KNN debe calcular la distancia de la consulta a todos los ejemplos de entrenamiento. Esto es la búsqueda de fuerza bruta (brute-force): garantiza los \(k\) vecinos exactos (precisión del 100 %), pero su coste crece de forma lineal con el tamaño del conjunto, \(O(N \cdot D)\), donde \(N\) es el número de ejemplos y \(D\) la dimensionalidad.
En problemas pequeños (unos miles de puntos) esto es imperceptible. Pero en aplicaciones reales —buscar entre millones de documentos o imágenes representados por embeddings de 768 o más dimensiones— una sola consulta por fuerza bruta puede tardar segundos; con miles de consultas concurrentes, el sistema colapsa. La fuerza bruta no escala.
7.1 La solución: vecinos aproximados (ANN)
Para operar a gran escala, las bases de datos vectoriales (Weaviate, Milvus, Pinecone) no usan KNN exacto, sino algoritmos de vecinos más cercanos aproximados (Approximate Nearest Neighbors, ANN). La idea es construir una estructura de índice una sola vez (al insertar los datos) que permita “saltar” por el espacio en lugar de comparar uno a uno. A cambio de sacrificar una fracción mínima de precisión (pueden devolver el segundo o tercer vecino en lugar del primero absoluto), reducen el tiempo de búsqueda a \(O(\log N)\) o incluso \(O(1)\).
El algoritmo más usado en la industria es HNSW (Hierarchical Navigable Small World). Para entender por qué es tan rápido, conviene remontarse a la idea de mundo pequeño (small world) de las redes sociales: la teoría de los “seis grados de separación”, según la cual cualquier persona está conectada con cualquier otra a través de una corta cadena de conocidos.
7.1.1 De los grafos “mundo pequeño” a HNSW
Construcción del grafo (NSW). Al insertar los vectores uno a uno, cada punto se enlaza con sus \(M\) vecinos más cercanos ya presentes (por ejemplo, \(M = 32\) conexiones por nodo). Con el tiempo aparecen de forma natural dos tipos de enlaces:
- Enlaces locales: unen puntos muy próximos entre sí (la “calle”).
- Enlaces de largo alcance (hubs): unen zonas alejadas del espacio (la “autopista”), permitiendo saltar de un extremo a otro en pocos pasos.
La Figura 4 muestra el proceso paso a paso: se insertan los nodos uno a uno y cada uno se enlaza con sus vecinos más cercanos ya presentes. Al principio solo hay enlaces cortos (locales, gris); cuando aparece un punto alejado del cúmulo, su enlace se dibuja en naranja: es un enlace de largo alcance que puentea zonas distantes.
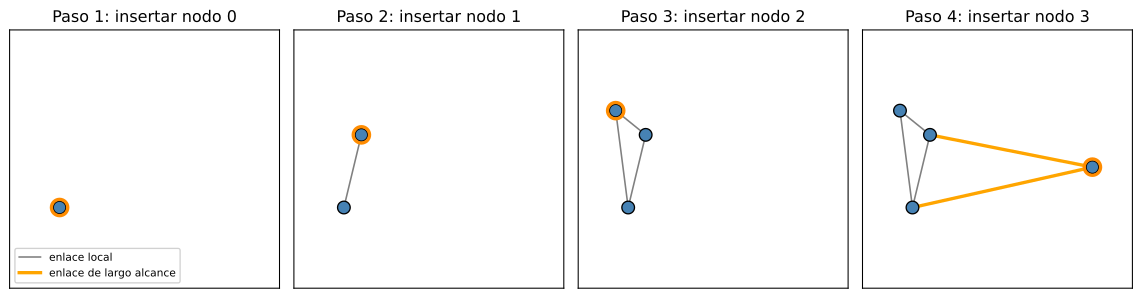
Figura 4: Construcción secuencial de un grafo NSW con M = 2 (en la práctica M suele ser mayor, p. ej. 32): cada nodo se enlaza con sus 2 vecinos más cercanos. Los enlaces cortos son locales (gris); el naranja es un enlace de largo alcance hacia un punto alejado.
Búsqueda codiciosa (greedy search). Para responder a una consulta se elige un nodo de entrada cualquiera y se camina por el grafo siguiendo estas reglas:
- Se miran los vecinos directos del nodo actual.
- Se salta al que más reduce la distancia a la consulta.
- Se repite hasta que ningún vecino esté más cerca de la consulta que el nodo actual; ahí se detiene.
En vez de comparar contra todos los puntos, solo se visitan unos pocos (los de la ruta recorrida). En este esquema de juguete, cada círculo azul es un dato ya almacenado en la base y la estrella verde es la nueva consulta cuya vecindad queremos encontrar. La Figura 5 (izquierda) muestra ese recorrido: desde el punto de entrada (anillo naranja) se desciende por los enlaces (línea naranja) hasta el nodo más cercano a la consulta.
La Figura 5 (derecha) ilustra el riesgo: con un punto de entrada desafortunado, la búsqueda puede estancarse en un nodo desde el cual ningún vecino acerca más a la consulta (un mínimo local) y detenerse lejos del vecino óptimo.
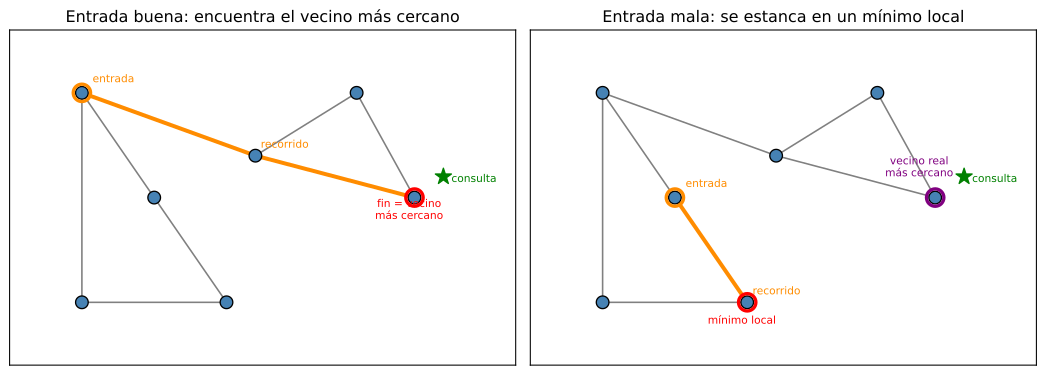
Figura 5: Búsqueda codiciosa (greedy) sobre un grafo: cada círculo azul es un dato (vector) de la base; la estrella verde es la consulta; el anillo naranja es el punto de entrada y la línea naranja es el recorrido. Izquierda: con buena entrada llega al vecino más cercano. Derecha: con mala entrada se estanca en un mínimo local (anillo rojo), lejos del vecino real (púrpura).
El problema de los mínimos locales. Como se ve en la Figura 5 (derecha), si el punto de entrada es desafortunado la búsqueda puede estancarse en una región incorrecta (un mínimo local) y devolver un vecino que no es el óptimo. Un grafo plano (NSW) no basta para escalar bien a miles de millones de registros.
La arquitectura jerárquica de HNSW. HNSW resuelve esto añadiendo capas inspiradas en las skip lists:
- Capa base (L0): contiene el 100 % de los vectores, con todas sus conexiones locales detalladas.
- Capas superiores (L1, L2, …): albergan exponencialmente menos nodos; solo quedan unos pocos “hubs” de largo alcance.
La consulta empieza en la cúspide y da saltos gigantes (autopista) que acercan de inmediato la búsqueda a la zona de la consulta; luego desciende capa por capa y, en la base, hace el “último kilómetro” afinando entre los vecinos locales. Esto esquiva los mínimos locales y deja el coste en \(O(\log N)\). La Figura 6 ilustra la idea: muchos puntos en la base, pocos hubs arriba, y una ruta de búsqueda que baja de capa en capa.
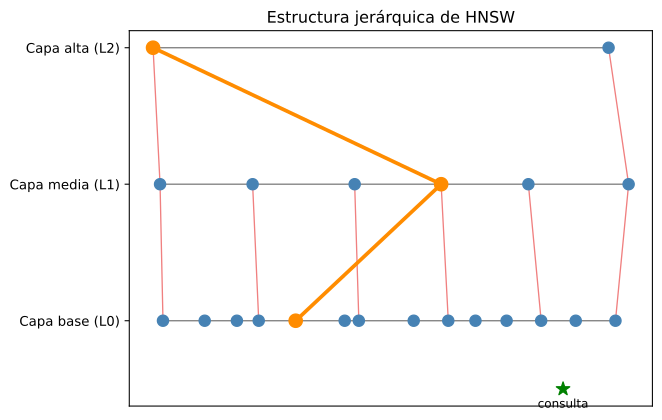
Figura 6: Esquema de HNSW: la capa base (L0) tiene todos los puntos; las capas superiores, solo unos pocos hubs. La ruta naranja es una búsqueda que desciende de capa en capa hasta refinar en la base.
Cómo la búsqueda jerárquica esquiva el mínimo local. La Figura 7 retoma el mismo grafo y la misma consulta que se atascaba en la Figura 5 (derecha). En la capa superior solo hay unos pocos hubs unidos por enlaces de largo alcance: desde la entrada se da un salto directo (la “autopista”, en morado) hasta la zona de la consulta; al descender capa por capa y refinar en la base, la búsqueda local ya parte de un punto cercano y alcanza el vecino real (T) sin quedar atrapada en el mínimo local.
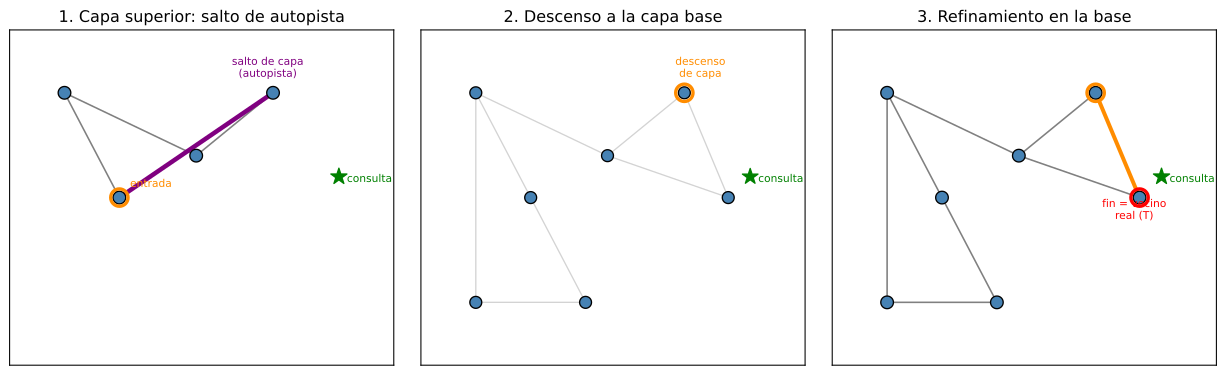
Figura 7: La búsqueda jerárquica (HNSW) resuelve el mínimo local del grafo plano. (1) Capa superior: pocos hubs unidos por enlaces de largo alcance; desde la entrada se salta directo a la zona de la consulta (autopista, morado). (2) Descenso de capa: la búsqueda baja a la capa base donde aterrizó el salto. (3) Refinamiento en la base: la búsqueda local ya parte cerca de la consulta y llega al vecino real (T), sin atascarse.
Nota
KNN sigue siendo la idea subyacente —encontrar los \(k\) vecinos más cercanos por distancia—, pero en producción la búsqueda exacta se sustituye por ANN para ganar velocidad. Por eso, cuando leas sobre RAG, motores de búsqueda semántica o recomendadores a gran escala, encontrarás HNSW detrás, no un bucle de fuerza bruta.
En la práctica, para la mayoría de problemas tabulares con los que se empieza, el KNN de scikit-learn (cuya opción algorithm="auto" ya elige KD-tree o ball-tree cuando puede) es más que suficiente. ANN entra en juego cuando el volumen o la dimensionalidad se vuelven enormes.
8 Demo ejecutable
Entrenamos KNN sobre un problema de clasificación real (datos de cáncer de mama), usando un pipeline que estandariza primero. Dividimos en entrenamiento y test y reportamos la precisión.
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import Pipeline
from sklearn.neighbors import KNeighborsClassifier

datos = load_breast_cancer()
X_ent, X_prueba, y_ent, y_prueba = train_test_split(
    datos.data, datos.target, test_size=0.30, random_state=0, stratify=datos.target)

pipeline = Pipeline([
    ("scaler", StandardScaler()),
    ("knn", KNeighborsClassifier(n_neighbors=5))
])
pipeline.fit(X_ent, y_ent)

print("Precisión en entrenamiento:", round(pipeline.score(X_ent, y_ent), 4))
print("Precisión en test:", round(pipeline.score(X_prueba, y_prueba), 4))
Precisión en entrenamiento: 0.9799
Precisión en test: 0.9474
Sin tocar casi nada más que el escalado y el valor de \(k\), KNN ya ofrece una precisión competitiva. Eso lo convierte en un excelente punto de partida antes de probar modelos más elaborados.