Clasificación multiclase y Softmax
1 ¿Qué es la clasificación multiclase?
Hasta ahora hemos visto clasificación binaria: la red responde sí o no, gato o no gato, spam o no spam. Pero en la vida real muchas veces hay más de dos categorías posibles. Ese es el problema de la clasificación multiclase.
Imagina que quieres clasificar imágenes de animales en cuatro categorías: gato, perro, pollito u otro. O reconocer dígitos escritos a mano, donde la salida puede ser cualquiera de los 10 números (0 al 9). En todos estos casos, \(y\) puede tomar más de dos valores, y necesitamos una red neuronal capaz de estimar la probabilidad de cada clase por separado.
| Problema | Clases posibles | Tipo |
|---|---|---|
| ¿Es spam? | 2 (sí / no) | Binario |
| ¿Qué animal es? | 4 (gato, perro, pollito, otro) | Multiclase |
| ¿Qué dígito es? | 10 (0-9) | Multiclase |
En un problema de clasificación binaria, la regresión logística produce una sola salida: la probabilidad de que \(y=1\). Si esa probabilidad es 0.71, entonces la probabilidad de que \(y=0\) es simplemente \(1 - 0.71 = 0.29\).
Pero ¿qué pasa cuando tenemos 4, 10 o 100 clases? Necesitamos un algoritmo que calcule la probabilidad de cada clase y que todas sumen exactamente 1. Eso es exactamente lo que hace softmax.
2 Softmax: generalización de la regresión logística
La función softmax es una extensión de la función sigmoidea que permite manejar múltiples clases simultáneamente. Mientras que la regresión logística calcula una única probabilidad, softmax calcula un vector de probabilidades, una por cada clase.
2.1 Cómo funciona softmax
Recordemos que en regresión logística calculamos una combinación lineal \(z = w \cdot x + b\) y la pasamos por la sigmoidea para obtener una probabilidad. En softmax, en lugar de una sola salida, tenemos un vector de salidas \(z\) con un valor por cada clase:
Para convertir esos valores en probabilidades que sumen 1, softmax aplica la siguiente fórmula:
Es decir: se calcula el exponencial de cada valor \(z_k\), y luego se divide entre la suma de todos los exponenciales. Esto garantiza que:
- Todos los \(a_k\) son positivos (porque el exponencial siempre es positivo).
- La suma de todas las probabilidades es exactamente 1: \(\sum_{k=1}^{K} a_k = 1\).
- Cuanto mayor sea \(z_k\), mayor será la probabilidad \(a_k\) de esa clase.
Nota
Softmax no opera sobre un único escalar como la sigmoidea, sino sobre un vector completo. A diferencia de ReLU o tanh, que se aplican elemento a elemento, softmax mezcla toda la información del vector \(z\) para producir probabilidades normalizadas.
2.2 Ejemplo con 4 clases
Supongamos que tenemos 4 clases (gato, perro, pollito, otro) y para una imagen concreta la red produce los siguientes valores:
Aplicamos softmax paso a paso:
| Clase | \(z_k\) | \(e^{z_k}\) | \(a_k\) (probabilidad) |
|---|---|---|---|
| Gato | 2.0 | 7.389 | 0.575 |
| Perro | 1.0 | 2.718 | 0.211 |
| Pollito | 0.1 | 1.105 | 0.086 |
| Otro | 0.5 | 1.649 | 0.128 |
La suma de los exponenciales es \(7.389 + 2.718 + 1.105 + 1.649 = 12.861\). Dividiendo cada exponencial entre ese total obtenemos las probabilidades (\(0.575 + 0.211 + 0.086 + 0.128 = 1.000\)). La clase predicha sería “Gato” (0.575), que es la de mayor probabilidad.
Tip
En la práctica se resta el valor máximo de \(z\) antes de calcular los exponenciales para evitar overflow numérico. Es decir, se calcula \(e^{z_k - \max(z)}\) en lugar de \(e^{z_k}\). El resultado es idéntico porque el factor de normalización se cancela.
2.3 Hardmax vs Softmax
Existe una función llamada hardmax que asigna 1 a la clase con mayor valor de \(z\) y 0 a todas las demás. Por ejemplo, con \(z = [5, 2, -1]\):
- Hardmax: \([1, 0, 0]\) — una respuesta categórica, sin matices.
- Softmax: \([0.950, 0.047, 0.002]\) — probabilidades suaves que reflejan la confianza relativa (\(e^5=148.413\), \(e^2=7.389\), \(e^{-1}=0.368\), suma \(156.170\)).
Softmax es más útil porque preserve información sobre la incertidumbre del modelo, y además es diferenciable, lo que permite entrenar la red con descenso del gradiente.
2.4 Sin capas ocultas: regresión softmax (lineal)
Incluso sin capas ocultas, un clasificador softmax puede separar datos en múltiples clases con fronteras de decisión lineales. Cada frontera entre dos clases es un hiperplano recto. Pero cuando combinamos softmax con capas ocultas (red neuronal profunda), la red puede aprender fronteras no lineales mucho más complejas, como hemos visto en secciones anteriores.
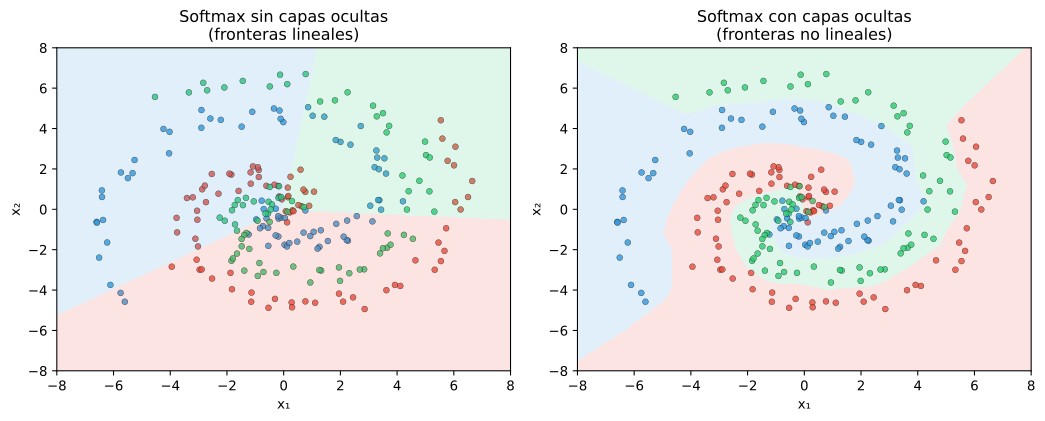
Figura 1: Softmax sin capas ocultas (izquierda) produce fronteras lineales que no pueden separar clases entrelazadas. Con capas ocultas (derecha) la red aprende fronteras no lineales mucho más flexibles.
2.5 El mismo patrón en otras activaciones
Un resultado que parece una coincidencia pero no lo es: la derivada de la pérdida respecto a la entrada neta \(z\) siempre tiene la forma \(a - y\), sin importar si usamos sigmoide, lineal o softmax en la salida. Esto se debe a que la entropía cruzada está diseñada para cancelar los términos complicados de la derivada de sigmoide y softmax.
| Activación de salida | Pérdida | \(\frac{\partial L}{\partial z}\) |
|---|---|---|
| Sigmoide (clasificación binaria) | Entropía cruzada binaria | \(a - y\) |
| Lineal (regresión) | MSE \(\frac{1}{2}(a-y)^2\) | \(a - y\) |
| Softmax (clasificación multiclase) | Entropía cruzada categórica | \(a_k - y_k\) |
Para el caso de sigmoide + entropía cruzada binaria, la demostración es directa:
Para lineal + MSE es aún más sencillo:
Y para softmax + entropía cruzada categórica ya lo hemos visto: \(\frac{\partial L}{\partial z_k} = a_k - y_k\).
Nota
En los tres casos el gradiente es simplemente “predicción menos verdad”. Esta elegancia no es casualidad: la entropía cruzada fue elegida como función de pérdida precisamente porque, compuesta con sigmoidea o softmax, produce un gradiente limpio y fácil de interpretar. Si usáramos MSE con sigmoide, la derivada sería mucho más complicada.
3 Función de coste: entropía cruzada
Para entrenar una red con softmax necesitamos medir cuánto se equivoca. La función de coste habitual es la entropía cruzada (cross-entropy), que es una generalización de la pérdida logística que usamos en clasificación binaria.
3.1 La pérdida en un solo ejemplo
Para un ejemplo de entrenamiento con etiqueta verdadera \(y = k\) (es decir, la clase real es \(k\)), la pérdida es:
donde \(a_k\) es la probabilidad que softmax asignó a la clase \(k\). Es decir, solo nos fijamos en la probabilidad de la clase correcta; el resto de términos se anulan porque \(y_j = 0\) para \(j \neq k\).
La intuición es sencilla:
- Si el modelo asigna \(a_k = 0.99\) (muy seguro y correcto), la pérdida es \(-\log(0.99) \approx 0.01\) → muy pequeña.
- Si asigna \(a_k = 0.5\) (menos seguro), la pérdida es \(-\log(0.5) \approx 0.69\) → mayor.
- Si asigna \(a_k = 0.05\) (casi seguro y equivocado), la pérdida es \(-\log(0.05) \approx 3.0\) → muy grande.
Importante
Cuanto menor sea la probabilidad \(a_k\) que el modelo asigna a la clase correcta, mayor será la penalización. Esto obliga al algoritmo a maximizar la probabilidad de la clase real.
La función \(-\log(a)\) tiene esta forma:
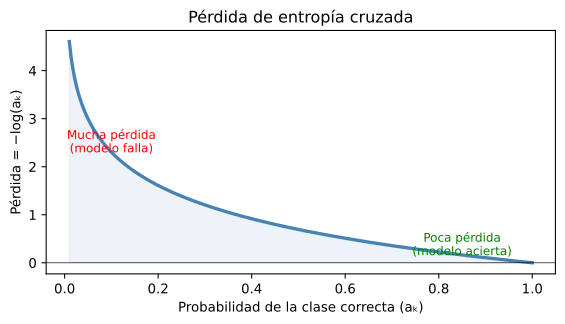
Figura 2: La función -log(a) penaliza fuertemente las probabilidades bajas de la clase correcta. Si a está cerca de 1, la pérdida es casi cero; si a se acerca a 0, la pérdida crece rápidamente.
3.2 El coste sobre todo el conjunto
El coste \(J\) es simplemente el promedio de las pérdidas individuales sobre los \(m\) ejemplos de entrenamiento:
donde \(k\) es la clase real del ejemplo \(i\), y \(a_k^{(i)}\) es la probabilidad que el modelo asignó a esa clase.
3.3 Entropía cruzada con lotes (mini-batches)
En la práctica trabajamos con lotes de \(m\) ejemplos apilados como columnas en matrices. Si la salida de la capa softmax es \(A\) (matriz de dimensiones \(K \times m\)) y la etiqueta real es un vector \(Y\) de dimensión \(1 \times m\), la entropía cruzada se calcula solo sobre las probabilidades correspondientes a las clases reales.
Para cada ejemplo \(i\), seleccionamos la fila de \(A\) que corresponde a la clase \(y^{(i)}\) y aplicamos el logaritmo negativo:
3.4 Ejemplo numérico completo
Supongamos que tenemos tres neuronas de salida con las siguientes entradas netas y la etiqueta real es la clase 3 (\(y = [0, 0, 1]\)):
Paso 1 — Calcular las activaciones con softmax:
| Neurona | \(z_k\) | \(e^{z_k}\) | \(a_k\) |
|---|---|---|---|
| 1 | 2 | 7.389 | 0.245 |
| 2 | 1 | 2.718 | 0.090 |
| 3 | 3 | 20.086 | 0.665 |
La suma de exponenciales es \(7.389 + 2.718 + 20.086 = 30.193\).
Paso 2 — Calcular la pérdida:
Paso 3 — Calcular las derivadas parciales de la pérdida respecto a las activaciones:
| \(k\) | \(y_k\) | \(a_k\) | \(\partial L / \partial a_k\) |
|---|---|---|---|
| 1 | 0 | 0.245 | 0 |
| 2 | 0 | 0.090 | 0 |
| 3 | 1 | 0.665 | -1.504 |
Nota
Como \(y_1 = y_2 = 0\), las derivadas para esas neuronas son cero. Solo la neurona 3 (la clase real) recibe señal de error. Esto tiene sentido: el modelo solo necesita corregir la probabilidad de la clase que realmente es.
3.5 La derivada de softmax: una propiedad elegante
Para calcular el gradiente y actualizar los pesos necesitamos la derivada de \(a_k\) respecto a cada \(z_j\). Aquí softmax tiene una propiedad especial que simplifica mucho los cálculos:
Cuando componemos esto con la entropía cruzada, el resultado final para la derivada de la pérdida respecto a la entrada neta es extraordinariamente limpio:
Es decir, el gradiente es simplemente la diferencia entre la predicción y la verdad. Si la red predijo 0.665 y la verdad era 1, el gradiente es \(0.665 - 1 = -0.335\), lo que empuja \(z_3\) hacia arriba para aumentar la probabilidad de esa clase. Esta limpieza matemática es una de las razones por las que softmax + entropía cruzada es el estándar en clasificación multiclase.
3.5.1 Aplicación al ejemplo anterior
Recordemos el ejemplo con \(z = [2, 1, 3]\) y \(y = [0, 0, 1]\). En el paso anterior calculamos \(\partial L / \partial a_k\) (la derivada respecto a la activación), que fue \([0, 0, -1.504]\). Pero ahora podemos saltarnos ese paso por completo.
Con la propiedad \(\frac{\partial L}{\partial z_k} = a_k - y_k\), simplemente restamos:
| \(k\) | \(a_k\) | \(y_k\) | \(\frac{\partial L}{\partial z_k} = a_k - y_k\) |
|---|---|---|---|
| 1 | 0.245 | 0 | \(+0.245\) |
| 2 | 0.090 | 0 | \(+0.090\) |
| 3 | 0.665 | 1 | \(-0.335\) |
Los tres valores coinciden exactamente con los que obtendríamos siguiendo el camino largo (calcular \(\partial L/\partial a_k\) y multiplicar por \(\partial a_k/\partial z_j\) usando la propiedad especial de softmax). Pero aquí no necesitamos la derivada de softmax \(\partial a_k/\partial z_j\) ni \(\partial L/\partial a_k\): sabemos de antemano que el gradiente es \(a_k - y_k\).
Nota
En la práctica, cuando entrenamos una red neuronal, nunca calculamos \(\partial L/\partial a_k\) por separado. El algoritmo de retropropagación, combinado con la entropía cruzada, produce directamente \(\partial L/\partial z_k = a_k - y_k\) en la capa de salida. Esto es cierto tanto para sigmoide como para softmax. Solo necesitamos calcular las derivadas intermedias (hasta la capa oculta anterior), que dependen de las activaciones y pesos de cada capa.
4 Arquitectura de la red para multiclase
Para problemas de clasificación multiclase, la red neuronal se diseña con una capa de salida de \(K\) unidades, una por cada clase. La activación de esa capa es softmax.
Entrada x → Capas ocultas (ReLU) → z = W·a + b → Softmax → a = [a₁, a₂, ..., aₖ]
Cada neurona de salida calcula un logit \(z_k\) mediante una combinación lineal de las activaciones de la capa anterior. Luego, softmax convierte el vector \(z\) en un vector de probabilidades \(a\) que suma 1.
La predicción final es la clase con mayor probabilidad:
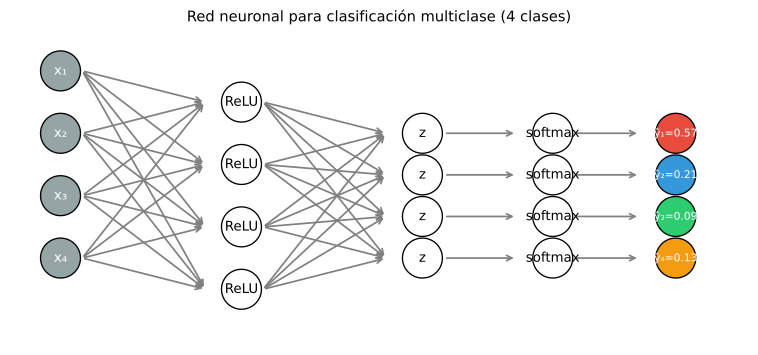
Figura 3: Red neuronal para clasificación multiclase con 4 clases. La capa de salida usa softmax para convertir los logits en probabilidades que suman 1.
Tip
La diferencia clave con la clasificación binaria es que ahora la capa de salida tiene K neuronas (una por cada clase) en lugar de una sola, y usamos softmax en lugar de sigmoidea. Todo lo demás (capas ocultas con ReLU, descenso del gradiente, retropropagación) funciona igual.