Segmentación Semántica, Convolución Transpuesta y Arquitectura U-Net
Navegación en esta sección
Capítulos anteriores del bloque de Visión Artificial: 1. Redes neuronales convolucionales (CNN) — convolución, padding, pooling y LeNet-5. 2. Matemáticas de la capa convolucional — cálculo manual y backpropagation. 3. Arquitecturas clásicas y modernas de CNN — AlexNet, VGG, ResNet, Inception y MobileNet. 4. Práctica en Visión Artificial — Transfer Learning y Data Augmentation. 5. Detección de Objetos y YOLO — localización con cuadros delimitadores.
Estás en Segmentación Semántica y U-Net (clasificación píxel a píxel, convolución transpuesta y arquitecturas encoder-decoder).
1 De los Cuadros a las Máscaras: La Segmentación Semántica
En el capítulo anterior sobre Detección de Objetos, aprendimos a encerrar objetos dentro de cuadros delimitadores (bounding boxes). Aunque una caja delimitadora es suficiente para contar coches o detectar peatones en una calle, existen escenarios donde necesitamos una precisión geométrica absoluta.
La segmentación semántica (Semantic Segmentation) consiste en clasificar cada píxel individual de la imagen en una categoría determinada. El resultado no es un conjunto de rectángulos, sino una máscara densa de etiquetas con las mismas dimensiones espaciales (\(H \times W\)) que la imagen de entrada.
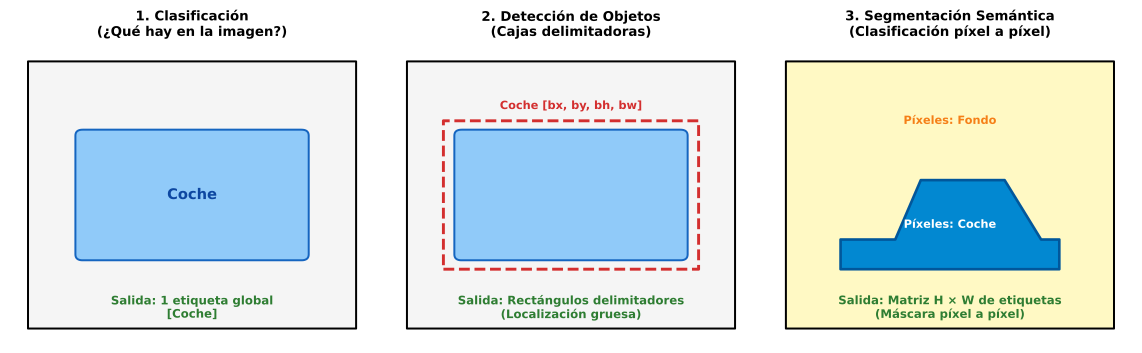
Figura 1: Evolución de tareas en visión artificial: Clasificación (izquierda, 1 etiqueta global), Detección (centro, cuadros delimitadores) y Segmentación Semántica (derecha, máscara densa píxel a píxel).
1.1 Aplicaciones principales
- Conducción Autónoma: Para que un coche sin conductor navegue con seguridad, necesita delimitar con exactitud milimétrica la superficie transitable de la carretera, las líneas de carril continuas y discontinuas, las aceras, los pasos de peatones y los obstáculos irregulares.
- Diagnóstico Médico por Imagen: En radiografías de tórax, tomografías computarizadas (TC) o resonancias magnéticas (RM), los médicos necesitan segmentar órganos completos (pulmones, corazón, riñones) o delimitar con extrema precisión los bordes de tumores y lesiones para planificar cirugías o radioterapia.
- Agricultura de Precisión y Satélites: Detección de áreas deforestadas, tipos de cultivos, masas de agua y avance de incendios a partir de imágenes aéreas multiespectrales.
2 El reto del muestreo inverso (Upsampling)
En las redes convolucionales estándar para clasificación (como VGG o ResNet), la imagen se reduce espacialmente a medida que avanza por capas convolucionales y de pooling (\(224\times224 \to 112\times112 \to 56\times56 \to \dots \to 7\times7\)), terminando en un vector \(1\text{D}\).
Para la segmentación semántica, necesitamos que la salida recupere exactamente la resolución espacial original (\(H \times W\)).
Aunque podríamos utilizar algoritmos fijos de interpolación (como el vecino más cercano o la interpolación bilineal), estos métodos son estáticos y no aprenden de los datos. Necesitamos una operación matemática invertible con pesos entrenables por retropropagación: la convolución transpuesta.
3 La Convolución Transpuesta (Transposed Convolution)
La convolución transpuesta (también denominada a veces desconvolución o convolución con paso fraccionario) es la operación inversa de la convolución: toma una entrada de baja resolución espacial y la expande a una salida de mayor tamaño.
3.1 Mecánica de cálculo paso a paso
A diferencia de la convolución estándar (donde el filtro se superpone a una ventana de entrada para calcular un único número escalar de salida), en la convolución transpuesta cada valor escalar de la entrada se multiplica por todo el filtro \(K \times K\) y se distribuye sobre la matriz de salida mayor.
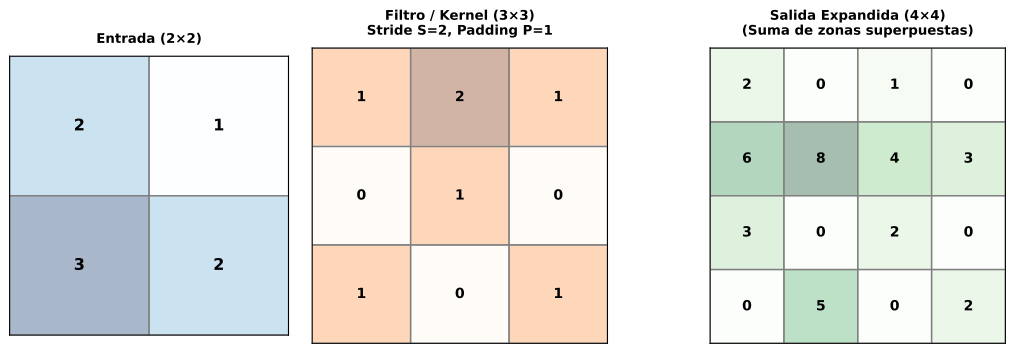
Figura 2: Mecánica de la Convolución Transpuesta: una entrada 2×2 (izquierda) se proyecta con un filtro 3×3 con paso S=2 y padding P=1 (centro) para generar una salida expandida de 4×4 sumando las contribuciones solapadas (derecha).
Consideremos una entrada \(X\) de \(2 \times 2\), un filtro \(W\) de \(3 \times 3\), un paso \(S=2\) y un padding \(P=1\):
- Píxel \((0,0)\) de la entrada (valor \(2\)): Se multiplica por la matriz del filtro (\(2 \times W\)) y se coloca en la esquina superior izquierda de la salida.
- Píxel \((0,1)\) de la entrada (valor \(1\)): Se desplaza la posición \(S=2\) pasos hacia la derecha, se multiplica por el filtro (\(1 \times W\)) y se suma elemento a elemento sobre los valores que coincidan con la región anterior.
- Píxel \((1,0)\) (valor \(3\)) y Píxel \((1,1)\) (valor \(2\)): Se desplazan \(S=2\) pasos hacia abajo y se acumulan sus productos sobre la matriz de salida.
3.2 Fórmula de dimensiones de salida
La dimensión espacial de la salida \(n_{\text{salida}}\) generada por una convolución transpuesta con entrada \(n_{\text{entrada}}\), kernel \(K\), paso \(S\) y padding \(P\) viene dada por:
Para nuestro ejemplo (\(n=2, K=3, S=2, P=1\)):
4 La Arquitectura U-Net (Ronneberger et al., 2015)
Propuesta originalmente por Olaf Ronneberger, Philipp Fischer y Thomas Brox para la segmentación de imágenes biomédicas, la arquitectura U-Net es el estándar indiscutible para segmentación semántica debido a su elegante diseño simétrico en forma de “U”.
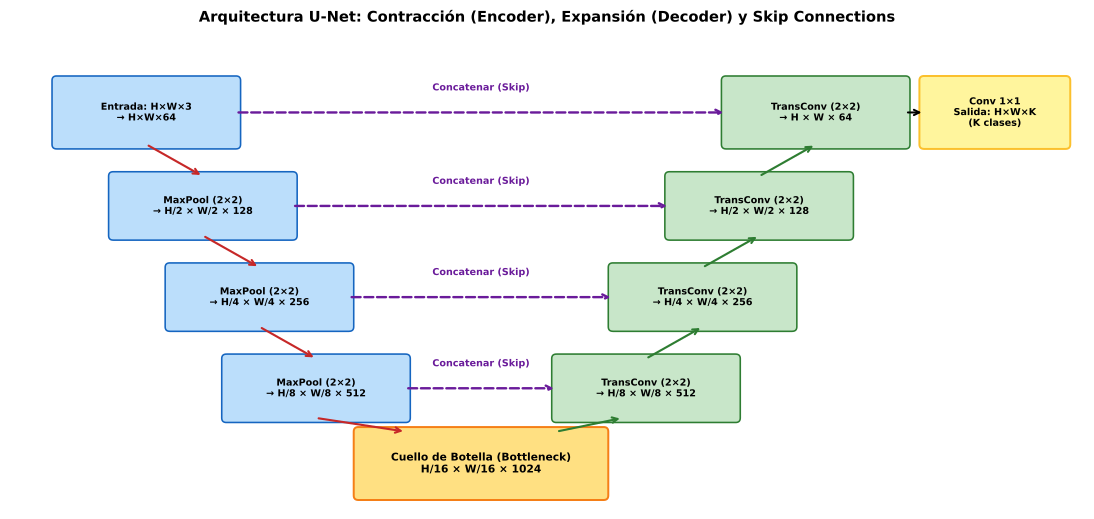
Figura 3: Arquitectura U-Net completa: Camino de Contracción (Encoder en azul, extracción semántica), Camino de Expansión (Decoder en verde, recuperación de resolución) y Conexiones de Salto por Concatenación (flechas moradas, inyección de textura fina).
4.1 Estructura de los tres componentes
4.1.1 1. Camino de Contracción (Contracting Path / Encoder)
La mitad izquierda de la red actúa como un extractor de características convolucional clásico:
- Consiste en bloques repetidos de dos convoluciones \(3 \times 3\) con ReLU seguidas de un Max Pooling \(2 \times 2\) (stride 2).
- En cada nivel, el Max Pooling reduce la resolución espacial a la mitad (\(H/2 \times W/2\)), mientras que las convoluciones duplican el número de canales (\(64 \to 128 \to 256 \to 512\)).
- Objetivo: Extraer representaciones semánticas profundas de alto nivel («qué objeto está presente en la imagen»), a costa de perder la precisión de la posición espacial exacta de los bordes.
4.1.2 2. Cuello de Botella (Bottleneck)
En el fondo de la “U”, la red alcanza su máxima profundidad de canales (1024 canales) y su mínima resolución espacial (\(H/16 \times W/16\)), condensando el contexto semántico global de la escena.
4.1.3 3. Camino de Expansión (Expanding Path / Decoder)
La mitad derecha de la red reconstruye progresivamente el mapa de segmentación a tamaño completo:
- En cada etapa, una convolución transpuesta \(2 \times 2\) (stride 2) duplica las dimensiones espaciales (\(H \times W\)) y reduce a la mitad el número de canales.
- A continuación, se aplica la conexión de salto: se toma el mapa de características del mismo nivel en el encoder y se concatena a lo largo del eje de canales.
- Sobre el volumen combinado se aplican dos convoluciones \(3 \times 3\) con ReLU para fusionar la información.
4.2 El ingrediente secreto: Conexiones de salto por concatenación
¿Por qué U-Net concatena los mapas del encoder en lugar de sumarlos como en ResNet?
Para segmentar con precisión milimétrica, la red necesita dos tipos de información aparentemente contradictorios:
- Contexto semántico global (Decoder): Sabe qué objeto hay, pero ha perdido la nitidez de los bordes debido a los múltiples Max Pooling.
- Texturas y bordes de alta resolución (Encoder): Conserva la posición exacta de cada píxel y cada arruga de la imagen original, pero carece de contexto global.
Al concatenar directamente los canales de alta resolución del encoder con los canales semánticos del decoder, U-Net permite que las capas finales utilicen los gradientes finos de textura para recortar el contorno exacto del objeto.
4.3 Capa de salida: Convolución \(1 \times 1\)
Al final del decoder, la representación vuelve a tener las dimensiones espaciales originales \(H \times W\) con 64 canales. Una convolución \(1 \times 1\) final con \(K\) filtros proyecta estos canales en un volumen de salida:
- Para segmentación binaria (\(K=1\)) (ej. tumor vs tejido sano): Se aplica una función Sigmoide por píxel (\(\hat{y}_{ij} \in [0, 1]\)).
- Para segmentación multiclase (\(K > 2\)) (ej. coche, carretera, acera, peatón): Se aplica una función Softmax independiente sobre el vector de \(K\) canales en cada posición espacial \((i, j)\):
5 Función de pérdida en Segmentación Semántica
La función de coste estándar es la Entropía Cruzada Píxel a Píxel (Pixel-wise Cross-Entropy):
5.1 Pérdida Dice (Dice Loss / F1-Score)
En aplicaciones médicas donde el objeto de interés (por ejemplo, una lesión pequeña) ocupa apenas el \(1\%\) de los píxeles de la imagen, la entropía cruzada estándar sufre de un grave desbalance de clases (la red puede predecir “todo fondo” y tener un \(99\%\) de acierto).
Para solucionarlo, se utiliza la pérdida de Dice, basada en el coeficiente de similitud de Sørensen-Dice:
donde \(\epsilon\) es una constante pequeña para evitar división por cero. El coeficiente Dice penaliza fuertemente el desacuerdo en la región positiva independientemente del tamaño del fondo.
6 Código interactivo en Python: Convolución Transpuesta y Flujo U-Net
El siguiente script en Python implementa una convolución transpuesta \(2\text{D}\) paso a paso y simula el flujo de contracción, concatenación y expansión de U-Net en NumPy:
import numpy as np

# 1. Implementación de Convolución Transpuesta 2D (Stride 2, Padding 1)
def conv2d_transpose(X, W, stride=2, padding=1):
    """
    X: Entrada (H_in, W_in)
    W: Filtro (K, K)
    """
    H_in, W_in = X.shape
    K = W.shape[0]
    H_out = (H_in - 1) * stride - 2 * padding + K
    W_out = (W_in - 1) * stride - 2 * padding + K

    output = np.zeros((H_out + 2 * padding, W_out + 2 * padding))

    for i in range(H_in):
        for j in range(W_in):
            r_start = i * stride
            c_start = j * stride
            output[r_start:r_start+K, c_start:c_start+K] += X[i, j] * W

    # Recortar el padding exterior
    if padding > 0:
        return output[padding:-padding, padding:-padding]
    return output

X_in = np.array([[2, 1], [3, 2]], dtype=float)
W_kernel = np.array([[1, 2, 1], [0, 1, 0], [1, 0, 1]], dtype=float)
out_expanded = conv2d_transpose(X_in, W_kernel, stride=2, padding=1)

print("=" * 60)
print("1. CONVOLUCIÓN TRANSPUESTA (2x2 -> 4x4)")
print("=" * 60)
print("Entrada (2×2):\n", X_in)
print("\nSalida Expandida (4×4):\n", out_expanded)

# 2. Simulación de Concatenación de Canales en U-Net
print("\n" + "=" * 60)
print("2. FUSIÓN POR CONCATENACIÓN EN U-NET (SKIP CONNECTION)")
print("=" * 60)

# Activación de alta resolución del Encoder (H=16, W=16, C=64)
enc_features = np.random.randn(16, 16, 64)

# Activación expandida del Decoder (H=16, W=16, C=64)
dec_features = np.random.randn(16, 16, 64)

# Concatenación a lo largo del eje de canales (axis=-1)
fused_features = np.concatenate([enc_features, dec_features], axis=-1)

print(f"Dimensiones Encoder (Skip):  {enc_features.shape}")
print(f"Dimensiones Decoder (Up):    {dec_features.shape}")
print(f"Dimensiones Concatenadas:    {fused_features.shape} (64 + 64 = 128 canales)")

# Proyección final 1x1 para K=3 clases (Coche, Carretera, Fondo)
W_1x1 = np.random.randn(128, 3) * 0.05
logits = np.dot(fused_features, W_1x1) # (16, 16, 3)

def softmax_spatial(z):
    exp_z = np.exp(z - np.max(z, axis=-1, keepdims=True))
    return exp_z / np.sum(exp_z, axis=-1, keepdims=True)

segmentation_map = softmax_spatial(logits)
predicted_classes = np.argmax(segmentation_map, axis=-1)

print(f"Mapa final de segmentación:  {predicted_classes.shape} (Clase predicha por píxel)")
============================================================
1. CONVOLUCIÓN TRANSPUESTA (2x2 -> 4x4)
============================================================
Entrada (2×2):
 [[2. 1.]
 [3. 2.]]

Salida Expandida (4×4):
 [[2. 0. 1.]
 [6. 8. 4.]
 [3. 0. 2.]]

============================================================
2. FUSIÓN POR CONCATENACIÓN EN U-NET (SKIP CONNECTION)
============================================================
Dimensiones Encoder (Skip):  (16, 16, 64)
Dimensiones Decoder (Up):    (16, 16, 64)
Dimensiones Concatenadas:    (16, 16, 128) (64 + 64 = 128 canales)
Mapa final de segmentación:  (16, 16) (Clase predicha por píxel)
Siguiente paso: Aprendizaje métrico y One-Shot Learning
Descubre cómo comparar identidades y reconocer rostros a partir de una única fotografía en Reconocimiento Facial, Redes Siamesas y Triplet Loss.