Funciones de error y optimización convexa
1 Máximos, Mínimos y la Pendiente Cero
Para buscar puntos óptimos de una función, una herramienta es la derivada. Si visualizamos una función en una gráfica, los máximos y mínimos locales interiores de una función diferenciable tienen una característica geométrica común: su línea tangente es horizontal. Matemáticamente, esto significa que la derivada debe ser igual a cero en esos puntos:
La igualdad \(f'(x)=0\) es una condición necesaria, pero no suficiente, para que exista un máximo o un mínimo local. En una función de una variable, un punto con derivada cero también puede ser un punto estacionario que no sea un extremo, como ocurre en \(f(x)=x^3\) para \(x=0\). Para clasificarlo debemos analizar, por ejemplo, el cambio de signo de la derivada, la segunda derivada o el comportamiento de la función alrededor del punto.
- Máximos/Mínimos Locales: Son las cimas o fondos de valles de una región. Si miras alrededor del punto, eres el punto más alto o bajo, pero si caminas más allá, puede haber montañas más grandes.
- Máximos/Mínimos Globales: Es el punto más alto absoluto o el punto más bajo absoluto de toda la función.
Para optimizar en Machine Learning, hay que entender que operamos con dos funciones distintas que interactúan entre sí. Vamos a tener una parámetros de entrada que pasarán por la función del modelo que darán una salida, en función de la salida tendremos un error. Entonces los mismos parámetros de entrada que han generado un error pasan por una función de error.
- Función del modelo: Usa unos parámetros de entrada (\(x\), o los pesos \(w\) del modelo) y genera una salida, que es la predicción (\(\hat{y}\)).
- Función de error: No mide la predicción, sino qué tan mala fue esa predicción. Mediante los parámetros del modelo, evalúa la distancia entre la salida del modelo y los datos reales, y genera una única salida en forma de número, ese número es el error.
La optimización en machine learning consiste en encontrar los parámetros del modelo que producen un error pequeño. En funciones convexas, bajo condiciones adecuadas, el mínimo local encontrado es también global; en funciones no convexas, como muchas redes neuronales, no existe en general esa garantía.
2 Error cuadrático
Es la función de error más popular en el Machine Learning. Lo que hace es calcular la diferencia entre la predicción del modelo y el valor real, y elevar ese resultado al cuadrado.
Si graficamos esta función de error, obtenemos una parábola. Esto tiene dos consecuencias:
- Castiga los errores grandes (Outliers): Si el modelo se equivoca por \(2\), el error es \(4\). Pero si se equivoca por \(10\), el error es \(100\). La pendiente (derivada) se vuelve empinada cuando el error es grande, lo que obliga al algoritmo de optimización a dar pasos grandes para corregir ese fallo.
- Es suave en el mínimo: Cerca del fondo del valle, donde el error es casi cero porque hay poca pendiente, la curva es muy suave. Esto significa que la derivada se va haciendo más y más pequeña de forma gradual, permitiendo que el optimizador “frene” suavemente al acercarse al óptimo.
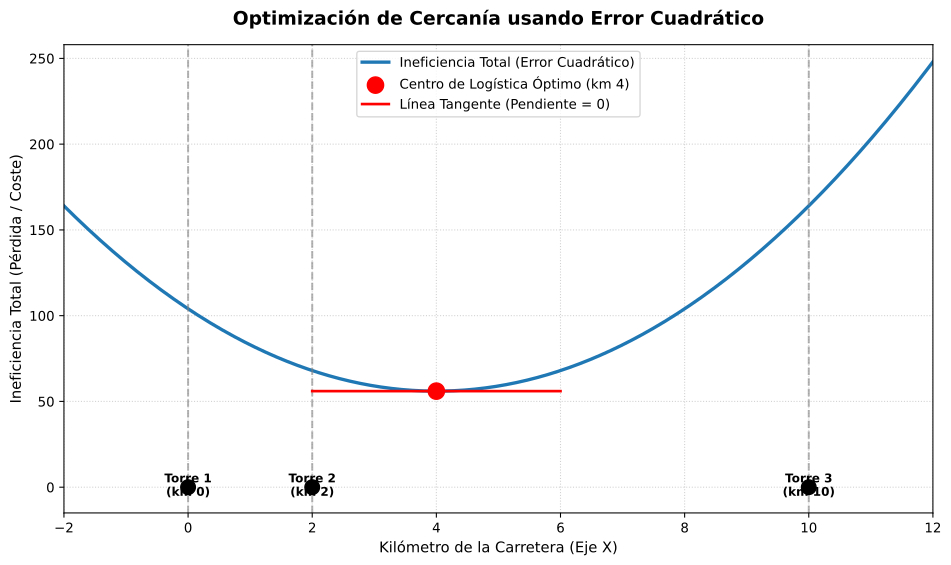
Imagina que eres el ingeniero a cargo de construir un Centro de Logística en una carretera recta (Eje X). En esa misma carretera ya existen tres Torres de Control de Tráfico ubicadas en los kilómetros \(x = 0\), \(x = 2\) y \(x = 10\).El objetivo es que el Centro de Logística esté lo más cerca posible de las tres torres a la vez para que los camiones pierdan el menor tiempo posible viajando entre ellas.
Para medir la “pérdida de cercanía” (el error), la empresa de logística utiliza el criterio cuadrático porque los costes de combustible y el desgaste de los camiones se disparan de forma cuadrática con la distancia. Queremos minimizar la ineficiencia de transporte total.
La penalización por no estar exactamente al lado de una torre es el cuadrado de la distancia que los separa. Si colocamos el centro en la posición \(x\), nuestra función de ineficiencia total será:
Si desarrollamos los cuadrados:
Teniendo la función así, calcular la derivada con la Power Rule y la regla de la constante es sencillo:
Al igualar a cero para buscar el fondo del valle, el despeje nos da el kilómetro óptimo:
Si analizamos las distancias finales desde el kilómetro 4:
- El centro logístico queda a 4 km de la primera torre.
- Queda a solo 2 km de la segunda torre.
- Queda a 6 km de la tercera torre.
import numpy as np
import matplotlib.pyplot as plt

# Positions of the towers
torres = [0, 2, 10]

# 1. Define the Total Inefficiency Function (Sum of squared distances)
def ineficiencia(x):
    return (x - torres[0])**2 + (x - torres[1])**2 + (x - torres[2])**2

# Create an array of x values (from km -2 to km 12 to see the whole landscape)
x_vals = np.linspace(-2, 12, 500)
y_vals = ineficiencia(x_vals)

# 2. Optimal point calculated by our derivative (x = 4)
x_optimo = 4
y_optimo = ineficiencia(x_optimo)

# 3. Create the plot
plt.figure(figsize=(10, 6))

# Plot the U-shaped parabola (The Loss Function)
plt.plot(x_vals, y_vals, label='Ineficiencia Total (Error Cuadrático)', color='#1f77b4', linewidth=2.5)

# Plot the position of the 3 towers as vertical lines on the floor (y=0)
for i, t in enumerate(torres):
    plt.axvline(x=t, color='gray', linestyle='--', alpha=0.6)
    plt.scatter(t, 0, color='black', s=120, zorder=5)
    plt.text(t, -5, f'Torre {i+1}\n(km {t})', ha='center', fontsize=9, fontweight='bold')

# Mark the optimal location of the Logistics Center (The Minimum)
plt.scatter(x_optimo, y_optimo, color='red', s=150, zorder=5, label=f'Centro de Logística Óptimo (km {x_optimo})')

# Draw the horizontal tangent line at the minimum (Slope = 0)
x_tangente = np.linspace(2, 6, 50)
y_tangente = np.full_like(x_tangente, y_optimo)
plt.plot(x_tangente, y_tangente, color='red', linestyle='-', linewidth=2, label='Línea Tangente (Pendiente = 0)')

# Graph customization
plt.title('Optimización de Cercanía usando Error Cuadrático', fontsize=14, fontweight='bold', pad=15)
plt.xlabel('Kilómetro de la Carretera (Eje X)', fontsize=11)
plt.ylabel('Ineficiencia Total (Pérdida / Coste)', fontsize=11)
plt.xlim(-2, 12)
plt.ylim(-15, max(y_vals) + 10)
plt.grid(True, linestyle=':', alpha=0.6)
plt.legend(loc='upper center', fontsize=10)

# Show the chart
plt.tight_layout()
plt.show()
3 Mínimos cuadrados en notación matricial
La regresión lineal conecta directamente el álgebra lineal con el cálculo. Sea \(X\) la matriz de características, \(y\) el vector de valores observados y \(\theta\) el vector de parámetros. El modelo produce:
Si queremos incluir un término independiente, añadimos una columna de unos a \(X\) y dejamos que el primer componente de \(\theta\) sea el sesgo.
El error residual es el vector:
La función de mínimos cuadrados es:
El factor \(1/2\) solo simplifica la derivada y no cambia el punto que minimiza la función. Desarrollando el gradiente se obtiene:
En un mínimo interior, el gradiente es cero. Por tanto:
Estas son las ecuaciones normales. Cuando \(X^\top X\) es invertible, la solución analítica es:
La interpretación geométrica es especialmente importante: \(X\theta\) pertenece al espacio generado por las columnas de \(X\), y la solución es la proyección de \(y\) sobre ese espacio. El residual \(r=y-X\theta\) es ortogonal a todas las columnas de \(X\):
En la práctica no siempre se calcula explícitamente la inversa. Para problemas grandes o matrices mal condicionadas se utilizan factorizaciones numéricas o descenso de gradiente.
3.1 Conexiones con otros algoritmos
- En regresión lineal, el objetivo es minimizar la norma cuadrática del residual.
- En Ridge se añade una penalización \(\lambda\|\theta\|_2^2\) para preferir parámetros pequeños.
- En Lasso se añade \(\lambda\|\theta\|_1\), lo que puede producir parámetros exactamente iguales a cero.
- En PCA, los datos se proyectan sobre direcciones que maximizan la varianza.
- En SVM, la geometría de normas y productos escalares determina el margen entre clases.
4 Hessiana y convexidad
El gradiente contiene las derivadas primeras de una función. La matriz Hessiana contiene sus derivadas segundas:
Para una función diferenciable, la condición \(\nabla f(x)=0\) solo identifica un punto estacionario. La Hessiana ayuda a clasificarlo:
- Hessiana definida positiva: mínimo local.
- Hessiana definida negativa: máximo local.
- Hessiana indefinida: punto de silla.
Por ejemplo, \(f(x,y)=x^2+2y^2\) tiene un mínimo en \((0,0)\) porque su Hessiana es definida positiva. En cambio, \(f(x,y)=x^2-y^2\) también tiene gradiente cero en \((0,0)\), pero ese punto es de silla.
Una función es convexa si cualquier segmento que une dos puntos de su gráfica queda por encima de la gráfica. En una función convexa, todo mínimo local es también mínimo global. Para una función dos veces diferenciable, una condición suficiente habitual es que su Hessiana sea semidefinida positiva en todo el dominio.
La pérdida cuadrática de la regresión lineal es convexa respecto a \(\theta\) porque su Hessiana es:
La matriz \(X^\top X\) es semidefinida positiva. Esto explica por qué la regresión lineal tiene una superficie de coste sin mínimos locales engañosos. Las redes neuronales, en cambio, suelen producir funciones no convexas.
5 Optimización restringida: multiplicadores de Lagrange
No todos los problemas permiten elegir libremente los parámetros. En una optimización restringida buscamos:
El método de los multiplicadores de Lagrange construye:
y busca puntos que satisfagan:
Equivalentemente, en un punto óptimo regular los gradientes de la función objetivo y de la restricción son paralelos:
Geométricamente, no podemos movernos en cualquier dirección: solo son válidos los desplazamientos que permanecen en la superficie definida por la restricción. El método resulta útil para entender formulaciones con normas, márgenes y restricciones, como las que aparecen en SVM.