Bosques Aleatorios (Random Forest)
1 Introducción
Hasta ahora hemos visto cómo un único árbol de decisión (ver el capítulo Árboles de decisión) es capaz de dividir el espacio de entrada en regiones mediante reglas sucesivas de la forma “si \(x_1 > 3\) entonces…”. Los árboles son modelos muy intuitivos, pero tienen un defecto grave: son inestables. Si cambias un puñado de ejemplos del conjunto de entrenamiento, el árbol resultante puede cambiar por completo. En estadística decimos que tienen varianza alta.
Los bosques aleatorios (Random Forest) abordan exactamente este problema. La idea central es tan simple como potente: en lugar de entrenar un solo árbol, entrenamos muchos árboles y dejamos que “voten” entre todos para tomar una decisión. Esta familia de métodos recibe el nombre genérico de ensambles (ensemble learning), porque combinan varios modelos (“base learners”) en uno solo.
La intuición detrás de los ensambles es la conocida como la sabiduría de las multitudes: un grupo grande de modelos medianamente buenos y, sobre todo, independientes entre sí, suele ser más acertado que cualquiera de ellos por separado. Un árbol solo puede equivocarse de forma muy particular; si tenemos 200 árboles distintos, es poco probable que todos cometan el mismo error a la vez.
En este capítulo construiremos el bosque aleatorio por capas:
- Primero veremos por qué un árbol se queda corto.
- Luego presentaremos el bagging (muestreo bootstrap + agregación).
- Después añadiremos la “aleatoriedad” que da nombre al método.
- Finalmente estudiaremos sus hiperparámetros, la importancia de variables y un ejemplo ejecutable.
2 Un solo árbol se queda corto
Recordemos brevemente cómo funciona un árbol de decisión. Partiendo de la raíz, el algoritmo elige en cada nodo la característica y el umbral que mejor separan las clases (usando, por ejemplo, la ganancia de información). El proceso se repite recursivamente hasta alcanzar una hoja, que contiene la predicción.
El problema aparece cuando dejamos crecer el árbol sin límite: cada vez se ajusta más a los datos de entrenamiento, incluyendo el ruido. El resultado es una frontera de decisión muy irregular que memoriza en vez de generalizar.
El bosque simplemente es la agregación de muchos árboles distintos. Para que esa agregación funcione, necesitamos dos ingredientes: que los árboles se entrenen sobre datos distintos (bagging) y que tomen decisiones sobre variables distintas (la parte “aleatoria”).
3 Bagging: muestreo y agregación
El término bagging es una contracción de bootstrap aggregating (agregación con bootstrap). Tiene dos pasos:
- Bootstrap. Del conjunto de entrenamiento original de \(N\) ejemplos, generamos \(B\) nuevos conjuntos de tamaño \(N\) seleccionando ejemplos con reemplazo. Es decir, cada muestra bootstrap puede contener ejemplos repetidos y dejar fuera otros. En promedio, cada muestra bootstrap deja aproximadamente un 36,8 % de los ejemplos originales sin usar; a esos se les llama out-of-bag (OOB).
- Agregación. Entrenamos un modelo (por ejemplo, un árbol) con cada muestra bootstrap. Para predecir con el ensamble:
- En clasificación: votación por mayoría simple. Cada árbol emite su clase y la clase final es la más votada.
- En regresión: promedio aritmético de las predicciones de todos los árboles.
3.1 ¿Por qué funciona? La reducción de varianza
Supongamos que tenemos \(B\) predictores \(h_1, \dots, h_B\), cada uno con la misma varianza \(\sigma^2\) y media \(\mu\). Si fueran independientes, el predictor promedio
tendría varianza
Es decir, promediar reduce la varianza en un factor \(B\). Una sola predicción puede estar muy lejos de la verdad, pero el promedio de muchas predicciones independientes tiende a estabilizarse.
El matiz importante es la palabra independientes. Si los árboles fueran idénticos, promediarlos no serviría de nada. Y, de hecho, si entrenamos árboles normales con bootstrap, todos tienden a usar las mismas variables fuertes y acaban correlacionados. Con correlación \(\rho\) entre ellos, la varianza del promedio pasa a ser
El bagging elimina el término \(\frac{1-\rho}{B}\sigma^2\) cuando \(B\) crece, pero no puede reducir la parte \(\rho\,\sigma^2\) que viene de la correlación. Ahí es donde entra la segunda fuente de aleatoriedad del bosque aleatorio.
4 Bosques Aleatorios
Un bosque aleatorio es, literalmente, bagging de árboles de decisión con una modificación en la construcción de cada árbol:
En cada nodo, antes de elegir la mejor división, el algoritmo selecciona al azar un subconjunto de las \(p\) variables disponibles y solo considera esas para dividir.
Esta restricción fuerza a los árboles a no usar siempre las mismas variables dominantes, lo que decorrelaciona los árboles entre sí. Al bajar \(\rho\), la fórmula de la varianza anterior mejora sustancialmente y el ensamble gana robustez.
4.1 El algoritmo paso a paso
Dado un conjunto de entrenamiento de \(N\) ejemplos y \(p\) variables:
- Fijar el número de árboles \(B\) y el número de variables a considerar por nodo \(m\) (típicamente \(m \approx \sqrt{p}\) en clasificación).
- Repetir \(B\) veces:
- Generar una muestra bootstrap de tamaño \(N\) (con reemplazo).
- Entrenar un árbol de decisión sobre esa muestra, pero en cada nodo elegir la mejor división solo entre \(m\) variables seleccionadas al azar.
- No podar el árbol (se deja crecer hasta las hojas; el bagging ya se encarga de regularizar).
- Para predecir:
- Clasificación: mayoría de votos de los \(B\) árboles.
- Regresión: media de las predicciones de los \(B\) árboles.
El parámetro \(m\) (en scikit-learn, max_features) es la verdadera “sal aleatoria” del método. Si \(m = p\), volvemos al bagging puro de árboles; si \(m\) es pequeño, los árboles son muy distintos entre sí.
5 Ejemplo numérico: cómo vota un bosque
Para ver el mecanismo de votación con números reales, usemos un conjunto minúsculo de 6 ejemplos en 2 dimensiones, con dos clases:
| Ejemplo | \(x_1\) | \(x_2\) | \(y\) |
|---|---|---|---|
| 1 | 1.0 | 2.0 | 0 |
| 2 | 1.5 | 1.8 | 0 |
| 3 | 5.0 | 6.0 | 1 |
| 4 | 5.5 | 5.5 | 1 |
| 5 | 1.2 | 2.2 | 0 |
| 6 | 5.2 | 6.2 | 1 |
Entrenamos un bosque de \(B=5\) árboles pequeños (profundidad 2, una sola variable por nodo). Preguntamos al bosque por el punto de prueba \(x=(3.0, 3.0)\), que queda justo en medio de las dos nubes. Veamos qué predice cada árbol y qué decide el bosque:
import numpy as np
from sklearn.ensemble import RandomForestClassifier

X = np.array([[1.0, 2.0], [1.5, 1.8], [5.0, 6.0],
              [5.5, 5.5], [1.2, 2.2], [5.2, 6.2]])
y = np.array([0, 0, 1, 1, 0, 1])

rf = RandomForestClassifier(n_estimators=5, max_depth=2,
                            max_features=1, random_state=16)
rf.fit(X, y)

xt = np.array([[3.0, 3.0]])
votos = [est.predict(xt)[0] for est in rf.estimators_]
print("Votos de los 5 árboles:", votos)
print("Predicción del bosque:", rf.predict(xt)[0])
Votos de los 5 árboles: [np.float64(1.0), np.float64(0.0), np.float64(0.0), np.float64(0.0), np.float64(0.0)]
Predicción del bosque: 0
Cada árbol vota una clase y el bosque se queda con la mayoría. Fíjate en algo clave: ningún árbol “sabe” que forma parte de un grupo; el comportamiento colectivo emerge al combinarlos. Si un árbol se confunde por haber recibido un bootstrap poco afortunado, es probable que los otros 4 no compartan ese error y lo compensen.
Nota
El argumento max_features=1 en este ejemplo fuerza a cada nodo a mirar solo una de las dos variables. Aunque en la práctica usaríamos más variables, sirve para ilustrar cómo la aleatoriedad decorrelaciona los árboles.
6 Hiperparámetros y su efecto
Los hiperparámetros más relevantes de un bosque aleatorio son:
n_estimators(\(B\)): número de árboles. Más árboles no sobreajustan (el bagging es estable), pero más allá de cierto punto el beneficio se estanca y solo cuesta más cómputo.max_features(\(m\)): variables consideradas en cada división. Controla la correlación \(\rho\) entre árboles. Valores típicos: \(\sqrt{p}\) (clasificación) o \(p/3\) (regresión).max_depth,min_samples_leaf,min_samples_split: controlan cuánto crece cada árbol. A diferencia de un árbol suelto, en un bosque es habitual dejarlos crecer bastante; el ensamble ya limita el sobreajuste.bootstrap: siTrue, se usan muestras bootstrap (bagging). SiFalse, todos los árboles ven los mismos datos y la diversidad depende solo demax_features.
La Figura 1 muestra cómo evoluciona la precisión al aumentar el número de árboles: el error de test cae rápidamente y luego se estabiliza. Por eso en la práctica es seguro usar varios cientos de árboles.
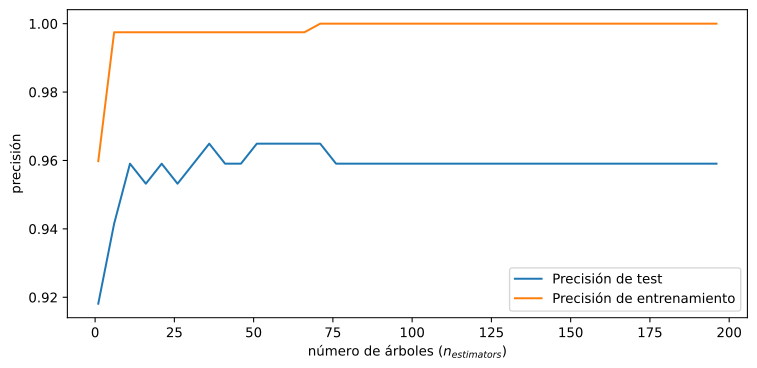
Figura 1: Precisión de test al aumentar el número de árboles. Tras unas decenas de árboles, la mejora se estabiliza.
Un detalle a tener en cuenta: la precisión de entrenamiento puede seguir subiendo porque cada árbol memoriza mejor, pero la de test se aplana. Eso confirma que el límite no lo pone el número de árboles, sino la diversidad del ensamble.
7 Importancia de variables
Una ventaja muy práctica de los bosques aleatorios es que miden, de forma gratuita, cuánto contribuye cada variable a las predicciones. La idea es contar cuánto baja la impureza (por ejemplo, la entropía o el Gini) cada vez que esa variable se usa para dividir, ponderado por el número de ejemplos en ese nodo, y promediar sobre todos los árboles. El resultado es la importancia de variables (feature_importances_).
La Figura 2 muestra este ranking sobre un conjunto de datos de vinos, donde cada variable es una medida química.
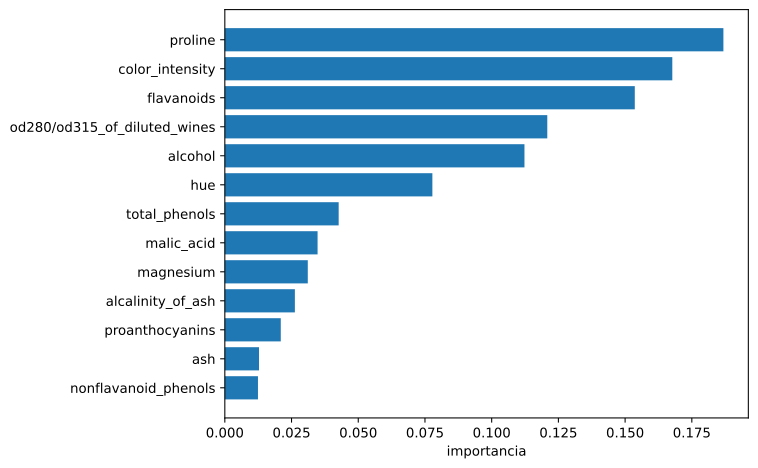
Figura 2: Importancia de las variables en un bosque aleatorio entrenado con datos de vinos (mayor barra = más influencia en la predicción).
Advertencia
La importancia de variables de un bosque puede dar pistas útiles, pero tiene trampas. Si dos variables están muy correlacionadas, el bosque suele repartir su importancia y ninguna aparece como “fuerte”. Además, tiende a favorecer variables con muchos valores distintos. Úsala como una sospecha inicial, no como una verdad definitiva.
8 Demo ejecutable
Como cierre, entrenamos un bosque aleatorio completo sobre un problema de clasificación real (datos de cáncer de mama, con 30 variables y dos clases). Dividimos en entrenamiento y test, y reportamos la precisión.
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier

datos = load_breast_cancer()
X_ent, X_prueba, y_ent, y_prueba = train_test_split(
    datos.data, datos.target, test_size=0.30, random_state=0, stratify=datos.target)

bosque = RandomForestClassifier(n_estimators=200, max_features="sqrt",
                                random_state=0)
bosque.fit(X_ent, y_ent)

print("Precisión en entrenamiento:", round(bosque.score(X_ent, y_ent), 4))
print("Precisión en test:", round(bosque.score(X_prueba, y_prueba), 4))

importancias = bosque.feature_importances_
top = np.argsort(importancias)[::-1][:5]
print("\nTop 5 variables más importantes:")
for i in top:
    print(f"  {datos.feature_names[i]}: {importancias[i]:.3f}")
Precisión en entrenamiento: 1.0
Precisión en test: 0.9532

Top 5 variables más importantes:
  worst radius: 0.133
  worst perimeter: 0.132
  worst concave points: 0.128
  worst area: 0.108
  mean concave points: 0.098
Con solo unas pocas líneas obtenemos un clasificador muy competitivo, sin necesidad de escalar las variables (los árboles no se ven afectados por la escala) ni de ajustar muchos hiperparámetros. El bosque aleatorio es, por tanto, una excelente línea base antes de probar modelos más complejos.
Bagging vs Boosting
El Random Forest usa bagging: muchos árboles fuertes entrenados en paralelo y promediados. Gradient Boosting usa boosting: árboles débiles entrenados secuencialmente, donde cada uno corrige los errores del anterior. En datos tabulares limpios, Gradient Boosting (XGBoost, LightGBM, CatBoost) suele superar a Random Forest en precisión, pero requiere más hiperparámetros.