Propagación hacia adelante: cálculo detallado capa a capa
Navegación en esta sección
Documento base: Matemáticas de la red neuronal — arquitectura y valores numéricos de una red neuronal totalmente conectada (MLP) 2→3→2→1.
Estás en Propagación hacia adelante (cálculo de \(z^{[l]}\) y \(a^{[l]}\) capa a capa). Cuando termines, continúa con Backpropagation (cálculo de los gradientes y actualización de parámetros).
1 La propagación hacia adelante
Empezamos por la primera neurona de la primera capa oculta. Recibe las dos entradas \(x_1, x_2\) a través de sus dos pesos, suma su sesgo y aplica la función de activación. La Figura 1 amplía esa región de la red.
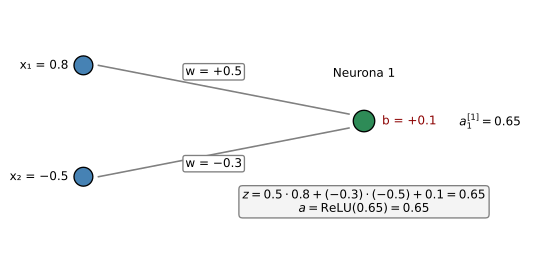
Figura 1: Zoom en la primera neurona de la capa oculta 1: recibe x₁ y x₂ con sus pesos, suma el sesgo y aplica la activación ReLU.
La operación de esa neurona es, letra a letra:
donde \(w^{[1]}_{11}=0.5\) es el peso que va de \(x_1\) a la neurona 1, y \(w^{[1]}_{12}=-0.3\) el que va de \(x_2\) a la misma neurona. Aplicamos entonces la ReLU (del inglés Rectified Linear Unit):
Como \(z^{[1]}_1 = 0.65 > 0\), la ReLU deja pasar el valor tal cual: la activación es simplemente \(0.65\). Si \(z\) hubiera sido negativo, la habría cortado a \(0\).
¿Por qué ReLU en las capas intermedias?
En general, para las capas ocultas (intermedias) la activación que mejor funciona es ReLU. Primero, es no lineal, condición imprescindible para que apilar capas tenga sentido (como vimos en la sección de intuición: varias capas lineales equivalen a una sola). Segundo, su derivada vale \(1\) para \(z>0\), así que el gradiente no se desvanece al propagarse por muchas capas (el problema del vanishing gradient que sí sufre la sigmoide). Tercero, es muy barata de calcular. Por eso la sigmoide y la \(\tanh\) suelen reservarse para otros usos: la sigmoide para la capa de salida en clasificación binaria (da una probabilidad) y la lineal para problemas de regresión.
La primera neurona produjo \(a^{[1]}_1=0.65\). Calculamos ahora, de forma rápida y todavía sin matrices, las otras dos neuronas de la capa oculta 1:
Por tanto, la primera capa oculta transmite \(a^{[1]}=(0.65,\,0,\,0)\). Continuamos con las dos neuronas de la capa oculta 2:
Finalmente, la neurona de salida aplica la sigmoide:
Este es el mismo resultado que veremos a continuación con matrices.
2 En forma de matriz: el mismo resultado, con menos líneas
Hasta ahora hemos calculado neurona a neurona. Pero hay una forma mucho más compacta de hacer exactamente lo mismo: ordenarlo todo en vectores columna y matrices y escribir la propagación como una única operación (una multiplicación de matrices más una suma) por capa. La regla que seguimos siempre es: la matriz de pesos va a la izquierda y el vector de entradas a la derecha.
La entrada, como vector columna, es
Capa oculta 1. Apilamos en una matriz \(W^{[1]}\in\mathbb{R}^{3\times 2}\) los pesos de las tres neuronas (una fila por neurona) y los sesgos en un vector columna \(b^{[1]}\):
Dimensión de la matriz QUARTOMATHINLINE00018TOKEN
La dimensión de la matriz \(W\) será de tantas filas como neuronas haya en su capa y tantas columnas como entradas tenga su capa, en este caso esta capa tiene tres neuronas y dos entradas. Por eso tiene una dimensión de 3 x 2.
El producto \(W^{[1]}x\) da, fila a fila, las mismas combinaciones \(w\cdot x\) que calculamos antes:
Sumamos el sesgo elemento a elemento y aplicamos la ReLU también elemento a elemento:
Son exactamente los \(z^{[1]}_1, z^{[1]}_2, z^{[1]}_3\) y \(a^{[1]}_1, a^{[1]}_2, a^{[1]}_3\) de antes.
Capa oculta 2. Ahora la entrada es la activación anterior y \(W^{[2]}\in\mathbb{R}^{2\times 3}\):
Capa de salida. Por pura coherencia, la escribimos igual: con \(W^{[3]}\in\mathbb{R}^{1\times 2}\), el sesgo como vector columna de un elemento \(b^{[3]} = [0.2]\), y la sigmoide como activación de salida:
Hemos llegado al mismo \(\hat{y}\approx 0.630\) de antes, pero con una sola operación por capa en lugar de un cálculo por neurona. Esta escritura vectorizada es la que utiliza en los algoritmos para mejorar la eficiencia en el cálculo.
3 Propagación con un lote completo de entradas
En el entrenamiento no procesamos de uno en uno, sino un lote (batch): muchos ejemplos a la vez. Para ello no cambia nada de lo anterior; simplemente apilamos los \(m\) vectores columna de entrada, uno por cada ejemplo, formando la matriz \(X\) de dimensiones \(\text{entradas}\times m\). Cada columna es un ejemplo.
Tomemos, por ejemplo, \(m=2\) ejemplos (el primero es el de antes):
La columna 1 es \(x^{(1)}=(0.8,-0.5)\) y la columna 2 es \(x^{(2)}=(1.0,0.2)\). Las fórmulas de cada capa son idénticas, solo que ahora \(X\) (y luego \(A\)) es una matriz cuya cada columna es un ejemplo:
donde sumar \(b^{[1]}\) significa sumarlo a todas las columnas por igual (se “reparte” a cada ejemplo). Hagámoslo:
Fíjate: la columna 1 de \(Z^{[1]}\) y de \(A^{[1]}\) es exactamente el ejemplo único que calculamos antes (\(0.65,-0.24,-0.58\) → \(0.65,0,0\)). Ha caído “gratis” la columna del segundo ejemplo. Continuamos igual para las siguientes capas:
Y la salida para el lote entero, de golpe. Manteniendo la coherencia, \(b^{[3]} = [0.2]\) es ahora un vector columna de longitud 1 que se suma a la fila resultado de \(W^{[3]}A^{[2]}\):
La primera columna de \(A^{[3]}\) vuelve a ser nuestro \(\hat{y}\approx 0.630\) de siempre, y la segunda da \(\approx 0.615\) para el segundo ejemplo. Cada columna es la predicción de un ejemplo del lote.
La clave es que \(WX\) multiplica la misma matriz de pesos por todas las columnas a la vez. Cuantas más columnas (más ejemplos) tenga el lote, más operaciones se hacen de una sola vez, y por eso los ordenadores (y las GPU) son tan rápidos entrenando en lotes: es la misma multiplicación de matrices de siempre, solo con matrices más grandes.
Siguiente paso
Con la predicción \(\hat{y}\) ya calculada, el siguiente paso es entrenar la red: ver cuánto se equivoca y ajustar pesos y sesgos. Eso se hace en Backpropagation, que parte de los mismos valores y de esta misma propagación. Si quieres volver a la arquitectura y los números, consulta Matemáticas de la red neuronal.
¿Por qué la salida se ve como una fila y no como una columna?
Puede parecer que la salida “va en fila” mientras las entradas “van en columna”, pero es una ilusión óptica: la regla es que las columnas son los ejemplos y las filas son las neuronas. La entrada \(X\) es \((2 \text{ neuronas} \times 2 \text{ ejemplos})\), así que se ve vertical. La salida \(A^{[3]}\) es \((1 \text{ neurona} \times 2 \text{ ejemplos})\), así que tiene una sola fila y se ve horizontal. Tiene 1 fila porque hay 1 neurona de salida, no porque las salidas “vayan en fila”; si hubiera 3 neuronas de salida sería una matriz \((3 \times 2)\) claramente vertical. Para convencerte, procesa un solo ejemplo: entonces todo es \((n \times 1)\), columnas de altura \(n\), todas “verticales”, como en la sección anterior.