Transferencia de Estilo Neuronal (NST) y Convoluciones 1D y 3D
Navegación en esta sección
Capítulos anteriores del bloque de Visión Artificial: 1. Redes neuronales convolucionales (CNN) — convolución, padding, pooling y LeNet-5. 2. Matemáticas de la capa convolucional — cálculo manual y backpropagation. 3. Arquitecturas clásicas y modernas de CNN — AlexNet, VGG, ResNet, Inception y MobileNet. 4. Práctica en Visión Artificial — Transfer Learning y Data Augmentation. 5. Detección de Objetos y YOLO — localización con cuadros delimitadores. 6. Segmentación Semántica y U-Net — máscaras píxel a píxel. 7. Reconocimiento Facial y Redes Siamesas — One-Shot Learning y Triplet Loss.
Estás en Transferencia de Estilo Neuronal y Convoluciones 1D/3D (creación artística mediante optimización de píxeles y extensión dimensional).
1 Introducción: El arte a través de las Redes Convolucionales
Una de las aplicaciones más sorprendentes y creativas del Deep Learning es la Transferencia de Estilo Neuronal (Neural Style Transfer - NST), introducida por Leon Gatys, Alexander Ecker y Matthias Bethge en 2015.
El objetivo de NST es tomar dos imágenes de entrada y sintetizar una tercera imagen completamente nueva:
- Imagen de Contenido (\(C\), Content): Una fotografía de la que queremos conservar la estructura espacial y los objetos representados (por ejemplo, una foto del campus universitario o de un paisaje urbano).
- Imagen de Estilo (\(S\), Style): Una obra pictórica de la que queremos extraer la textura, la paleta de colores y el trazo artístico (por ejemplo, La noche estrellada de Vincent van Gogh o una pintura cubista de Pablo Picasso).
- Imagen Generada (\(G\), Generated): La obra resultante que combina el contenido semántico de \(C\) con la expresión estética de \(S\).
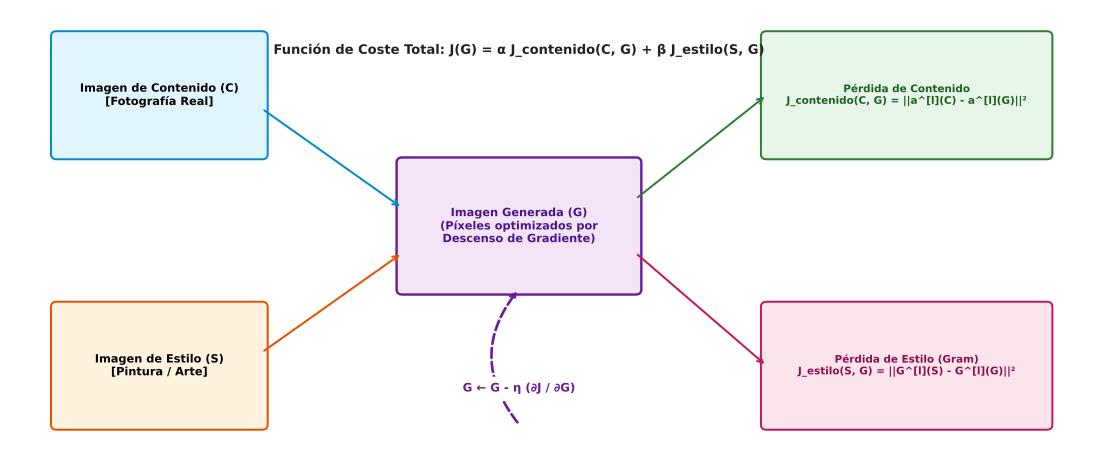
Figura 1: Esquema de Transferencia de Estilo Neuronal: la red VGG preentrenada se mantiene congelada; el descenso de gradiente actualiza directamente los píxeles de la imagen generada G para minimizar simultáneamente la pérdida de contenido y la de estilo.
2 Inversión del Paradigma: Optimizar Píxeles en lugar de Pesos
En el entrenamiento estándar de redes neuronales, las imágenes de entrada están fijas y el algoritmo de descenso de gradiente actualiza los pesos sinápticos (\(W, b\)) de la red.
En la transferencia de estilo neuronal, invertimos completamente el proceso:
- Utilizamos una red convolucional preentrenada (típicamente VGG19 preentrenada en ImageNet) y congelamos todos sus pesos. La red actúa como un extractor de representaciones fijo e inmutable.
- Inicializamos la imagen generada \(G\) como una matriz de ruido blanco gaussiano aleatorio.
- Definimos una función de coste total \(J(G)\) y calculamos su derivada parcial con respecto a los valores de los píxeles de \(G\) (\(\frac{\partial J}{\partial G}\)).
- Mediante descenso de gradiente (u optimizadores como L-BFGS), actualizamos directamente los píxeles de \(G\):
A lo largo de las iteraciones, el ruido blanco inicial se transforma progresivamente hasta que emerge la fotografía con el estilo pictórico deseado.
3 La Función de Coste de Contenido (\(J_{\text{contenido}}\))
¿Cómo sabe la red si la imagen generada \(G\) contiene los mismos objetos que la imagen de contenido \(C\)?
Para medir la discrepancia de contenido, pasamos tanto \(C\) como \(G\) por la red VGG preentrenada y comparamos sus mapas de activación en una capa intermedia \(l\), denotados como \(a^{[l](C)}\) y \(a^{[l](G)}\):
3.1 Elección de la capa \(l\)
- Si elegimos una capa muy superficial (ej.
conv1_1): Las neuronas solo detectan píxeles y bordes locales exactos, forzando a \(G\) a ser una copia fotocopia casi idéntica de \(C\) sin espacio para el estilo. - Si elegimos una capa excesivamente profunda (ej.
conv5_4): La red solo comprueba que existan conceptos de alto nivel («hay un perro en alguna parte»), perdiendo la silueta y la geometría exacta del objeto. - Elección óptima: Una capa intermedia (como
conv4_2en VGG19), que preserva la composición espacial y la forma de los objetos sin restringir los valores de los píxeles individuales.
4 La Función de Coste de Estilo (\(J_{\text{estilo}}\)) y la Matriz de Gram
Definir matemáticamente el “estilo” de un pintor (la textura de las pinceladas, el grano, el contraste de color) es un desafío. Gatys et al. propusieron una definición: el estilo de una imagen se define como la correlación espacial entre los diferentes canales de activación en una capa oculta \(l\).
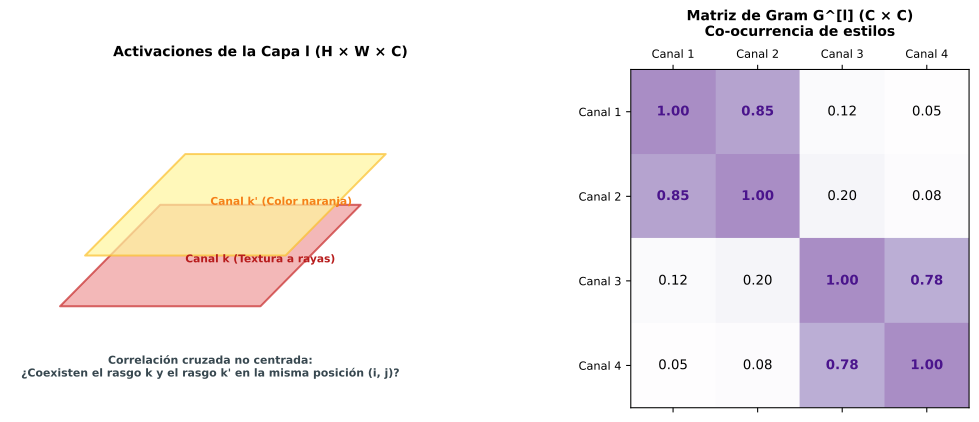
Figura 2: Significado intuitivo de la Matriz de Gram: mide la co-ocurrencia espacial entre diferentes detectores de rasgos (canales). Si el canal k (textura) y el canal k’ (color) se activan juntos en las mismas posiciones (i,j), su producto escalar en la matriz de Gram es elevado.
4.1 Definición de la Matriz de Gram (\(G^{[l]}\))
Supongamos que en la capa \(l\) el canal \(k\) detecta trazos ondulados y el canal \(k'\) detecta tonos amarillentos. La Matriz de Gram \(G^{[l]} \in \mathbb{R}^{n_C \times n_C}\) mide con qué frecuencia ambos rasgos aparecen juntos en las mismas coordenadas espaciales \((i, j)\):
- Si \(G_{kk'}^{[l]}\) es grande, significa que las ondulaciones y los tonos amarillos coexisten frecuentemente (rasgo distintivo del estilo de Van Gogh).
- Si \(G_{kk'}^{[l]}\) es cercano a cero, ambos patrones casi nunca aparecen en la misma posición.
4.2 Pérdida de estilo por capa y combinación multi-capa
Calculamos la matriz de Gram tanto para la imagen de estilo \(G^{[l](S)}\) como para la imagen generada \(G^{[l](G)}\). La pérdida de estilo en la capa \(l\) es la distancia de Frobenius normalizada entre ambas matrices:
Para capturar tanto el estilo fino (colores y bordes en capas tempranas) como el estilo grueso (texturas complejas en capas intermedias), la pérdida de estilo total es la suma ponderada de varias capas:
5 Función de Coste Total y Balance de Hiperparámetros
La función de coste global que minimizamos es la combinación convexa de ambas pérdidas:
- \(\alpha\): Controla el peso del contenido. Un valor elevado preserva fielmente los detalles fotográficos originales.
- \(\beta\): Controla la intensidad del estilo. Un valor elevado intensifica los trazos artísticos, colores y texturas de la pintura sobre la imagen final.
6 Generalización de Redes Convolucionales a Datos 1D y 3D
Hasta ahora hemos operado sobre imágenes bidimensionales (\(2\text{D}\)). Sin embargo, la operación de convolución es un concepto matemático universal aplicable a cualquier estructura de rejilla en \(1\text{D}\), \(2\text{D}\) o \(3\text{D}\).
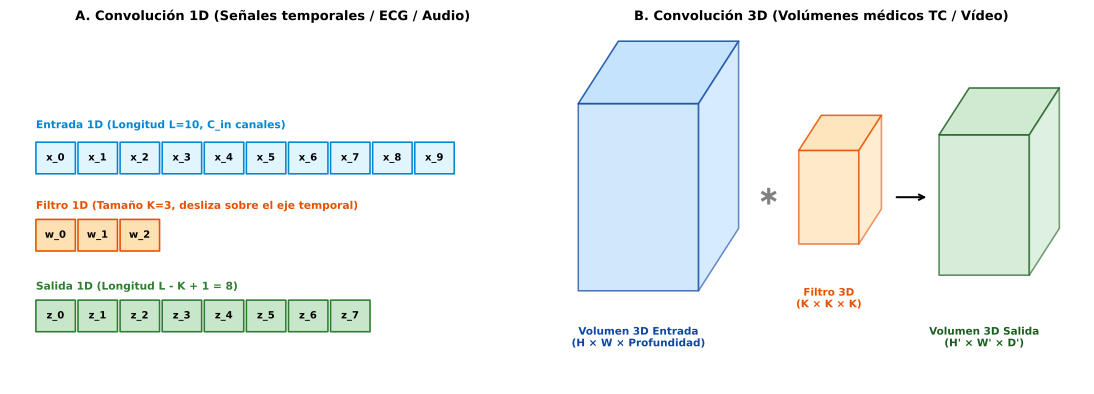
Figura 3: Generalización dimensional de las CNNs: A (izquierda), Convolución 1D para señales temporales unidimensionales (ECG, audio). B (derecha), Convolución 3D para volúmenes médicos (TC, RM) y secuencias de vídeo espacio-temporales.
6.1 1. Convoluciones 1D (Series temporales y Señales)
- Entrada: Una secuencia unidimensional de longitud \(L\) con \(C_{\text{in}}\) canales (ej. una señal de Electrocardiograma (ECG) con \(L=1000\) muestras temporales o señales de audio crudo).
- Filtro: Un vector \(1\text{D}\) de tamaño \(K \times C_{\text{in}}\) (por ejemplo, \(K=5\)).
- Mecánica: El filtro se desliza a lo largo del eje temporal, multiplicando elemento a elemento y sumando los productos.
- Ventaja: Invarianza temporal (capacidad de detectar una arritmia cardíaca independientemente del segundo exacto en que ocurra el latido).
6.2 2. Convoluciones 3D (Volúmenes médicos y Vídeo)
- Entrada: Un tensor tridimensional \(H \times W \times D\) (donde \(D\) puede ser la profundidad espacial de una Tomografía Computarizada / Resonancia Magnética 3D, o el número de fotogramas temporales en un clip de vídeo).
- Filtro: Un cubo de pesos \(K \times K \times K\) (por ejemplo, \(3 \times 3 \times 3\)).
- Mecánica: El filtro cúbico se desliza en las tres dimensiones simultáneamente (alto, ancho y profundidad temporal).
- Aplicaciones: Reconocimiento de acciones humanas en vídeo (Action Recognition), detección de tumores volumétricos en 3D y simulaciones de dinámica de fluidos.
7 Código interactivo en Python: Cálculo de Matriz de Gram y Convolución 1D/3D
El siguiente script en Python implementa la Matriz de Gram de estilo y demuestra operaciones convolucionales en 1D y 3D con NumPy:
import numpy as np

# 1. Cálculo de la Matriz de Gram para Transferencia de Estilo
def gram_matrix(activation_map):
    """
    activation_map: Tensor (H, W, C)
    Retorna matriz de Gram de dimensión (C, C)
    """
    H, W, C = activation_map.shape
    # Aplanamos la dimensión espacial H x W en un vector largo
    features = activation_map.reshape((H * W, C))
    # Matriz Gram = F^T * F
    G = np.dot(features.T, features)
    return G / (H * W * C)

# Simulamos activaciones de una capa intermedia (H=4, W=4, C=3)
np.random.seed(42)
act_S = np.random.uniform(0.1, 1.0, size=(4, 4, 3)) # Estilo
act_G = act_S + np.random.normal(0, 0.1, size=(4, 4, 3)) # Generada

G_S = gram_matrix(act_S)
G_G = gram_matrix(act_G)
style_loss = np.sum(np.square(G_S - G_G))

print("=" * 60)
print("1. MATRIZ DE GRAM Y PÉRDIDA DE ESTILO")
print("=" * 60)
print("Matriz de Gram de Estilo G^[l](S) (3×3):\n", np.round(G_S, 4))
print(f"\nPérdida de Estilo J_estilo(S, G): {style_loss:.6f}\n")

# 2. Demostración de Convolución 1D
def conv1d_valid(signal, kernel):
    L = len(signal)
    K = len(kernel)
    out_len = L - K + 1
    out = np.zeros(out_len)
    for i in range(out_len):
        out[i] = np.sum(signal[i:i+K] * kernel)
    return out

signal_ecg = np.array([0.1, 0.2, 1.5, -0.8, 0.3, 0.2, 0.1])
kernel_ecg = np.array([0.5, 1.0, 0.5])
out_1d = conv1d_valid(signal_ecg, kernel_ecg)

print("=" * 60)
print("2. CONVOLUCIÓN 1D (SEÑALES / ECG)")
print("=" * 60)
print("Señal 1D (Longitud 7): ", signal_ecg)
print("Filtro 1D (Tamaño 3):   ", kernel_ecg)
print("Salida 1D (Longitud 5): ", np.round(out_1d, 3))
============================================================
1. MATRIZ DE GRAM Y PÉRDIDA DE ESTILO
============================================================
Matriz de Gram de Estilo G^[l](S) (3×3):
 [[0.105  0.0795 0.0871]
 [0.0795 0.1118 0.0848]
 [0.0871 0.0848 0.1052]]

Pérdida de Estilo J_estilo(S, G): 0.000300

============================================================
2. CONVOLUCIÓN 1D (SEÑALES / ECG)
============================================================
Señal 1D (Longitud 7):  [ 0.1  0.2  1.5 -0.8  0.3  0.2  0.1]
Filtro 1D (Tamaño 3):    [0.5 1.  0.5]
Salida 1D (Longitud 5):  [ 1.   1.2  0.1 -0.   0.4]