Redes Neuronales Recurrentes (RNN): De las secuencias a la memoria a largo plazo
Navegación en esta sección
Capítulos anteriores: - Redes neuronales convolucionales (CNN) — convolución, padding, pooling y LeNet-5. - Arquitecturas clásicas y modernas de CNN — AlexNet, VGG, ResNet, Inception y MobileNet.
Estás en Redes Neuronales Recurrentes (RNN) (procesamiento de secuencias, GRU, LSTM, redes bidireccionales y redes profundas).
1 Introducción a los modelos de secuencia
Hemos visto cómo las redes convolucionales procesan imágenes extrayendo patrones espaciales. Sin embargo, muchos problemas del mundo real implican datos secuenciales, donde el orden importa: texto, audio, series temporales, ADN o vídeo.
Los modelos de secuencia pueden resolver una gran variedad de problemas:
| Problema | Entrada (\(x\)) | Salida (\(y\)) | Tipo |
|---|---|---|---|
| Reconocimiento de voz | Clip de audio | Transcripción de texto | Muchos → Muchos |
| Generación de música | Género o primera nota | Secuencia de notas | Uno → Muchos |
| Clasificación de sentimientos | Reseña de texto | Puntuación (1-5 estrellas) | Muchos → Uno |
| Traducción automática | Frase en español | Frase en inglés | Muchos → Muchos (longitudes distintas) |
| Reconocimiento de entidades | Oración | Etiqueta por palabra | Muchos → Muchos |
| Análisis de ADN | Secuencia de bases (A,C,G,T) | Etiquetas funcionales | Muchos → Muchos |
2 Notación básica
Para construir modelos de secuencia, establezcamos una notación clara. Tomemos como ejemplo el reconocimiento de entidades nombradas: identificar nombres de personas, empresas o lugares en un texto.
Oración: “María García trabaja en Google desde Madrid.”
- Entrada (\(x\)): Secuencia de palabras indexadas por posición \(t\):
- \(x^{<1>} = \text{María}\), \(x^{<2>} = \text{García}\), \(\dots\), \(x^{<6>} = \text{Madrid}\)
- Salida (\(y\)): Secuencia de etiquetas binarias (¿es parte de un nombre?):
- \(y^{<1>} = 1\), \(y^{<2>} = 1\), \(y^{<3>} = 0\), \(y^{<4>} = 0\), \(y^{<5>} = 1\), \(y^{<6>} = 1\)
- Longitudes: \(T_x = 6\) (entrada), \(T_y = 6\) (salida). En otros problemas pueden diferir.
2.1 Representación One-Hot de las palabras
Para que la red procese las palabras, se crea un vocabulario con las palabras más comunes del corpus (típicamente \(10.000\) a \(100.000\) palabras). Cada palabra se representa como un vector one-hot: un vector de ceros con un \(1\) en la posición correspondiente al índice de la palabra en el vocabulario.
Por ejemplo, si “García” ocupa la posición 3890 de un vocabulario de 10.000 palabras:
Las palabras desconocidas se representan con un token especial <UNK> (unknown).
Hay que tener en cuenta que las representaciones one-hot presentan limitaciones importantes y no son el estándar en los sistemas de procesamiento de lenguaje natural actuales:
- La primera limitación es la maldición de la dimensionalidad y la dispersión (sparsity). Con vocabularios de decenas o cientos de miles de palabras, cada vector es enorme y está compuesto casi en su totalidad por ceros, lo que desperdicia memoria y recursos de cómputo.
- La segunda y más importante es la ausencia de relación semántica. En una representación one-hot, cualquier par de palabras es ortogonal: el producto punto entre el vector de “gato” y el de “perro” es exactamente cero, al igual que entre “gato” y “nevera”. El modelo no puede deducir de forma innata que dos palabras comparten un significado o categoría similar.
En realidad las palabras se representan mediante embeddings densos (como Word2Vec o GloVe) o las representaciones contextuales modernas (como las de los Transformers o BERT), donde las palabras se mapean a espacios continuos de menor dimensión (por ejemplo, 300 o 768 dimensiones) y los conceptos cercanos geográficamente en ese espacio comparten similitudes de significado.
3 Arquitectura de una Red Neuronal Recurrente (RNN)
Una red neuronal estándar no es adecuada para secuencias por dos razones:
- Longitud variable: Las secuencias tienen distinto número de elementos entre ejemplos.
- Sin compartición de parámetros
Una Red Neuronal Recurrente (RNN) resuelve ambos problemas procesando la secuencia paso a paso y compartiendo los mismos parámetros en cada instante temporal.
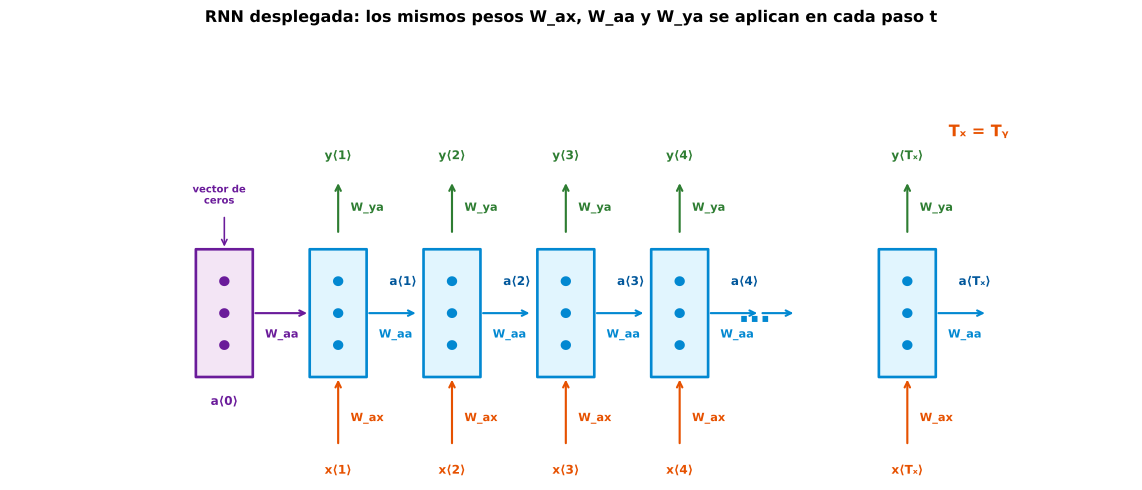
Figura 1: RNN desplegada en el tiempo (muchos-a-muchos, Tx = Ty): en cada paso temporal t la red recibe la entrada x⟨t⟩ (con pesos W_ax), combina la activación anterior a⟨t-1⟩ (con pesos W_aa) y produce la salida ŷ⟨t⟩ (con pesos W_ya). Los tres pesos son idénticos en todos los pasos (compartición de parámetros).
3.0.1 Las tres matrices de pesos
En cada paso de tiempo \(t\), la RNN utiliza tres matrices de pesos que son idénticas en todos los pasos:
| Matriz | Dimensiones | Función |
|---|---|---|
| \(W_{ax}\) | \((n_a \times n_x)\) | Conecta la entrada \(x^{<t>}\) con la capa oculta |
| \(W_{aa}\) | \((n_a \times n_a)\) | Conecta la activación anterior \(a^{<t-1>}\) con la actual |
| \(W_{ya}\) | \((n_y \times n_a)\) | Conecta la activación oculta \(a^{<t>}\) con la salida \(\hat{y}^{<t>}\) |
Donde:
- \(n_x\) = dimensión de la entrada (por ejemplo, 10.000 si usamos one-hot para un vocabulario de 10.000 palabras)
- \(n_a\) = dimensión de la capa oculta (hiperparámetro, por ejemplo 128)
- \(n_y\) = dimensión de la salida (por ejemplo, 1 para clasificación binaria)
¿Por qué tres matrices distintas?
Cada matrix tiene un papel diferente:
- \(W_{ax}\): “¿qué información nueva llega de la entrada?”
- \(W_{aa}\): “¿qué información conservo del paso anterior?”
- \(W_{ya}\): “¿cómo transformo la memoria interna en una predicción?”
Ventaja de compartir pesos: Si la secuencia tiene 100 palabras, en lugar de tener \(100 \times 3 = 300\) matrices distintas, solo tenemos 3 matrices que se reutilizan. Esto reduce drásticamente el número de parámetros y permite que la red generalice a secuencias de longitud arbitraria.
3.0.2 RNN desplegada en el tiempo
Si dibujamos la RNN paso a paso, vemos cómo cada instante temporal se conecta con el siguiente. Los mismos pesos se comparten en cada paso:
3.1 Propagación hacia adelante (Forward Pass)
En cada paso de tiempo \(t\), la RNN calcula:
donde:
- \(g_1\): activación oculta (típicamente \(\tanh\) o ReLU).
- \(g_2\): activación de salida (Sigmoide para binaria, Softmax para multiclase).
- \(a^{<0>}\): vector de ceros (inicialización).
Parámetros compartidos: Las matrices \(W_{aa}\), \(W_{ax}\), \(W_{ya}\) y los vectores \(b_a\), \(b_y\) son idénticos en todos los pasos de tiempo. Esto permite que la red aplique el mismo “detector de patrones” sin importar la posición en la secuencia.
3.1.1 Ejemplo numérico: forward pass paso a paso
Consideremos una RNN con las siguientes dimensiones:
- Entrada: \(x^{<t>} \in \mathbb{R}^2\) (vectores de 2 dimensiones)
- Estado oculto: \(a^{<t>} \in \mathbb{R}^3\) (vectores de 3 dimensiones)
- Salida: \(\hat{y}^{<t>} \in \mathbb{R}^1\) (escalar)
Los pesos y sesgos son:
La activación oculta es \(\tanh\) y la de salida es sigmoide \(\sigma(z) = \frac{1}{1+e^{-z}}\).
Paso 1 (\(t=1\)): La entrada es \(x^{<1>} = \begin{bmatrix} 1.0 \\ 0.5 \end{bmatrix}\) y \(a^{<0>} = \begin{bmatrix} 0 \\ 0 \\ 0 \end{bmatrix}\)
Paso 2 (\(t=2\)): La entrada es \(x^{<2>} = \begin{bmatrix} -0.5 \\ 1.0 \end{bmatrix}\)
Resumen del forward pass:
| Paso \(t\) | \(x^{<t>}\) | \(a^{<t-1>}\) | \(a^{<t>}\) | \(\hat{y}^{<t>}\) |
|---|---|---|---|---|
| 1 | \([1.0, 0.5]\) | \([0, 0, 0]\) | \([0.46, 0.05, 0.29]\) | 0.64 |
| 2 | \([-0.5, 1.0]\) | \([0.46, 0.05, 0.29]\) | \([0.383, 0.594, -0.571]\) | 0.506 |
Observa cómo \(a^{<1>}\) (la “memoria” del paso 1) influye en el cálculo de \(a^{<2>}\) a través de \(W_{aa}\). La red ya tiene contexto del paso anterior.
3.1.2 Retropropagación en el mismo ejemplo
Supongamos que los valores verdaderos son \(y^{<1>} = 1.0\) y \(y^{<2>} = 0.0\). Usamos la pérdida de entropía cruzada binaria: \(\mathcal{L} = -[y \log(\hat{y}) + (1-y) \log(1-\hat{y})]\).
Con sigmoide + entropía cruzada, el gradiente simplifica a:
Gradientes en el paso 2 (el más reciente):
El gradiente respecto a \(W_{ya}\):
Gradientes de la capa oculta en el paso 2:
El error se propaga hacia atrás a través de \(W_{ya}\):
La derivada de \(\tanh\) es \((1 - (a^{<t>})^2)\):
Gradientes de \(W_{aa}\) y \(W_{ax}\) en el paso 2:
Gradientes en el paso 1 (el más antiguo):
El error llega desde el paso 2 a través de \(W_{aa}\):
Este gradiente se suma al gradiente propio del paso 1:
Gradiente total de \(W_{ya}\) (suma de ambos pasos):
Resumen del backward pass:
| Gradiente | Paso 2 (directo) | Paso 1 (desde paso 2) | Total |
|---|---|---|---|
| \(\partial \mathcal{L}/\partial W_{ya}\) | \([0.194, 0.300, -0.289]\) | \([-0.166, -0.018, -0.104]\) | \([0.028, 0.282, -0.393]\) |
| \(\partial \mathcal{L}/\partial W_{aa}\) | directo en \(t=2\) | a través de \(a^{<2>} \to a^{<1>}\) | suma |
Observa cómo el gradiente de \(W_{aa}\) en el paso 1 recibe contribuciones desde el paso 2. Esto es el BPTT en acción: los pesos se actualizan considerando su efecto a lo largo de toda la secuencia.
3.2 ¿Por qué es computacionalmente costoso?
En una secuencia de \(T_x\) pasos, calcular todos los gradientes requiere recorrer la cadena completa \(T_x\) veces hacia atrás. Si \(T_x = 100\), el coste computacional es \(\mathcal{O}(T_x)\) veces mayor que una red feedforward equivalente. Por eso las RNN son lentas de entrenar con secuencias largas.
3.3 Truncamiento en la práctica (Truncated BPTT)
Para secuencias muy largas (por ejemplo, un libro completo), se usa BPTT truncado: se divide la secuencia en bloques de longitud fija \(k\) y se aplica BPTT solo dentro de cada bloque. Los gradientes no se propagan más allá de \(k\) pasos:
- Ventaja: coste computacional constante por bloque.
- Desventaja: la red no puede aprender dependencias más largas que \(k\) pasos.
En la práctica, \(k\) se elige como un hiperparámetro (típicamente entre 50 y 200 pasos).
4 Tipos de arquitecturas RNN
Las RNN pueden adaptarse a distintas relaciones entre entrada y salida:
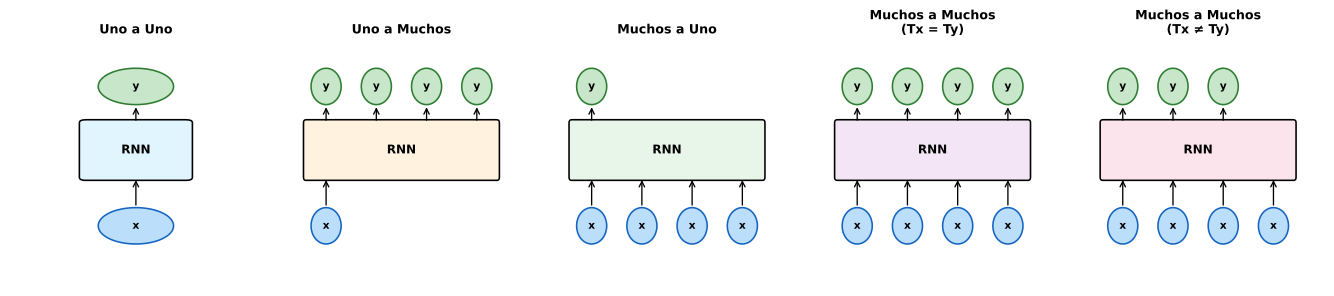
Figura 2: Los 5 tipos de arquitecturas RNN: Uno a Uno (estándar), Uno a Muchos (generación), Muchos a Uno (clasificación), Muchos a Muchos con Tx=Ty (etiquetado) y Muchos a Muchos con Tx≠Ty (codificador-decodificador).
4.0.1 ¿Cómo generan secuencias las RNN?
En las arquitecturas que generan secuencias (Uno a Muchos y Muchos a Muchos con \(T_x \neq T_y\)), la salida de un paso se usa como entrada del siguiente. Este es el mecanismo clave: la red “se alimenta de sus propias predicciones” para ir construyendo la secuencia.
Veámoslo con un ejemplo concreto de Uno a Muchos — generación de una descripción de imagen (image captioning):
Entrada única: Una imagen de un perro en la playa.
| Paso \(t\) | Entrada de la RNN | Salida \(\hat{y}^{<t>}\) |
|---|---|---|
| 1 | Imagen + <START> |
“Un” |
| 2 | “Un” | “perro” |
| 3 | “perro” | “corriendo” |
| 4 | “corriendo” | “en” |
| 5 | “en” | “la” |
| 6 | “la” | “playa” |
| 7 | “playa” | <EOS> |
La predicción de cada paso (\(\hat{y}^{<t>}\)) se convierte en la entrada del paso siguiente (\(x^{<t+1>}\)). La red va “escribiendo” la secuencia palabra a palabra.
¿Cuándo se usa este mecanismo?
| Arquitectura | ¿La salida se usa como entrada? | Ejemplo |
|---|---|---|
| Uno a Muchos | Sí — genera la secuencia paso a paso | Describir una imagen |
| Muchos a Muchos (\(T_x = T_y\)) | No — cada salida es independiente | Etiquetado POS (cada palabra se etiqueta por separado) |
| Muchos a Muchos (\(T_x \neq T_y\)) | Sí — el decodificador genera la salida paso a paso | Traducción automática |
| Muchos a Uno | No — solo importa la salida final | Clasificación de sentimientos |
En resumen: el mecanismo de “alimentarse de las propias predicciones” se usa cuando la red tiene que generar una secuencia. Cuando solo necesita producir una única clasificación o una etiqueta por cada entrada, las salidas son independientes y no se reutilizan.
4.0.2 Los 5 tipos de arquitecturas
- Uno a Uno (One-to-One): Red neuronal estándar (no recurrente). Una entrada produce una salida.
- Uno a Muchos (One-to-Many): Una entrada genera una secuencia. Ejemplo: describir una imagen (“Un perro corriendo en la playa”).
- Muchos a Uno (Many-to-One): Una secuencia produce una única salida. Ejemplo: clasificación de sentimientos de un texto.
- Muchos a Muchos (\(T_x = T_y\)): Secuencia de entrada y salida con la misma longitud. Ejemplo: reconocimiento de entidades nombradas (etiquetar cada palabra de una oración).
- Muchos a Muchos (\(T_x \neq T_y\)): Secuencias de distinta longitud. Ejemplo: traducción automática. Se divide en un codificador (Encoder) que lee la entrada y un decodificador (Decoder) que genera la salida paso a paso.
5 Modelado del lenguaje con RNN
El modelado del lenguaje es una tarea fundamental en procesamiento de lenguaje natural (NLP). Un modelo de lenguaje estima la probabilidad de que una secuencia de palabras ocurra.
5.1 Entrenamiento
- Tokenización: Se crea un vocabulario con las palabras más comunes. Se añaden tokens especiales:
<EOS>(fin de oración) y<UNK>(palabra desconocida). - Predicción de la siguiente palabra: La RNN se entrena para predecir \(y^{<t>}\) dado \(x^{<1>}, \dots, x^{<t-1>}\).
- Función de pérdida: Entropía cruzada Softmax en cada paso de tiempo. La pérdida total es la suma de las pérdidas individuales.
5.2 Probabilidad de una oración
Una vez entrenado, la probabilidad de una oración completa \((y^{<1>}, y^{<2>}, \dots, y^{<T>})\) se calcula como el producto de las probabilidades condicionales:
5.3 Muestreo de secuencias
Para generar texto nuevo a partir de un modelo entrenado:
- Se introduce una entrada nula (vector de ceros) y se muestrea la primera palabra de la distribución Softmax.
- La palabra muestreada se usa como entrada del siguiente paso.
- Se repite hasta generar el token
<EOS>o alcanzar un límite de longitud.
En lugar de elegir siempre la palabra más probable (búsqueda codiciosa, que genera texto repetitivo), se muestrea aleatoriamente de la distribución de probabilidades, introduciendo diversidad en el texto generado.
6 El problema de los gradientes desvanecientes
Una RNN que procesa una secuencia de 50 palabras es, en esencia, una red profunda de 50 capas. Al aplicar retropropagación, el gradiente se multiplica repetidamente por las matrices de pesos en cada paso temporal:
6.1 Dependencias a corto vs. largo plazo
Para entender el problema, comparemos dos frases:
- Dependencia a corto plazo: “Me gusta jugar al cricket.”
- Para predecir “cricket”, el modelo solo necesita las palabras inmediatamente anteriores (“Me gusta jugar”). La RNN básica captura esto sin dificultad.
- Dependencia a largo plazo: “Hola, mi nombre es Krish. Me gustan los deportes como el cricket, el voleibol y el ajedrez. También me gusta hacer videos.”
- Para predecir “videos”, el modelo debe recordar “hacer” y “me gusta”, que aparecen mucho antes. La RNN básica no puede mantener este contexto.
6.2 ¿Por qué se desvanece el gradiente?
Cada término \(\frac{\partial a^{<t>}}{\partial a^{<t-1>}}\) en el producto contiene la derivada de la función de activación. Los rangos de estas derivadas son:
| Activación | Rango de la derivada |
|---|---|
| Sigmoide \(\sigma(z)\) | \((0, \; 0.25]\) |
| \(\tanh(z)\) | \((0, \; 1]\) |
Al multiplicar 50 o más de estos valores decimales entre sí, el resultado converge exponencialmente a cero:
Consecuencia práctica: Los pesos de las palabras iniciales (en \(t=1\)) reciben un gradiente casi nulo, por lo que apenas se actualizan. El modelo “olvida” las palabras del inicio de la secuencia.
6.3 Soluciones al problema
- Cambiar la función de activación: Usar ReLU o Leaky ReLU, cuyas derivadas son constantes (\(1\) o un valor pequeño) y no se multiplican hacia cero.
- Arquitecturas con puertas: La solución más efectiva son las GRU y LSTM, que introducen mecanismos de memoria que permiten que el gradiente fluya sin desvanecerse a través de muchos pasos temporales.
Para entender cómo funcionan estos modelos, debemos considerar que una Red Neuronal Recurrente (RNN) procesa la información de forma secuencial, recibiendo entradas y generando salidas en cada paso de tiempo \(t\).
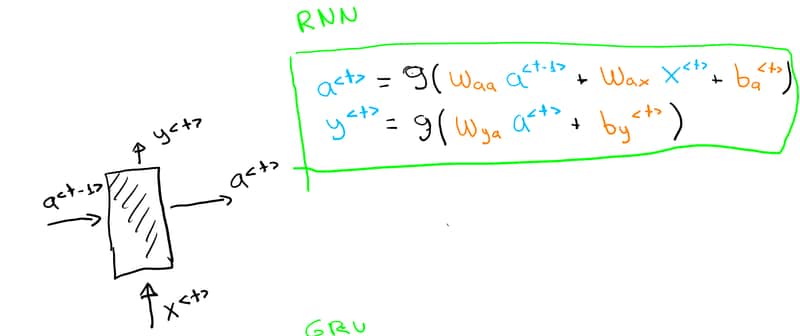
Figura 3: .
En cada paso \(t\), la red recibe dos elementos principales: la entrada actual (\(x^{<t>}\)) y la activación o estado oculto del paso anterior (\(a^{<t-1>}\)). Con esto, calcula la salida correspondiente (\(y^{<t>}\)) y genera la activación para el siguiente paso (\(a^{<t>}\)).
Un aspecto clave de esta arquitectura es que los parámetros (las matrices de pesos y los vectores de sesgo) se comparten y son exactamente los mismos en cada uno de los pasos temporales, lo que permite a la red procesar secuencias de cualquier longitud manteniendo un número fijo de parámetros.
7 GRU (Gated Recurrent Unit): Solución al gradiente desvaneciente
La Unidad Recurrente Cerrada (GRU) introduce un mecanismo de celda de memoria con puertas que controlan el flujo de información, permitiendo que la red “recuerde” durante muchos pasos de tiempo.
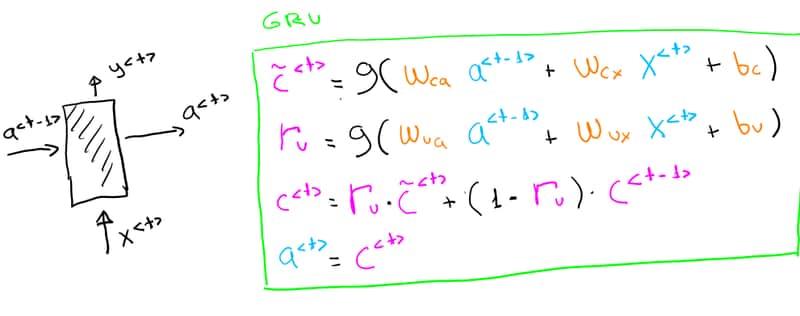
Figura 4: .
Interpretación: Si \(\Gamma_u \approx 0\), la celda mantiene su valor anterior (\(c^{<t>} \approx c^{<t-1>}\)), permitiendo que la información se preserve durante muchos pasos. Si \(\Gamma_u \approx 1\), la celda se actualiza completamente con el nuevo candidato. La puerta \(\Gamma_u\) decide qué recordar y qué olvidar.
7.0.1 El papel de \(\Gamma_u = 0\)
La clave está en los pasos intermedios. Si \(\Gamma_u = 0\) en la ecuación:
La celda de memoria se copia a sí misma de un paso al siguiente. La información sobre “singular” viaja intacta a través de decenas de pasos, sin importar las palabras intermedias (“which already ate …”).
7.0.2 ¿Por qué esto evita el gradiente desvaneciente?
Cuando \(\Gamma_u \approx 0\), la derivada de \(c^{<t>}\) respecto a \(c^{<t-1>}\) es aproximadamente \(1\):
En la retropropagación, multiplicar por \(1\) no reduce el gradiente. Así, el gradiente puede fluir sin desvanecerse a través de muchos pasos temporales, llegando a la palabra “cat” inicial con fuerza suficiente para actualizar los pesos.
7.1 GRU completa: puerta de relevancia
La GRU completa añade una puerta de relevancia (\(\Gamma_r\)) que filtra qué partes del estado anterior son relevantes para calcular el nuevo candidato:
8 LSTM (Long Short-Term Memory): Memoria a corto y largo plazo
La Unidad de Memoria a Corto y Largo Plazo (LSTM), propuesta por Hochreiter y Schmidhuber (1997), es más potente que la GRU. La diferencia clave es que la LSTM mantiene separados el estado de la celda de memoria (\(c^{<t>}\)) y la activación oculta (\(a^{<t>}\)), y utiliza tres puertas en lugar de dos.
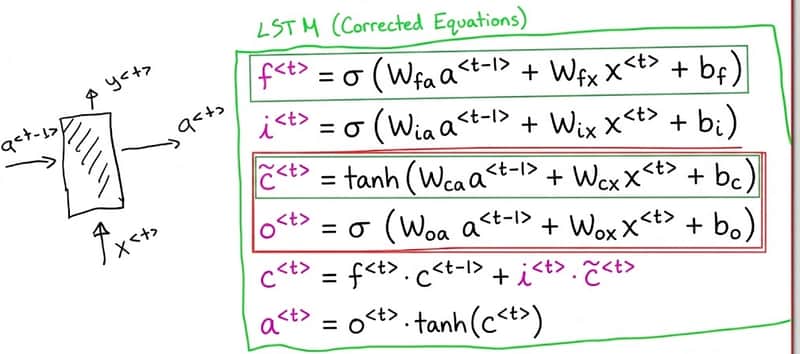
Figura 5: .
8.1 Arquitectura de una celda LSTM (Long Short-Term Memory)
Las Redes Neuronales Recurrentes estándar sufren de problemas de desvanecimiento o explosión del gradiente cuando intentan recordar información a largo plazo en secuencias extensas. Las LSTM se diseñaron específicamente para resolver este inconveniente mediante un estado de celda (\(c^{<t>}\)) que actúa como una “cinta transportadora” y un sistema de puertas reguladas por funciones sigmoides (\(\sigma\)).
Las operaciones que ocurren en cada paso de tiempo \(t\) se dividen en las siguientes fases:
- Puerta de olvido (\(f^{<t>}\)): Decide qué información del estado anterior de la celda (\(c^{<t-1>}\)) debe descartarse o conservarse. Utiliza una función sigmoide, por lo que sus valores oscilan entre \(0\) (olvidar por completo) y \(1\) (mantener intacto).
- Puerta de actualización o entrada (\(i^{<t>}\)): Determina qué partes de la nueva información de entrada deben añadirse al estado de la celda.
- Candidato a la celda de memoria (\(\tilde{c}^{<t>}\)): Calcula un vector de nuevos valores candidatos utilizando una función \(\tanh\), los cuales podrían añadirse al estado de la celda.
- Actualización del estado de la celda (\(c^{<t>}\)): Combina la información anterior olvidada y la nueva entrada ponderada por sus respectivas puertas para formar el estado actual de la celda.
- Puerta de salida (\(o^{<t>}\)): Filtra el estado de la celda actualizado para decidir qué porción de este se convertirá en la activación oculta final (\(a^{<t>}\)), la cual se enviará como salida del paso actual y como entrada para el siguiente paso temporal.
8.2 GRU vs. LSTM
| Característica | GRU | LSTM |
|---|---|---|
| Puertas | 2 (actualización, relevancia) | 3 (olvido, entrada, salida) |
| Estado | \(c^{<t>} = a^{<t>}\) (mismo vector) | \(c^{<t>}\) y \(a^{<t>}\) separados |
| Complejidad | Menor, más rápida de entrenar | Mayor, más flexible |
| Rendimiento | Similar en muchas tareas | Ligeramente superior en tareas complejas |
| Uso típico | Cuando se necesita eficiencia | Elección por defecto en la mayoría de problemas |
9 Redes Neuronales Recurrentes Bidireccionales (BRNN)
Hemos visto que las RNN procesan la información de izquierda a derecha, considerando únicamente el contexto de las palabras anteriores. Sin embargo, en muchas tareas de NLP, la información del futuro es crucial para entender el contexto presente.
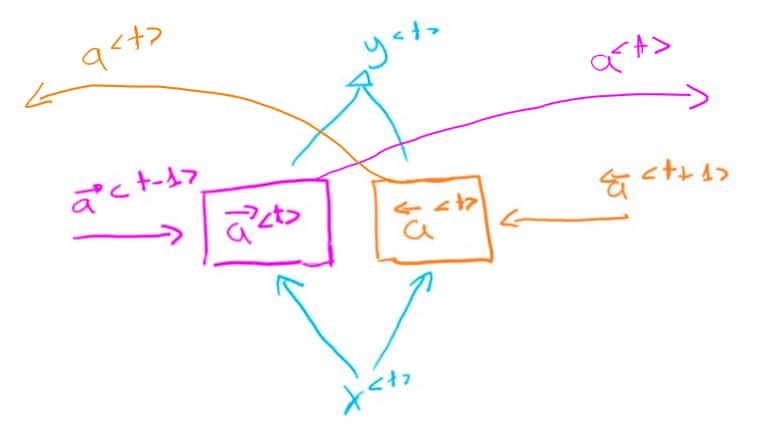
Figura 6: .
9.1 ¿Por qué necesitamos mirar hacia atrás?
Consideremos la frase:
“A Krish le gusta comer ____ en Bangalore.”
Si la RNN solo ve las palabras anteriores (“Krish”, “le gusta”, “comer”), podría predecir “pizza”, “hamburguesa” o “sushi”. Pero si conoce la palabra “Bangalore” (que aparece después), podría predecir “dosa”, un plato muy famoso de esa ciudad india.
Otro ejemplo clásico: en “He said, Teddy Roosevelt was a great president”, para saber si “Teddy” es parte de un nombre de persona, necesitamos ver “Roosevelt” que aparece después.
9.2 Arquitectura de una BRNN
Una Red Neuronal Recurrente Bidireccional (BRNN) se compone de dos redes independientes que procesan la misma secuencia:
- Red hacia adelante (\(\overrightarrow{a}^{<t>}\)): Procesa de izquierda a derecha. Captura el contexto del pasado.
- Red hacia atrás (\(\overleftarrow{a}^{<t>}\)): Procesa de derecha a izquierda. Captura el contexto del futuro.
En cada paso de tiempo \(t\), los estados ocultos de ambas redes se concatenan para producir la predicción:
Esta combinación garantiza que cada predicción se beneficia del contexto completo: información tanto del pasado como del futuro.
Consideraciones: - Las celdas de cada capa pueden ser RNN estándar, GRU o LSTM. En la práctica, BRNN con LSTM es la combinación más utilizada en NLP. - Requiere que la secuencia completa esté disponible antes de hacer predicciones (no es adecuada para streaming en tiempo real, como reconocimiento de voz en vivo).
10 Redes Neuronales Recurrentes Profundas (Deep RNNs)
Para problemas complejos, podemos apilar múltiples capas de RNN verticalmente, creando una Red Neuronal Recurrente Profunda.
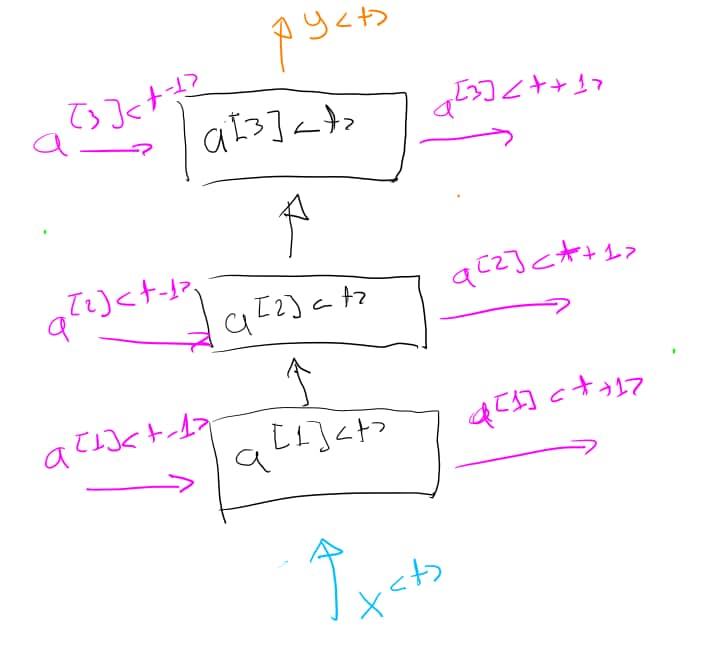
Figura 7: .
En cada paso de tiempo \(t\), la activación de la capa \(l\) se calcula a partir de: - La activación de la capa anterior en el mismo tiempo: \(a^{<t>[l-1]}\) - La activación de la misma capa en el tiempo anterior: \(a^{<t-1>[l]}\)
Consideraciones prácticas: - Las RNN profundas suelen tener 2-3 capas recurrentes (no más de 3, por el coste computacional de la dimensión temporal). - A veces, las capas recurrentes se limitan a las primeras capas, y las activaciones pasan a capas densas convencionales para la predicción final. - Los bloques pueden ser RNN estándar, GRU o LSTM. También se pueden construir BRNN profundas apilando capas bidireccionales.
11 Código interactivo en Python: Forward pass de una RNN simple
import numpy as np

# Datos de ejemplo: 3 palabras, vocabulario de 5 palabras
# x<1>=[1,0,0,0,0], x<2>=[0,1,0,0,0], x<3>=[0,0,1,0,0]
X = np.array([
    [1, 0, 0, 0, 0],  # "el"
    [0, 1, 0, 0, 0],  # "gato"
    [0, 0, 1, 0, 0],  # "negro"
], dtype=float)

# Dimensiones
n_x = 5   # vocabulario
n_a = 4   # activaciones ocultas
n_y = 5   # salida (vocabulario)

# Inicialización de pesos
np.random.seed(42)
W_ax = np.random.randn(n_a, n_x) * 0.01
W_aa = np.random.randn(n_a, n_a) * 0.01
W_ya = np.random.randn(n_y, n_a) * 0.01
b_a = np.zeros((n_a, 1))
b_y = np.zeros((n_y, 1))

def softmax(z):
    e = np.exp(z - np.max(z))
    return e / np.sum(e)

# Forward pass
a_prev = np.zeros((n_a, 1))
T_x = X.shape[0]

print("=" * 50)
print("FORWARD PASS DE UNA RNN SIMPLE")
print("=" * 50)

for t in range(T_x):
    x_t = X[t].reshape(-1, 1)
    a_t = np.tanh(W_ax @ x_t + W_aa @ a_prev + b_a)
    y_t = softmax(W_ya @ a_t + b_y)

    print(f"\nPaso t={t+1}:")
    print(f"  x⟨{t+1}⟩ = {X[t].tolist()}")
    print(f"  a⟨{t+1}⟩ = {a_t.flatten().round(4).tolist()}")
    print(f"  ŷ⟨{t+1}⟩ = {y_t.flatten().round(4).tolist()}")
    print(f"  Palabra predicha: posición {np.argmax(y_t)}")

    a_prev = a_t
==================================================
FORWARD PASS DE UNA RNN SIMPLE
==================================================

Paso t=1:
  x⟨1⟩ = [1.0, 0.0, 0.0, 0.0, 0.0]
  a⟨1⟩ = [0.005, -0.0023, -0.0046, -0.0056]
  ŷ⟨1⟩ = [0.2, 0.2, 0.2, 0.2, 0.2]
  Palabra predicha: posición 0

Paso t=2:
  x⟨2⟩ = [0.0, 1.0, 0.0, 0.0, 0.0]
  a⟨2⟩ = [-0.0012, 0.0158, -0.0048, -0.0101]
  ŷ⟨2⟩ = [0.2, 0.2, 0.2, 0.2, 0.2]
  Palabra predicha: posición 1

Paso t=3:
  x⟨3⟩ = [0.0, 0.0, 1.0, 0.0, 0.0]
  a⟨3⟩ = [0.0066, 0.0077, 0.0022, 0.0031]
  ŷ⟨3⟩ = [0.2, 0.2, 0.2, 0.2, 0.2]
  Palabra predicha: posición 4
12 Resumen conceptual
| Concepto | Descripción |
|---|---|
| RNN básica | Procesa secuencias paso a paso compartiendo pesos. Sufre de gradientes desvanecientes. |
| GRU | 2 puertas (actualización + relevancia). \(c^{<t>} = a^{<t>}\). Más simple y rápida. |
| LSTM | 3 puertas (olvido + entrada + salida). \(c^{<t>}\) separado de \(a^{<t>}\). Más potente. |
| BRNN | Procesa la secuencia en ambas direcciones. Captura contexto pasado y futuro. |
| Deep RNN | Apila 2-3 capas recurrentes verticalmente. Mayor capacidad de representación. |
| Modelado de lenguaje | Predice la siguiente palabra. Permite generar texto y calcular probabilidades de oraciones. |
| BPTT | Retropropagación a través del tiempo. Despliega la RNN en el tiempo para calcular gradientes. |