Backpropagation: cálculo detallado capa a capa
Navegación en esta sección
Documento base: Matemáticas de la red neuronal — arquitectura y valores numéricos de una red neuronal totalmente conectada (MLP) 2→3→2→1.
Estás en Backpropagation (cálculo de los gradientes y actualización de parámetros). La predicción \(\hat{y}\) con la que empezamos se obtuvo en Propagación hacia adelante.
1 Planteamiento: red, datos y función de error
Partimos de la misma red del documento anterior de propagación hacia adelante: dos entradas, dos capas ocultas (de 3 y 2 neuronas con ReLU) y una salida (con sigmoide, clasificación binaria). Las matrices de pesos \(W^{[l]}\), los vectores de sesgo \(b^{[l]}\) y las entradas \(x\) son:
\[
\begin{aligned}
x &= \begin{bmatrix} 0.8 \\ -0.5 \end{bmatrix} ,
\\[8pt]
W^{[1]} &= \begin{bmatrix} 0.5 & -0.3 \\ 0.2 & 0.4 \\ -0.6 & 0.3 \end{bmatrix}, \quad
b^{[1]} = \begin{bmatrix} 0.1 \\ -0.2 \\ 0.05 \end{bmatrix} ,
\\[8pt]
W^{[2]} &= \begin{bmatrix} 0.7 & -0.4 & 0.2 \\ 0.1 & 0.5 & -0.3 \end{bmatrix}, \quad
b^{[2]} = \begin{bmatrix} 0.1 \\ -0.1 \end{bmatrix} ,
\\[8pt]
W^{[3]} &= \begin{bmatrix} 0.6 & -0.2 \end{bmatrix}, \quad
b^{[3]} = \begin{bmatrix} 0.2 \end{bmatrix} .
\end{aligned}
\]
La etiqueta verdadera es \(y = 1\) (el ejemplo pertenece a la clase positiva). Tras la propagación hacia adelante (cuyo cálculo detallado está en ese documento) obtenemos:
\[
\begin{aligned}
z^{[1]} &= W^{[1]}x + b^{[1]} = \begin{bmatrix} 0.65 \\ -0.24 \\ -0.58 \end{bmatrix},
&\quad a^{[1]} &= \mathrm{ReLU}(z^{[1]}) = \begin{bmatrix} 0.65 \\ 0 \\ 0 \end{bmatrix},
\\[8pt]
z^{[2]} &= W^{[2]}a^{[1]} + b^{[2]} = \begin{bmatrix} 0.555 \\ -0.035 \end{bmatrix},
&\quad a^{[2]} &= \mathrm{ReLU}(z^{[2]}) = \begin{bmatrix} 0.555 \\ 0 \end{bmatrix},
\\[8pt]
z^{[3]} &= W^{[3]}a^{[2]} + b^{[3]} = \begin{bmatrix} 0.533 \end{bmatrix},
&\quad \hat{y} &= \sigma(z^{[3]}) \approx 0.630 .
\end{aligned}
\]
La predicción \(\hat{y}=0.630\) está lejos de la etiqueta \(y=1\): la red se equivoca. Para corregirla necesitamos calcular cómo cambia el error al modificar cada peso y cada sesgo, es decir, las derivadas parciales \(\partial L/\partial w\) y \(\partial L/\partial b\). Ese cálculo, capa a capa y hacia atrás, es la retropropagación.
Como estamos en clasificación binaria, el error se mide con la entropía cruzada binaria:
\[
L = -\,y\,\ln(\hat{y}) \;-\; (1-y)\,\ln(1-\hat{y}) .
\]
Con \(y=1\) y \(\hat{y}=0.630\) el error vale:
\[
L = -1\cdot\ln(0.630) - 0\cdot\ln(0.370) = -\ln(0.630) \approx 0.462 .
\]
2 Retropropagación: el plan
La retropropagación recorre la red desde la salida hacia la entrada y, en cada capa, calcula dos cosas:
- El delta de cada neurona, \(\delta^{[l]}_j = \dfrac{\partial L}{\partial z^{[l]}_j}\): cuánto cambia el error si movemos la entrada ponderada \(z^{[l]}_j\) de esa neurona.
- El gradiente de cada peso y sesgo: cuánto cambia el error si modificamos ese parámetro, usando que \(\dfrac{\partial L}{\partial w} = \delta_{\text{llegada}} \cdot a_{\text{partida}}\) y \(\dfrac{\partial L}{\partial b} = \delta_{\text{llegada}}\).
Delta vs gradiente: no son lo mismo
A lo largo de todo el documento usamos dos palabras que es fácil confundir:
- Delta (\(\delta\)): es siempre la derivada del error respecto a \(z\) (la suma ponderada antes de la activación). Es una cantidad intermedia que sirve para retropropagar la señal de error de una capa a la anterior.
- Gradiente: es la derivada del error respecto a un parámetro (\(w\) o \(b\)). Es lo que realmente usamos para actualizar la red con descenso de gradiente.
El delta es el “mensajero”: viaja hacia atrás por la red llevando la señal de error. Cuando llega a una capa, se convierte en gradientes de los parámetros de esa capa mediante reglas sencillas: \(\partial L/\partial W = \delta \cdot a^{\!\top}\) y \(\partial L/\partial b = \delta\). Dicho de otro modo: el delta es la herramienta para calcular los gradientes; los gradientes son lo que actualiza los parámetros.
El delta de una capa se obtiene repartiendo hacia atrás el delta de la capa siguiente a través de los pesos, y multiplicando por la derivada de la activación de la capa actual. Vamos allá, capa por capa.
Para mantener este hilo y estructurarlo visualmente y a nivel de cálculo, el panorama de la red se compone de capas y cada capa va a tener sus neuronas y pesos, en la imagen se representa una capa de cada color:
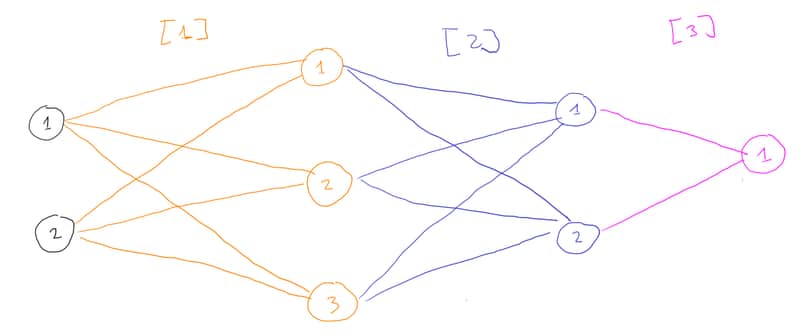
División de las capas
Cada capa tiene:
- Entradas: Los datos que recibe cada capa (ya sea la matriz de características inicial o las activaciones de la capa anterior).
- Pesos (\(W\)) y Sesgos (\(B\)): Los parámetros internos de cada capa que transforman las entradas. Cada neurona de la capa tiene su propio sesgo.
- Pre-activación (\(Z\)): El cálculo lineal intermedio en cada neurona antes de pasar por la función de activación (\(Z = W \cdot A + b\)).
- Activación (\(A\)): La salida final de la neurona tras aplicar la función de activación (\(A = g(Z)\)).
delta (\(\delta\)) de una neurona representa la tasa de cambio del error total con respecto a su pre-activación:
\[
\delta = \frac{\partial E}{\partial Z}
\]
Este valor actúa como la “sensibilidad” o el error local de cada neurona y es el puente matemático para aplicar la regla de la cadena a través de las capas:
- En la capa de salida: El delta se calcula midiendo la discrepancia entre la predicción y el valor real (\(y\)), combinando la derivada de la función de pérdida con la derivada de la función de activación.
- En las capas ocultas (los colores intermedios): Los deltas se calculan “viajando hacia atrás”, retropropagando los deltas de la capa posterior ponderados por los pesos que los conectan.
Claro que sí. Vamos a completar toda la derivación paso a paso, respetando exactamente tu notación, el orden lógico del backpropagation (hacia atrás) y la arquitectura que especificaste:
- Entrada: 2 variables (\(x_1, x_2\)).
- Capa 1 (oculta): 3 neuronas (\(z^{[1]}_1, z^{[1]}_2, z^{[1]}_3\)).
- Capa 2 (oculta): 2 neuronas (\(z^{[2]}_1, z^{[2]}_2\)).
- Capa 3 (salida): 1 neurona (\(z^{[3]}_1\)).
2.1 Cáculo de los deltas
2.1.1 Paso a paso
2.1.1.1 Capa de Salida (Capa 3)
\[
\frac{\partial L}{\partial z^{[3]}_1} = \hat{y} - y
\]
\[
\delta^{[3]} = 0.630 - 1 = \mathbf{-0.370}
\]
2.1.1.2 Capa Oculta 2
\[
\frac{\partial L}{\partial z^{[2]}_1} = \frac{\partial L}{\partial z^{[3]}_1} \cdot \frac{\partial z^{[3]}_1}{\partial a^{[2]}_1} \cdot \frac{\partial a^{[2]}_1}{\partial z^{[2]}_1}
\]
\[
\frac{\partial L}{\partial z^{[2]}_2} = \frac{\partial L}{\partial z^{[3]}_1} \cdot \frac{\partial z^{[3]}_1}{\partial a^{[2]}_2} \cdot \frac{\partial a^{[2]}_2}{\partial z^{[2]}_2}
\]
\[
\frac{\partial L}{\partial z^{[2]}_1} = (-0.370) \cdot (0.6) \cdot (1) = \mathbf{-0.222}
\]
\[
\frac{\partial L}{\partial z^{[2]}_2} = (-0.370) \cdot (-0.2) \cdot (0) = \mathbf{0.000}
\]
2.1.1.3 Capa Oculta 1
Para cada neurona de la capa 1, sumamos la contribución de todas las neuronas de la capa siguiente (Capa 2):
\[
\frac{\partial L}{\partial z^{[1]}_1} = \left( \frac{\partial L}{\partial z^{[2]}_1} \cdot \frac{\partial z^{[2]}_1}{\partial a^{[1]}_1} + \frac{\partial L}{\partial z^{[2]}_2} \cdot \frac{\partial z^{[2]}_2}{\partial a^{[1]}_1} \right) \cdot \frac{\partial a^{[1]}_1}{\partial z^{[1]}_1}
\]
\[
\frac{\partial L}{\partial z^{[1]}_2} = \left( \frac{\partial L}{\partial z^{[2]}_1} \cdot \frac{\partial z^{[2]}_1}{\partial a^{[1]}_2} + \frac{\partial L}{\partial z^{[2]}_2} \cdot \frac{\partial z^{[2]}_2}{\partial a^{[1]}_2} \right) \cdot \frac{\partial a^{[1]}_2}{\partial z^{[1]}_2}
\]
\[
\frac{\partial L}{\partial z^{[1]}_3} = \left( \frac{\partial L}{\partial z^{[2]}_1} \cdot \frac{\partial z^{[2]}_1}{\partial a^{[1]}_3} + \frac{\partial L}{\partial z^{[2]}_2} \cdot \frac{\partial z^{[2]}_2}{\partial a^{[1]}_3} \right) \cdot \frac{\partial a^{[1]}_3}{\partial z^{[1]}_3}
\]
\[
\frac{\partial L}{\partial z^{[1]}_1} = \left( (-0.222 \cdot 0.7) + (0.000 \cdot 0.1) \right) \cdot 1 = (-0.1554 + 0) \cdot 1 = \mathbf{-0.1554}
\]
\[
\frac{\partial L}{\partial z^{[1]}_2} = \left( (-0.222 \cdot -0.4) + (0.000 \cdot 0.5) \right) \cdot 0 = (0.0888 + 0) \cdot 0 = \mathbf{0.000}
\]
\[
\frac{\partial L}{\partial z^{[1]}_3} = \left( (-0.222 \cdot 0.2) + (0.000 \cdot -0.3) \right) \cdot 0 = (-0.0444 + 0) \cdot 0 = \mathbf{0.000}
\]
2.1.2 Matricial
2.1.2.1 Capa de Salida (Capa 3)
\[
\delta^{[3]} = \hat{y} - y
\]
\[
\delta^{[3]} = 0.630 - 1 = \mathbf{-0.370}
\]
2.1.2.2 Capa Oculta 2
\[
\delta^{[2]} = (W^{[3]})^T \cdot \delta^{[3]} \odot \text{ReLU}'(z^{[2]})
\]
\[
\delta^{[2]} = \begin{bmatrix} 0.6 \\ -0.2 \end{bmatrix} \cdot (-0.370) \odot \begin{bmatrix} 1 \\ 0 \end{bmatrix} = \begin{bmatrix} -0.222 \\ 0.000 \end{bmatrix}
\]
2.1.2.3 Capa Oculta 1
Para cada neurona de la capa 1, sumamos la contribución de todas las neuronas de la capa siguiente (Capa 2):
\[
\delta^{[1]} = (W^{[2]})^T \cdot \delta^{[2]} \odot \text{ReLU}'(z^{[1]})
\]
\[
\delta^{[1]} = \begin{bmatrix} 0.7 & 0.1 \\ -0.4 & 0.5 \\ 0.2 & -0.3 \end{bmatrix} \cdot \begin{bmatrix} -0.222 \\ 0.000 \end{bmatrix} \odot \begin{bmatrix} 1 \\ 0 \\ 0 \end{bmatrix} = \begin{bmatrix} -0.1554 \\ 0.0888 \\ -0.0444 \end{bmatrix} \odot \begin{bmatrix} 1 \\ 0 \\ 0 \end{bmatrix} = \mathbf{\begin{bmatrix} -0.1554 \\ 0.000 \\ 0.000 \end{bmatrix}}
\]
2.2 Ejemplo de cálculo de actualización de peso
El peso \(w^{[1]}_{11}\) es el que conecta la primera entrada (\(x_1\)) con la primera neurona de la primera capa oculta.
Por la regla de la cadena, la derivada del error respecto al peso \(w^{[1]}_{11}\) se desglosa como el producto de la derivada del error respecto a la pre-activación de esa neurona por la derivada de esa pre-activación respecto al peso:
\[
\frac{\partial L}{\partial w^{[1]}_{11}} = \frac{\partial L}{\partial z^{[1]}_1} \cdot \frac{\partial z^{[1]}_1}{\partial w^{[1]}_{11}}
\]
Como sabemos que \(z^{[1]}_1 = w^{[1]}_{11}x_1 + w^{[1]}_{12}x_2 + b^{[1]}_1\), al derivar respecto a \(w^{[1]}_{11}\) obtenemos exactamente la entrada \(x_1\):
\[
\frac{\partial z^{[1]}_1}{\partial w^{[1]}_{11}} = x_1
\]
Sustituyendo esto en la regla de la cadena (y recordando que \(\frac{\partial L}{\partial z^{[1]}_1} = \delta^{[1]}_1\)):
\[
\frac{\partial L}{\partial w^{[1]}_{11}} = \frac{\partial L}{\partial z^{[1]}_1} \cdot x_1 = \delta^{[1]}_1 \cdot x_1
\]
Si tenemos estos datos:
- \(\delta^{[1]}_1 = -0.1554\)
- \(x_1 = 0.8\)
Sustituyendo en la fórmula:
\[
\frac{\partial L}{\partial w^{[1]}_{11}} = (-0.1554) \cdot (0.8) = \mathbf{-0.12432}
\]
Aplicando una tasa de aprendizaje de \(\alpha = 0.1\):
\[
w^{[1]}_{11,\text{nuevo}} = w^{[1]}_{11,\text{viejo}} - \alpha \cdot \frac{\partial L}{\partial w^{[1]}_{11}}
\]
\[
w^{[1]}_{11,\text{nuevo}} = 0.5 - (0.1) \cdot (-0.12432) = 0.5 + 0.012432 = \mathbf{0.512432}
\]
2.3 Ejemplo de cálculo de actualización de sesgo
El parámetro \(b^{[1]}_1\) es el sesgo que pertenece a la primera neurona de la primera capa oculta.
Por la regla de la cadena, la derivada del error respecto al sesgo \(b^{[1]}_1\) se desglosa como el producto de la derivada del error respecto a la pre-activación de esa neurona por la derivada de esa pre-activación respecto al sesgo:
\[
\frac{\partial L}{\partial b^{[1]}_1} = \frac{\partial L}{\partial z^{[1]}_1} \cdot \frac{\partial z^{[1]}_1}{\partial b^{[1]}_1}
\]
Como sabemos que \(z^{[1]}_1 = w^{[1]}_{11}x_1 + w^{[1]}_{12}x_2 + b^{[1]}_1\), al derivar respecto a \(b^{[1]}_1\) obtenemos simplemente \(1\):
\[
\frac{\partial z^{[1]}_1}{\partial b^{[1]}_1} = 1
\]
Sustituyendo esto en la regla de la cadena (y recordando que \(\frac{\partial L}{\partial z^{[1]}_1} = \delta^{[1]}_1\)):
\[
\frac{\partial L}{\partial b^{[1]}_1} = \frac{\partial L}{\partial z^{[1]}_1} \cdot 1 = \delta^{[1]}_1
\]
Si tenemos este delta:
- \(\delta^{[1]}_1 = -0.1554\)
Sustituyendo en la fórmula:
\[
\frac{\partial L}{\partial b^{[1]}_1} = -0.1554 = \mathbf{-0.1554}
\]
Aplicando la misma tasa de aprendizaje de \(\alpha = 0.1\):
\[
b^{[1]}_1,_{\text{nuevo}} = b^{[1]}_1,_{\text{viejo}} - \alpha \cdot \frac{\partial L}{\partial b^{[1]}_1}
\]
Sustituyendo nuestro valor inicial \(b^{[1]}_1 = 0.1\):
\[
b^{[1]}_1,_{\text{nuevo}} = 0.1 - (0.1) \cdot (-0.1554) = 0.1 + 0.01554 = \mathbf{0.11554}
\]
2.4 Resultado
Si actualizamos todos los pesos y sesgos usando el mismo procedimiento obtendremos:
\[
\begin{aligned} W^{[1]}_{\text{nuevo}} &= \begin{bmatrix} 0.512432 & -0.30777 \\ 0.2 & 0.4 \\ -0.6 & 0.3 \end{bmatrix}, \quad b^{[1]}_{\text{nuevo}} = \begin{bmatrix} 0.11554 \\ -0.2 \\ 0.05 \end{bmatrix} \\ W^{[2]}_{\text{nuevo}} &= \begin{bmatrix} 0.71443 & -0.4 & 0.2 \\ 0.1 & 0.5 & -0.3 \end{bmatrix}, \quad b^{[2]}_{\text{nuevo}} = \begin{bmatrix} 0.1222 \\ -0.1 \end{bmatrix} \\ W^{[3]}_{\text{nuevo}} &= \begin{bmatrix} 0.620535 & -0.2 \end{bmatrix}, \quad b^{[3]}_{\text{nuevo}} = \begin{bmatrix} 0.237 \end{bmatrix} \end{aligned}
\]
Y si volvemos a realizar nuevamente la propagación hacia adelante veremos como el error se ha reducido.
\[
\begin{aligned} z^{[1]} &= W^{[1]}_{\text{nuevo}}x + b^{[1]}_{\text{nuevo}} = \begin{bmatrix} 0.512432 & -0.30777 \\ 0.2 & 0.4 \\ -0.6 & 0.3 \end{bmatrix} \begin{bmatrix} 0.8 \\ -0.5 \end{bmatrix} + \begin{bmatrix} 0.11554 \\ -0.2 \\ 0.05 \end{bmatrix} = \begin{bmatrix} 0.67937 \\ -0.24000 \\ -0.58000 \end{bmatrix} \\ a^{[1]} &= \mathrm{ReLU}(z^{[1]}) = \begin{bmatrix} 0.67937 \\ 0 \\ 0 \end{bmatrix} \\ z^{[2]} &= W^{[2]}_{\text{nuevo}}a^{[1]} + b^{[2]}_{\text{nuevo}} = \begin{bmatrix} 0.71443 & -0.4 & 0.2 \\ 0.1 & 0.5 & -0.3 \end{bmatrix} \begin{bmatrix} 0.67937 \\ 0 \\ 0 \end{bmatrix} + \begin{bmatrix} 0.1222 \\ -0.1 \end{bmatrix} = \begin{bmatrix} 0.60756 \\ -0.03206 \end{bmatrix} \\ a^{[2]} &= \mathrm{ReLU}(z^{[2]}) = \begin{bmatrix} 0.60756 \\ 0 \end{bmatrix} \\ z^{[3]} &= W^{[3]}_{\text{nuevo}}a^{[2]} + b^{[3]}_{\text{nuevo}} = \begin{bmatrix} 0.620535 & -0.2 \end{bmatrix} \begin{bmatrix} 0.60756 \\ 0 \end{bmatrix} + \begin{bmatrix} 0.237 \end{bmatrix} = \begin{bmatrix} 0.61401 \end{bmatrix} \\ \hat{y} &= \sigma(z^{[3]}) = \frac{1}{1 + e^{-0.61401}} \approx 0.64886 \\ L &= -\ln(\hat{y}) = -\ln(0.64886) \approx \mathbf{0.43254} \end{aligned}
\]
En la primera propagación la pérdida era de \(L \approx 0.462\) y la predicción estaba en \(\hat{y} \approx 0.630\). Tras realizar un único paso de retropropagación y actualizar los pesos, en la segunda propagación la pérdida ha bajado a \(L \approx 0.433\) y la predicción ha aumentado a \(\hat{y} \approx 0.649\), acercándose más a la etiqueta objetivo \(y = 1\).
3 Backpropagation por lotes
3.1 Cálculo de delta
Partimos de esta propagación hacia adelante de un lote de dos entradas.
\[
\begin{aligned} Z^{[1]} &= W^{[1]} X + b^{[1]} = \begin{bmatrix} 0.5 & -0.3 \\ 0.2 & 0.4 \\ -0.6 & 0.3 \end{bmatrix} \begin{bmatrix} 0.8 & 1.0 \\ -0.5 & 0.2 \end{bmatrix} + \begin{bmatrix} 0.1 \\ -0.2 \\ 0.05 \end{bmatrix} = \begin{bmatrix} 0.65 & 0.54 \\ -0.24 & 0.08 \\ -0.58 & -0.49 \end{bmatrix} \\ A^{[1]} &= \mathrm{ReLU}(Z^{[1]}) = \begin{bmatrix} 0.65 & 0.54 \\ 0 & 0.08 \\ 0 & 0 \end{bmatrix} \\ Z^{[2]} &= W^{[2]} A^{[1]} + b^{[2]} = \begin{bmatrix} 0.7 & -0.4 & 0.2 \\ 0.1 & 0.5 & -0.3 \end{bmatrix} \begin{bmatrix} 0.65 & 0.54 \\ 0 & 0.08 \\ 0 & 0 \end{bmatrix} + \begin{bmatrix} 0.1 \\ -0.1 \end{bmatrix} = \begin{bmatrix} 0.555 & 0.446 \\ -0.035 & -0.006 \end{bmatrix} \\ A^{[2]} &= \mathrm{ReLU}(Z^{[2]}) = \begin{bmatrix} 0.555 & 0.446 \\ 0 & 0 \end{bmatrix} \\ Z^{[3]} &= W^{[3]} A^{[2]} + b^{[3]} = \begin{bmatrix} 0.6 & -0.2 \end{bmatrix} \begin{bmatrix} 0.555 & 0.446 \\ 0 & 0 \end{bmatrix} + \begin{bmatrix} 0.2 \end{bmatrix} = \begin{bmatrix} 0.533 & 0.4676 \end{bmatrix} \\ A^{[3]} &= \sigma(Z^{[3]}) \approx \begin{bmatrix} 0.630 & 0.615 \end{bmatrix} \end{aligned}
\]
¡Claro que sí! Vamos paso a paso. Empezamos calculando el delta de la capa de salida (\(dZ^{[3]}\)).
3.1.1 1. Capa de Salida (Capa 3)
La fórmula general para la capa de salida con entropía cruzada y sigmoide es:
\[
dZ^{[3]} = A^{[3]} - Y
\]
Sustituyendo con nuestros valores (\(A^{[3]} = \begin{bmatrix} 0.630 & 0.615 \end{bmatrix}\) y \(Y = \begin{bmatrix} 1 & 0 \end{bmatrix}\)):
\[
dZ^{[3]} = \begin{bmatrix} 0.630 & 0.615 \end{bmatrix} - \begin{bmatrix} 1 & 0 \end{bmatrix} = \mathbf{\begin{bmatrix} -0.370 & 0.615 \end{bmatrix}}
\]
3.1.2 2. Capa Oculta 2
La fórmula para calcular el delta de la capa oculta 2 es:
\[
dZ^{[2]} = (W^{[3]})^T \cdot dZ^{[3]} \odot \text{ReLU}'(Z^{[2]})
\]
Sustituyendo nuestros valores:
- \(W^{[3]} = \begin{bmatrix} 0.6 & -0.2 \end{bmatrix} \implies (W^{[3]})^T = \begin{bmatrix} 0.6 \\ -0.2 \end{bmatrix}\)
- \(dZ^{[3]} = \begin{bmatrix} -0.370 & 0.615 \end{bmatrix}\)
- \(Z^{[2]} = \begin{bmatrix} 0.555 & 0.446 \\ -0.035 & -0.006 \end{bmatrix}\)
Multiplicando la primera parte y evaluando la derivada de ReLU (1 si es mayor que 0, 0 en caso contrario):
\[
dZ^{[2]} = \left( \begin{bmatrix} 0.6 \\ -0.2 \end{bmatrix} \cdot \begin{bmatrix} -0.370 & 0.615 \end{bmatrix} \right) \odot \begin{bmatrix} 1 & 1 \\ 0 & 0 \end{bmatrix}
\]
\[
dZ^{[2]} = \begin{bmatrix} -0.222 & 0.369 \\ 0.074 & -0.123 \end{bmatrix} \odot \begin{bmatrix} 1 & 1 \\ 0 & 0 \end{bmatrix} = \mathbf{\begin{bmatrix} -0.222 & 0.369 \\ 0.000 & 0.000 \end{bmatrix}}
\]
3.1.3 3. Capa Oculta 1
La fórmula para calcular el delta de la capa oculta 1 es:
\[
dZ^{[1]} = (W^{[2]})^T \cdot dZ^{[2]} \odot \text{ReLU}'(Z^{[1]})
\]
Sustituyendo nuestros valores:
- \(W^{[2]} = \begin{bmatrix} 0.7 & -0.4 & 0.2 \\ 0.1 & 0.5 & -0.3 \end{bmatrix} \implies (W^{[2]})^T = \begin{bmatrix} 0.7 & 0.1 \\ -0.4 & 0.5 \\ 0.2 & -0.3 \end{bmatrix}\)
- \(dZ^{[2]} = \begin{bmatrix} -0.222 & 0.369 \\ 0.000 & 0.000 \end{bmatrix}\)
- \(Z^{[1]} = \begin{bmatrix} 0.65 & 0.54 \\ -0.24 & 0.08 \\ -0.58 & -0.49 \end{bmatrix}\)
Multiplicando las matrices y evaluando la derivada de ReLU (1 si es mayor que 0, 0 en caso contrario):
\[
dZ^{[1]} = \left( \begin{bmatrix} 0.7 & 0.1 \\ -0.4 & 0.5 \\ 0.2 & -0.3 \end{bmatrix} \cdot \begin{bmatrix} -0.222 & 0.369 \\ 0.000 & 0.000 \end{bmatrix} \right) \odot \begin{bmatrix} 1 & 1 \\ 0 & 0 \\ 0 & 0 \end{bmatrix}
\]
\[
dZ^{[1]} = \begin{bmatrix} -0.1554 & 0.2583 \\ 0.0888 & -0.1476 \\ -0.0444 & 0.0738 \end{bmatrix} \odot \begin{bmatrix} 1 & 1 \\ 0 & 0 \\ 0 & 0 \end{bmatrix} = \mathbf{\begin{bmatrix} -0.1554 & 0.2583 \\ 0.0000 & 0.0000 \\ 0.0000 & 0.0000 \end{bmatrix}}
\]
3.2 Cálculo de Gradientes y Actualización de Parámetros (con \(m = 2\))
Ahora que ya tenemos todos los deltas (\(dZ^{[3]}, dZ^{[2]}, dZ^{[1]}\)), calculamos los gradientes de los pesos y sesgos para todo el lote. Como tenemos \(m = 2\) ejemplos, debemos sumar las contribuciones de ambas columnas y dividir entre \(m\) (promediar).
3.2.1 Capa 3 (Salida)
\[
\frac{\partial L}{\partial W^{[3]}} = \frac{1}{m} dZ^{[3]} (A^{[2]})^T, \quad \frac{\partial L}{\partial b^{[3]}} = \frac{1}{m} \sum dZ^{[3]}
\]
\[
\frac{\partial L}{\partial W^{[3]}} = \frac{1}{2} \begin{bmatrix} -0.370 & 0.615 \end{bmatrix} \begin{bmatrix} 0.555 & 0 \\ 0.446 & 0 \end{bmatrix} = \frac{1}{2} \begin{bmatrix} -0.20535 + 0.27429 & 0 \end{bmatrix} = \frac{1}{2} \begin{bmatrix} 0.06894 & 0 \end{bmatrix} = \begin{bmatrix} 0.03447 & 0 \end{bmatrix}
\]
\[
\frac{\partial L}{\partial b^{[3]}} = \frac{1}{2} (-0.370 + 0.615) = \frac{1}{2} (0.245) = \mathbf{0.1225}
\]
- Nuevos parámetros (\(\alpha = 0.1\)):
- \(W^{[3]}_{\text{nuevo}} = \begin{bmatrix} 0.6 & -0.2 \end{bmatrix} - 0.1 \cdot \begin{bmatrix} 0.03447 & 0 \end{bmatrix} = \mathbf{\begin{bmatrix} 0.59655 & -0.2 \end{bmatrix}}\)
- \(b^{[3]}_{\text{nuevo}} = \begin{bmatrix} 0.2 \end{bmatrix} - 0.1 \cdot [0.1225] = \mathbf{\begin{bmatrix} 0.18775 \end{bmatrix}}\)
3.2.2 Capa 2 (Oculta 2)
\[
\frac{\partial L}{\partial W^{[2]}} = \frac{1}{m} dZ^{[2]} (A^{[1]})^T, \quad \frac{\partial L}{\partial b^{[2]}} = \frac{1}{m} \sum_{\text{filas}} dZ^{[2]}
\]
\[
\frac{\partial L}{\partial W^{[2]}} = \frac{1}{2} \begin{bmatrix} -0.222 & 0.369 \\ 0 & 0 \end{bmatrix} \begin{bmatrix} 0.65 & 0 & 0 \\ 0.54 & 0.08 & 0 \end{bmatrix} = \frac{1}{2} \begin{bmatrix} -0.1443 + 0.19926 & 0.02952 & 0 \\ 0 & 0 & 0 \end{bmatrix} = \begin{bmatrix} 0.02748 & 0.01476 & 0 \\ 0 & 0 & 0 \end{bmatrix}
\]
\[
\frac{\partial L}{\partial b^{[2]}} = \frac{1}{2} \begin{bmatrix} -0.222 + 0.369 \\ 0 + 0 \end{bmatrix} = \frac{1}{2} \begin{bmatrix} 0.147 \\ 0 \end{bmatrix} = \mathbf{\begin{bmatrix} 0.0735 \\ 0 \end{bmatrix}}
\]
- Nuevos parámetros (\(\alpha = 0.1\)):
- \(W^{[2]}_{\text{nuevo}} = \begin{bmatrix} 0.7 & -0.4 & 0.2 \\ 0.1 & 0.5 & -0.3 \end{bmatrix} - 0.1 \cdot \begin{bmatrix} 0.02748 & 0.01476 & 0 \\ 0 & 0 & 0 \end{bmatrix} = \mathbf{\begin{bmatrix} 0.69725 & -0.40148 & 0.2 \\ 0.1 & 0.5 & -0.3 \end{bmatrix}}\)
- \(b^{[2]}_{\text{nuevo}} = \begin{bmatrix} 0.1 \\ -0.1 \end{bmatrix} - 0.1 \cdot \begin{bmatrix} 0.0735 \\ 0 \end{bmatrix} = \mathbf{\begin{bmatrix} 0.09265 \\ -0.1 \end{bmatrix}}\)
3.2.3 Capa 1 (Oculta 1)
\[
\frac{\partial L}{\partial W^{[1]}} = \frac{1}{m} dZ^{[1]} X^T, \quad \frac{\partial L}{\partial b^{[1]}} = \frac{1}{m} \sum_{\text{filas}} dZ^{[1]}
\]
\[
\frac{\partial L}{\partial W^{[1]}} = \frac{1}{2} \begin{bmatrix} -0.1554 & 0.2583 \\ 0 & 0 \\ 0 & 0 \end{bmatrix} \begin{bmatrix} 0.8 & -0.5 \\ 1.0 & 0.2 \end{bmatrix} = \frac{1}{2} \begin{bmatrix} (-0.1554 \cdot 0.8 + 0.2583 \cdot 1.0) & (-0.1554 \cdot -0.5 + 0.2583 \cdot 0.2) \\ 0 & 0 \\ 0 & 0 \end{bmatrix}
\]
\[
\frac{\partial L}{\partial W^{[1]}} = \frac{1}{2} \begin{bmatrix} 0.13407 & 0.12933 \\ 0 & 0 \\ 0 & 0 \end{bmatrix} = \mathbf{\begin{bmatrix} 0.067035 & 0.064665 \\ 0 & 0 \\ 0 & 0 \end{bmatrix}}
\]
\[
\frac{\partial L}{\partial b^{[1]}} = \frac{1}{2} \begin{bmatrix} -0.1554 + 0.2583 \\ 0 \\ 0 \end{bmatrix} = \mathbf{\begin{bmatrix} 0.05145 \\ 0 \\ 0 \end{bmatrix}}
\]
- Nuevos parámetros (\(\alpha = 0.1\)):
- \(W^{[1]}_{\text{nuevo}} = \begin{bmatrix} 0.5 & -0.3 \\ 0.2 & 0.4 \\ -0.6 & 0.3 \end{bmatrix} - 0.1 \cdot \begin{bmatrix} 0.067035 & 0.064665 \\ 0 & 0 \\ 0 & 0 \end{bmatrix} = \mathbf{\begin{bmatrix} 0.4932965 & -0.3064665 \\ 0.2 & 0.4 \\ -0.6 & 0.3 \end{bmatrix}}\)
- \(b^{[1]}_{\text{nuevo}} = \begin{bmatrix} 0.1 \\ -0.2 \\ 0.05 \end{bmatrix} - 0.1 \cdot \begin{bmatrix} 0.05145 \\ 0 \\ 0 \end{bmatrix} = \mathbf{\begin{bmatrix} 0.094855 \\ -0.2 \\ 0.05 \end{bmatrix}}\)
Volver al inicio de la sección
Con los gradientes calculados y los parámetros actualizados, el ciclo de entrenamiento (propagación → backpropagation → actualización) queda completo. Revisa la arquitectura y los valores de la red o repasa la propagación hacia adelante si quieres ver de dónde salen las predicciones que aquí corregimos.