Arquitecturas Clásicas y Modernas de CNN
Navegación en esta sección
Fundamentos teóricos: Redes neuronales convolucionales (CNN) y Matemáticas de la capa convolucional.
Estás en Arquitecturas clásicas y modernas de CNN (análisis de los grandes hitos de diseño que transformaron la visión por computadora y el aprendizaje profundo).
1 ¿Por qué estudiar arquitecturas consagradas?
Al igual que en la ingeniería de software aprendemos a programar analizando código de calidad y patrones de diseño (Design Patterns), en Deep Learning la mejor forma de desarrollar intuición para construir redes neuronales convolucionales eficaces es estudiar las arquitecturas que revolucionaron el campo.
El estudio de estas arquitecturas ofrece tres ventajas fundamentales:
- Patrones de diseño modulares: Comprender por qué los investigadores apilan ciertos tipos de capas (por ejemplo, filtros \(3\times3\) repetidos o bloques residuales) proporciona herramientas para diseñar modelos propios.
- Transferencia de arquitecturas (Transfer Learning): Una arquitectura ganadora en competiciones como ImageNet puede adaptarse directamente a problemas muy distintos (diagnóstico médico, satélites o coches autónomos) reutilizando sus pesos preentrenados.
- Ideas transferibles a otras disciplinas: Conceptos como las conexiones residuales de ResNet o las convoluciones \(1\times1\) se utilizan hoy en procesamiento de lenguaje natural (Transformers), modelos generativos (Diffusion Models) y reconocimiento de voz.
2 Arquitecturas clásicas
2.1 ImageNet
Presentada por Alex Krizhevsky, Ilya Sutskever y Geoffrey Hinton, AlexNet ganó el prestigioso concurso ImageNet Large Scale Visual Recognition Challenge (ILSVRC 2012) reduciendo el error del estado del arte anterior del \(26\%\) al \(15.3\%\). Este hito convenció a la comunidad científica internacional de que las redes neuronales profundas eran superiores a los métodos tradicionales basados en características artesanales (como SIFT o HOG).
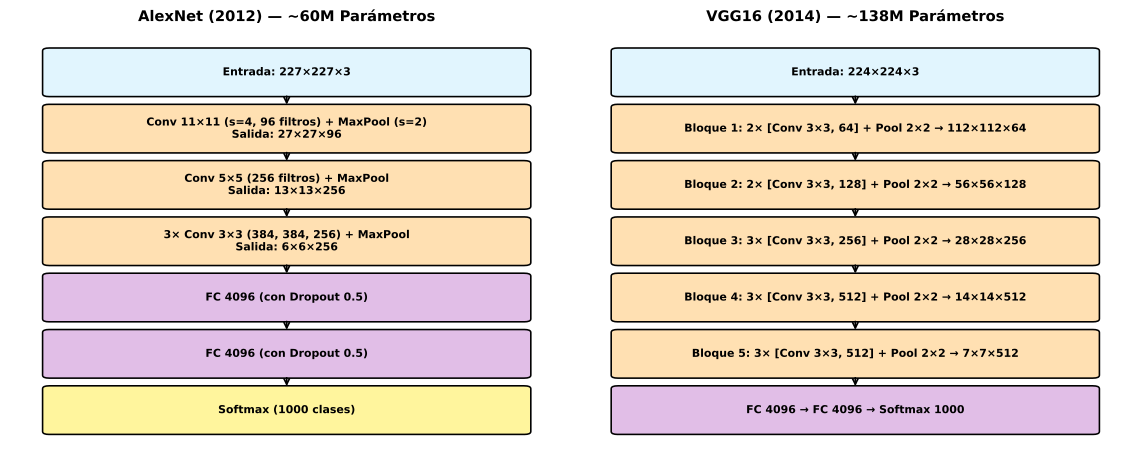
Figura 1: Evolución de arquitecturas clásicas: AlexNet (2012, izquierda) rompió la barrera del aprendizaje profundo en ImageNet con kernels grandes (11×11) y GPUs paralelas; VGG16 (2014, derecha) introdujo la modularidad estricta apilando filtros pequeños de 3×3.
2.1.1 Claves e innovaciones técnicas
- Función de activación ReLU: Sustituyó a las funciones sigmoide y tanh utilizadas en LeNet-5. Al no saturar para valores positivos (\(\frac{\partial \text{ReLU}}{\partial z} = 1\)), aceleró el entrenamiento por descenso de gradiente.
- Entrenamiento en múltiples GPUs: Como las GPUs de la época (NVIDIA GTX 580 de 3GB) no tenían suficiente memoria, AlexNet dividió las capas entre dos tarjetas conectadas en paralelo.
- Regularización con Dropout: Se aplicó una probabilidad de desconexión \(p = 0.5\) en las capas totalmente conectadas para mitigar el sobreajuste (overfitting) en sus \(\approx 60\) millones de parámetros.
- Aumento de datos (Data Augmentation): Generación en tiempo real de traslaciones, recortes aleatorios de \(224 \times 224\) a partir de imágenes de \(256 \times 256\) y alteraciones en la intensidad de los canales RGB.
2.2 VGG16 (2014): Simplicidad, modularidad y filtros \(3 \times 3\)
Desarrollada por el Visual Geometry Group de la Universidad de Oxford (Simonyan y Zisserman), la red VGG16 demostró que la profundidad sistemática y una regla de diseño homogénea superaban a las arquitecturas con filtros de tamaños heterogéneos.
En lugar de usar filtros grandes como los de \(11 \times 11\) o \(5 \times 5\), VGG fijó todos sus filtros convolucionales en \(3 \times 3\) con paso \(S=1\) y padding \(P=1\) (Same), y todos sus pooling en Max Pooling \(2 \times 2\) con paso \(S=2\).
Consideremos dos capas consecutivas de \(3 \times 3\):
- El primer filtro de \(3 \times 3\) cubre una ventana de \(3 \times 3\) de la entrada.
- El segundo filtro de \(3 \times 3\) opera sobre la salida del primero, abarcando indirectamente una región de \(5 \times 5\) píxeles de la entrada original (su campo receptivo efectivo es \(5 \times 5\)).
- De igual forma, apilar tres capas de \(3 \times 3\) cubre un campo receptivo equivalente a una única capa de \(7 \times 7\).
Ahorro de parámetros y mayor no linealidad
Supongamos una capa con \(C\) canales de entrada y \(C\) canales de salida:
- Una capa de \(5 \times 5\): Requiere \(1 \times (5 \times 5 \times C \times C) = \mathbf{25 C^2}\) parámetros y aplica una única activación ReLU.
- Dos capas de \(3 \times 3\) apiladas: Requieren \(2 \times (3 \times 3 \times C \times C) = \mathbf{18 C^2}\) parámetros y aplican dos activaciones ReLU consecutivas.
Resultado: se obtiene exactamente el mismo campo receptivo con un \(28\%\) menos de parámetros y con mayor capacidad no lineal para aprender funciones complejas.
3 La convolución \(1 \times 1\)
A primera vista, un filtro convolucional de tamaño \(1 \times 1\) parece una simple multiplicación escalar. Sin embargo, cuando se aplica sobre un volumen con múltiples canales (\(H \times W \times C_{\text{in}}\)), se convierte en una herramienta versátil.
Introducida en el artículo Network in Network (Lin et al., 2013) y popularizada por GoogLeNet y ResNet, una convolución \(1 \times 1\) equivale a una red neuronal densa (MLP) aplicada de forma idéntica a cada píxel \((x, y)\) a lo largo del eje de canales.
3.1 Ejemplo numérico completo de convolución \(1 \times 1\)
Para entender qué hace realmente una convolución \(1 \times 1\), consideremos un volumen de entrada de \(2 \times 2 \times 3\) (2 filas, 2 columnas y 3 canales de color) y apliquémosle un único filtro de \(1 \times 1 \times 3\) con pesos \(w = [2, -1, 3]\) y sesgo \(b = 1\).
3.1.1 Datos de entrada
La entrada tiene 3 canales, cada uno representado como una matriz de \(2 \times 2\):
El filtro tiene un peso asociado a cada canal:
3.1.2 Cálculo en cada posición espacial
En cada posición \((i, j)\), el filtro toma el vector de 3 valores a través de los canales y calcula su producto escalar más el sesgo:
Posición \((0, 0)\) — valores por canal: \([5, 2, 1]\)
Posición \((0, 1)\) — valores por canal: \([2, 4, 6]\)
Posición \((1, 0)\) — valores por canal: \([3, 7, 0]\)
Posición \((1, 1)\) — valores por canal: \([1, 0, 3]\)
3.1.3 Resultado
El filtro \(1 \times 1 \times 3\) produce un único mapa de características de \(2 \times 2\):
Interpretación geométrica
La convolución \(1 \times 1\) colapsa los 3 canales en un solo valor por posición espacial mediante un producto escalar. Si en lugar de 1 filtro aplicamos \(C_{\text{out}}\) filtros distintos (cada uno con sus propios 3 pesos), obtendremos un volumen de salida de \(2 \times 2 \times C_{\text{out}}\). Es exactamente el cálculo de una neurona densa (MLP) aplicada de forma independiente a cada píxel.
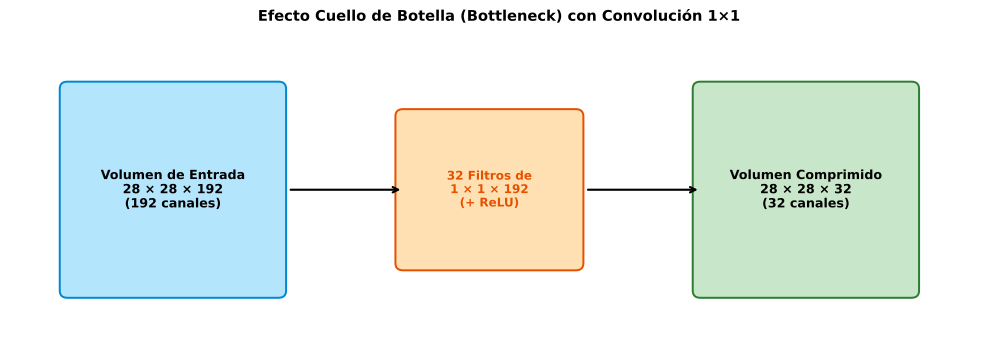
Figura 2: Convolución 1×1 para reducción de canales (Bottleneck): transforma un volumen de 28×28×192 a 28×28×32 mediante 32 filtros de 1×1×192, comprimiendo los canales sin alterar las dimensiones espaciales.
¿Por qué no es simplemente multiplicar por un número?
Si la entrada tuviera un solo canal (\(C_{\text{in}} = 1\)), una convolución \(1 \times 1\) sería trivialmente una multiplicación escalar. La clave es que, con múltiples canales, el filtro \(1 \times 1 \times C_{\text{in}}\) realiza un producto escalar entre el vector de \(C_{\text{in}}\) canales y los pesos del filtro en cada posición espacial. Es exactamente el cálculo de una neurona densa (MLP) aplicado de forma independiente a cada píxel.
3.1.4 Funciones principales de la convolución \(1 \times 1\)
- Reducción de dimensionalidad (Bottleneck): Si tenemos un volumen de \(28 \times 28 \times 192\) y aplicamos 32 filtros de \(1 \times 1 \times 192\), obtenemos un volumen de \(28 \times 28 \times 32\). Se reduce el número de canales en un factor de 6 manteniendo intacta la resolución espacial (\(28 \times 28\)).
- Expansión de dimensionalidad: Puede utilizarse para aumentar el número de canales cuando se requiere mayor capacidad representacional.
- Inyección de no linealidad económica: Añade una función de activación ReLU tras la combinación lineal entre canales sin aumentar el coste espacial.
4 ResNet (2015): Entrenando redes ultra-profundas con Bloques Residuales
Antes de 2015, existía una barrera práctica al aumentar la profundidad de las redes: las redes llanas (Plain Networks) de más de 20 o 30 capas sufrían el problema de degradación. Sorprendentemente, al añadir más capas, el error de entrenamiento aumentaba (no por sobreajuste, sino por la incapacidad de los optimizadores para propagar los gradientes a través de tantas transformaciones no lineales consecutivas).
Para resolver este problema, Kaiming He, Xiangyu Zhang, Shaoqing Ren y Jian Sun (Microsoft Research) presentaron las Redes Residuales (ResNet), ganadoras de ImageNet 2015 con arquitecturas de hasta 152 capas (y posteriormente más de 1000 capas).
4.1 El problema de la degradación en redes llanas
En teoría, una red más profunda debería poder aprender funciones más complejas y rendir mejor que una red superficial. En la práctica, esto no ocurre: una red llana de 56 capas rinde peor en el conjunto de entrenamiento que una de 20 capas, no porque sobreajuste, sino porque el optimizador (descenso de gradiente) tiene dificultades para aprender la función identidad cuando las capas adicionales no aportan nada útil.
Analogía: Imagina que quieres transmitir una señal de audio a través de 100 procesadores en cadena. Si cada procesador introduce aunque sea una pequeña distorsión aleatoria, la señal final será irreconocible. En una red llana, cada capa adicional introduce una transformación que el optimizador debe aprender a compensar exactamente, lo cual es extremadamente difícil en espacios de alta dimensión.
4.2 El Bloque Residual: la conexión de salto (Skip Connection)
La idea central de ResNet es sencilla pero revolucionaria: en lugar de obligar a las capas intermedias a aprender la transformación completa \(\mathcal{H}(a^{[l]})\), les pedimos que aprendan solo la corrección residual \(\mathcal{F}(a^{[l]}) = \mathcal{H}(a^{[l]}) - a^{[l]}\). La entrada original \(a^{[l]}\) se transporta directamente al final del bloque mediante una conexión de salto (skip connection).
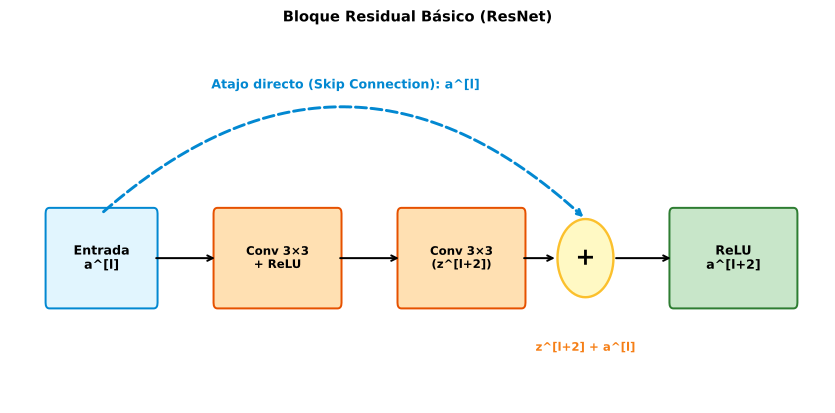
Figura 3: Bloque Residual Básico de ResNet: la conexión de salto (skip connection, en azul) transporta la activación de entrada a 1 directamente antes de la activación no lineal final, permitiendo que el bloque aprenda una corrección residual F(a 2 ).
4.3 Ejemplo numérico de un Bloque Residual
Supongamos que la activación de entrada al bloque es un vector de 4 valores:
4.3.1 Camino principal (las dos capas convolucionales)
Las capas intermedias producen una transformación residual \(z^{[l+2]} = \mathcal{F}(a^{[l]})\). Supongamos que, tras las dos convoluciones \(3 \times 3\) y la activación ReLU intermedia, el resultado es:
4.3.2 Conexión de salto: la suma
La operación clave del bloque residual es sumar elemento a elemento la entrada original \(a^{[l]}\) con la transformación residual \(z^{[l+2]}\):
4.3.3 Activación final (ReLU)
4.4 ¿Por qué funciona la función identidad?
Ahora veamos qué ocurre si las capas intermedias del bloque no aportan ninguna mejora al modelo (es decir, la red no necesita aprender nada nuevo en este bloque).
En una red llana (sin skip connection): La salida sería simplemente \(z^{[l+2]} = \mathcal{F}(a^{[l]})\). Para que la señal pase sin modificarse, la red tendría que aprender exactamente \(\mathcal{F}(a^{[l]}) = a^{[l]}\), lo que requiere que la matriz de pesos \(W\) sea la matriz identidad \(I\) y el sesgo sea \(b = 0\). Encontrar exactamente la matriz identidad mediante descenso de gradiente en un espacio de millones de dimensiones es extremadamente difícil.
En una red residual (con skip connection): Mediante la regularización \(L_2\) (weight decay), los pesos \(W^{[l+1]}, W^{[l+2]}\) y sesgos \(b\) tenderán a cero: \(W \to 0, b \to 0\). En ese caso:
- La transformación residual se anula: \(\mathcal{F}(a^{[l]}) = z^{[l+2]} \approx \mathbf{0}\).
- La ecuación se simplifica a:
- El bloque aprende de forma trivial la función identidad: simplemente deja pasar la activación \(a^{[l]}\) sin modificarla.
Consecuencia práctica: garantía de no degradación
El punto de partida por defecto de un bloque residual es la función identidad (\(W = 0 \implies \mathcal{F} = 0\)). Esto garantiza que añadir más capas nunca empeora el rendimiento de la red: si una capa adicional no es útil, simplemente se anula y la señal pasa sin modificar. El optimizador solo necesita aprender transformaciones cuando estas aportan una mejora real.
4.5 Ejemplo numérico: identidad en acción
Si la regularización lleva los pesos a cero, el bloque residual produce:
La señal de entrada \(a^{[l]}\) pasa prácticamente intacta a través del bloque. La red más profunda rinde al menos tan bien como la red más superficial.
4.6 Retropropagación a través del bloque residual
La verdadera magia de ResNet se revela al analizar cómo fluyen los gradientes hacia atrás. Veamos qué ocurre con la señal de error en la retropropagación.
4.6.1 En una red llana (sin skip connection)
El gradiente debe atravesar todas las capas en secuencia. Si la red tiene \(L\) capas, el gradiente de la pérdida respecto a la primera capa es:
Cada factor \(\frac{\partial a^{[k+1]}}{\partial a^{[k]}}\) es una matriz de pesos multiplicada por la derivada de la activación. Si estos valores son menores que 1 (típico con sigmoide o tanh), el producto de cientos de factores pequeños converge rápidamente a cero: es el desvanecimiento del gradiente (vanishing gradient). Las capas iniciales reciben gradientes tan diminutos que apenas se actualizan.
4.6.2 En una red residual (con skip connection)
Recordemos la ecuación del bloque residual:
Al derivar la pérdida \(L\) respecto a \(a^{[l]}\) mediante la regla de la cadena, el gradiente tiene dos caminos:
El Camino 2 (el atajo) es clave: como \(a^{[l+2]} = g(z^{[l+2]} + a^{[l]})\), la derivada directa es:
Esto significa que el gradiente fluye directamente desde \(a^{[l+2]}\) hasta \(a^{[l]}\) sin pasar por ninguna matriz de pesos intermedia. Es una autopista de gradientes que evita el desvanecimiento.
4.6.3 Ejemplo numérico de retropropagación
Supongamos que en la retropropagación llega un gradiente a la salida del bloque:
Y supongamos que la derivada de la activación ReLU en el punto de operación es \(g'(\cdot) = 1\) (porque la entrada fue positiva). El gradiente respecto a \(a^{[l]}\) es:
El segundo término garantiza que el gradiente nunca se anule completamente, sin importar cuántos bloques residuales haya en la red. Esto permite entrenar redes de 152 o más capas sin que los gradientes se desvanezcan.
La skip connection como autopista de gradientes
En una red llana, el gradiente solo puede fluir a través de las capas convolucionales (Camino 1), donde se multiplica repetidamente por matrices de pesos que lo reducen progresivamente. En ResNet, el Camino 2 (el atajo) suma el gradiente directo sin modificación, garantizando que la señal de error siempre llegue a las capas iniciales con magnitud suficiente para actualizar los pesos.
4.7 Coincidencia de dimensiones: Atajo con proyección (\(1 \times 1\))
Para realizar la suma elemento a elemento \(z^{[l+2]} + a^{[l]}\), ambas matrices deben tener idénticas dimensiones espaciales (\(H \times W\)) y el mismo número de canales (\(C\)):
- Si las dimensiones coinciden: Se utiliza un atajo directo de identidad (Identity Shortcut).
- Si las dimensiones cambian (por ejemplo, cuando se reduce la resolución con stride \(S=2\) o se duplican los canales): Se añade una proyección lineal con un kernel de \(1 \times 1\) y stride \(S=2\) en el atajo:
donde \(W_s\) es una matriz de pesos entrenables de \(1 \times 1\) que ajusta la resolución y el número de canales de \(a^{[l]}\).
5 Inception Network (GoogLeNet): Módulos multiescala y eficiencia
Diseñada por Christian Szegedy y su equipo en Google (2014), GoogLeNet abordó el dilema del diseño arquitectónico: en lugar de elegir entre un filtro de \(1\times1\), \(3\times3\), \(5\times5\) o una capa de pooling, el módulo Inception ejecuta todas estas operaciones en paralelo y concatena sus salidas.
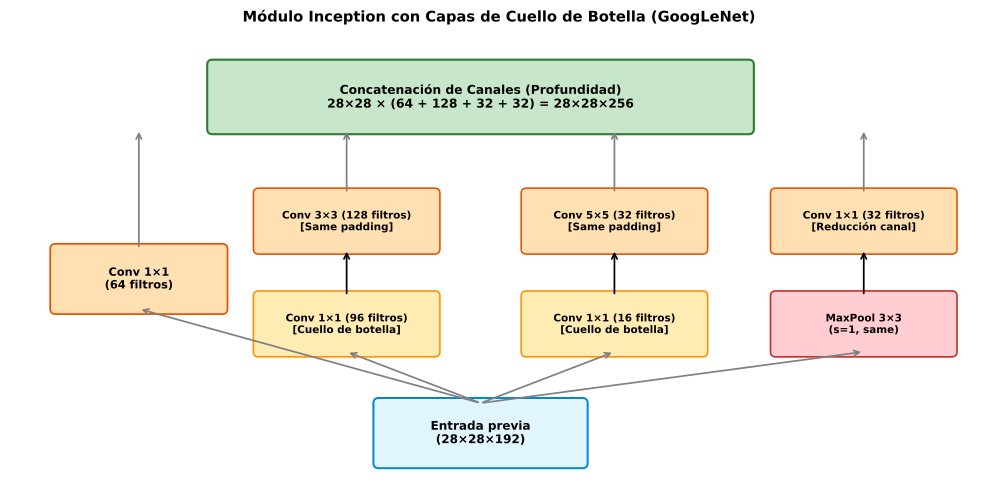
Figura 4: Módulo Inception con capas de reducción (cuello de botella 1×1): procesa la información en 4 ramas paralelas y concatena los resultados a lo largo del eje de canales, ahorrando casi un orden de magnitud en coste computacional.
5.1 El problema del coste computacional y la solución con Cuello de Botella
Si aplicamos directamente 32 filtros de \(5 \times 5\) sobre una entrada de \(28 \times 28 \times 192\):
Para resolverlo, Inception inserta una capa de cuello de botella \(1 \times 1\) con 16 filtros antes de la convolución \(5 \times 5\):
- Paso 1 (Convolución \(1 \times 1\)): Transforma \(28 \times 28 \times 192 \to 28 \times 28 \times 16\):
- Paso 2 (Convolución \(5 \times 5\)): Opera sobre la entrada reducida \(28 \times 28 \times 16 \to 28 \times 28 \times 32\):
- Coste total con cuello de botella:
¡El coste se reduce en casi un factor de 10 sin perder precisión!
5.2 Clasificadores auxiliares (Auxiliary Classifiers)
GoogLeNet introdujo dos ramas laterales conectadas a capas intermedias de la red, terminando en clasificadores Softmax auxiliares. Durante el entrenamiento, sus pérdidas se ponderan (\(\mathcal{L}_{\text{total}} = \mathcal{L}_{\text{final}} + 0.3 \mathcal{L}_{\text{aux1}} + 0.3 \mathcal{L}_{\text{aux2}}\)) para inyectar gradientes frescos en las capas iniciales, combatiendo el desvanecimiento del gradiente. En inferencia, estas ramas auxiliares se eliminan.
6 MobileNets: Deep Learning eficiente para dispositivos móviles
Las redes pesadas como VGG16 (\(\approx 500\) MB) son inviables para teléfonos móviles, drones o dispositivos embebidos. MobileNet (Howard et al., 2017) introdujo la convolución separable en profundidad (Depthwise Separable Convolution), que descompone la convolución convencional en dos etapas ultra-ligeras.
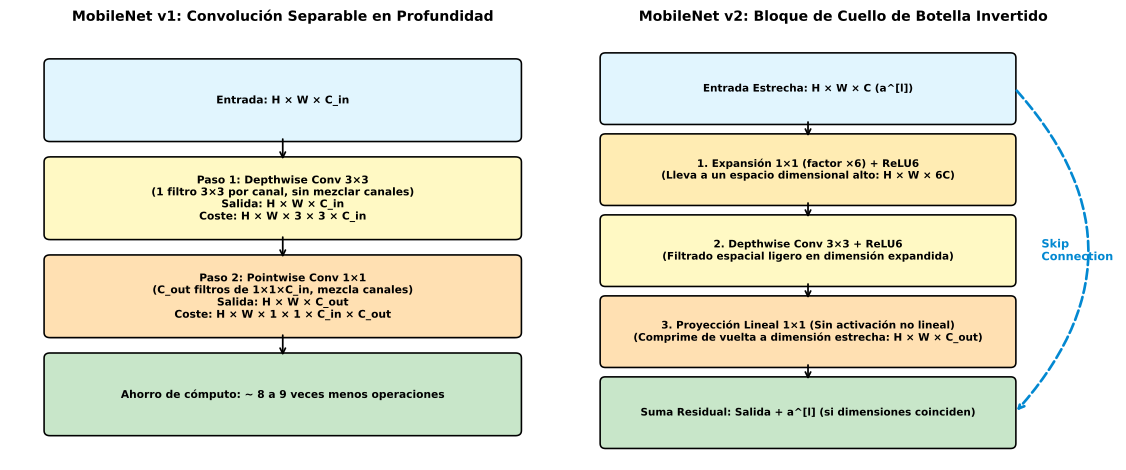
Figura 5: MobileNet v1 (izquierda, descomposición Depthwise + Pointwise) y MobileNet v2 (derecha, bloque de cuello de botella invertido con conexiones residuales).
6.1 Convolución Separable en Profundidad (MobileNet v1)
Una convolución tradicional combina simultáneamente el filtrado espacial y la mezcla de canales. MobileNet v1 divide esto en dos etapas:
- Convolución en profundidad (Depthwise Convolution): Aplica un único filtro \(K \times K\) por cada canal de entrada de forma independiente, sin mezclar información entre canales.
- Convolución puntual (Pointwise Convolution): Aplica \(C_{\text{out}}\) filtros de \(1 \times 1 \times C_{\text{in}}\) para combinar linealmente los canales generados en el paso anterior.
6.1.1 Deducción del factor de ahorro computacional
El coste total de una convolución estándar frente a la convolución separable en profundidad es:
Para filtros estándar de \(3 \times 3\) (\(K=3\)), \(\frac{1}{K^2} = \frac{1}{9} \approx 0.11\). Como \(\frac{1}{C_{\text{out}}}\) suele ser despreciable, la convolución separable reduce el cómputo entre 8 y 9 veces (\(\approx 85-90\%\) de ahorro) con una pérdida mínima de precisión.
6.2 MobileNet v2: Cuello de botella invertido (Inverted Residuals)
Presentada por Sandler et al. (2018), MobileNet v2 introdujo dos mejoras decisivas:
- Cuello de botella invertido (Inverted Residuals): A diferencia del bloque residual tradicional (que comprime \(\to\) procesa \(\to\) expande), MobileNet v2 trabaja con tensores estrechos en memoria y realiza un patrón estrecho \(\to\) ancho (expansión \(1\times1 \times 6\)) \(\to\) filtrado depthwise \(\to\) estrecho (proyección \(1\times1\)). Esto permite aprender representaciones ricas en alta dimensión minimizando la huella de memoria RAM.
- Cuello de botella lineal (Linear Bottleneck): Se elimina la función de activación ReLU en la última capa de proyección \(1\times1\). Los autores demostraron que aplicar una no linealidad como ReLU en espacios de baja dimensión destruye información irreversiblemente.
7 EfficientNet (2019): Escalado compuesto sistemático
Al adaptar una red neuronal a diferentes presupuestos de cómputo (desde microcontroladores hasta servidores en la nube), tradicionalmente los ingenieros ajustaban una sola dimensión: hacer la red más profunda (más capas, como ResNet-152), más ancha (más canales por capa, como WideResNet) o alimentar imágenes de mayor resolución (\(R\)).
Mingxing Tan y Quoc Le (Google Research, 2019) demostraron que el escalado arbitrario de una sola dimensión satura rápidamente su beneficio. En su lugar, propusieron el escalado compuesto (Compound Scaling), que equilibra simultáneamente las tres dimensiones:
donde \(\phi\) es un coeficiente definido por el usuario que controla los recursos disponibles (\(2^\phi\) veces más operaciones FLOPS). La familia resultante (EfficientNet-B0 hasta B7) alcanzó precisiones superiores en ImageNet con hasta \(8.4\times\) menos parámetros y \(6.1\times\) menos operaciones que las arquitecturas existentes.
8 Código práctico en Python: Cálculo comparativo de operaciones
El siguiente script en Python calcula analíticamente la reducción en parámetros y operaciones de convoluciones apiladas \(3\times3\) (VGG) y convoluciones separables en profundidad (MobileNet):
import numpy as np

def conv_cost(H, W, C_in, C_out, K):
    """Calcula parámetros y multiplicaciones para convolución estándar."""
    params = (K * K * C_in + 1) * C_out
    flops = H * W * K * K * C_in * C_out
    return params, flops

def depthwise_separable_cost(H, W, C_in, C_out, K):
    """Calcula parámetros y multiplicaciones para Depthwise Separable Conv."""
    # 1. Depthwise
    params_dw = (K * K + 1) * C_in
    flops_dw = H * W * K * K * C_in
    # 2. Pointwise
    params_pw = (1 * 1 * C_in + 1) * C_out
    flops_pw = H * W * 1 * 1 * C_in * C_out

    total_params = params_dw + params_pw
    total_flops = flops_dw + flops_pw
    return total_params, total_flops

# 1. Comparativa VGG: 2 capas 3x3 vs 1 capa 5x5 (C=128 canales)
p_5x5, _ = conv_cost(56, 56, 128, 128, K=5)
p_3x3_x2, _ = conv_cost(56, 56, 128, 128, K=3)
p_3x3_x2 *= 2

print("=" * 60)
print("1. PRINCIPIO VGG: 2 CAPAS 3x3 vs 1 CAPA 5x5")
print("=" * 60)
print(f"Parámetros 1 capa 5×5:      {p_5x5:,}")
print(f"Parámetros 2 capas 3×3:     {p_3x3_x2:,}")
print(f"Ahorro de parámetros:       {(1 - p_3x3_x2/p_5x5)*100:.2f}%\n")

# 2. Comparativa MobileNet: Convolución estándar vs Separable en profundidad
H, W, C_in, C_out, K = 56, 56, 128, 256, 3
p_std, f_std = conv_cost(H, W, C_in, C_out, K)
p_sep, f_sep = depthwise_separable_cost(H, W, C_in, C_out, K)

print("=" * 60)
print("2. PRINCIPIO MOBILENET: CONVOLUCIÓN ESTÁNDAR vs SEPARABLE")
print("=" * 60)
print(f"Estándar:   {p_std:,} parámetros | {f_std:,} operaciones")
print(f"Separable:  {p_sep:,} parámetros | {f_sep:,} operaciones")
print(f"Factor de aceleración:      {f_std / f_sep:.2f}x más rápida")
print(f"Reducción de coste:         {(1 - f_sep / f_std)*100:.2f}%")
============================================================
1. PRINCIPIO VGG: 2 CAPAS 3x3 vs 1 CAPA 5x5
============================================================
Parámetros 1 capa 5×5:      409,728
Parámetros 2 capas 3×3:     295,168
Ahorro de parámetros:       27.96%

============================================================
2. PRINCIPIO MOBILENET: CONVOLUCIÓN ESTÁNDAR vs SEPARABLE
============================================================
Estándar:   295,168 parámetros | 924,844,032 operaciones
Separable:  34,304 parámetros | 106,373,120 operaciones
Factor de aceleración:      8.69x más rápida
Reducción de coste:         88.50%