Intuición a las redes neuronales
1 ¿Qué es el deep learning?
El aprendizaje profundo (deep learning) es un subconjunto del aprendizaje automático. En la industria se usa para resolver tareas prácticas en campos muy distintos: visión por computadora (imágenes), procesamiento de lenguaje natural (texto) y reconocimiento automático de voz (audio).
2 Neuronas y el cerebro
La inspiración inicial de las redes neuronales venía de la biología: al igual que el cerebro, estas redes se construyen a partir de unidades de procesamiento muy simples llamadas neuronas que reciben varias entradas, realizan un cálculo y producen una salida.
Pero en realidad las redes neuronales artificiales simplifican enormemente al cerebro biológico. Una neurona real tiene una electroquímica mucho más compleja; una neurona artificial es apenas una suma ponderada seguida de una función de activación matemática. La evolución que ha tenido e le aprendizaje profundo viene de:
- la disponibilidad de grandes conjuntos de datos, que las redes grandes aprovechan mejor que los algoritmos clásicos;
- el hardware adecuado, en particular las GPU, capaces de hacer en paralelo los millones de multiplicaciones que estas redes requieren.
3 Una neurona es (casi) regresión logística
Para entender cómo funciona una red, lo mejor es empezar por un solo ejemplo y una sola neurona. Supongamos que queremos predecir si una zapatilla será un éxito de ventas a partir de una sola característica, por ejemplo su precio \(x\).
Empecemos con la versión más simple: usamos esa única característica \(x\) como entrada. Como vimos en la regresión logística, podemos ajustar una función sigmoidea que nos da la probabilidad de que la zapatilla tenga éxito:
donde \(w\) es un peso, \(b\) es un sesgo y \(\sigma\) es la función sigmoidea. A esta salida \(a\) se le llama activación, un término tomado de la neurociencia que indica “cuánta señal” envía esa neurona a las siguientes.
La Figura 1 muestra que una neurona artificial no es más que esa misma operación dibujada como un pequeño diagrama de flujo.
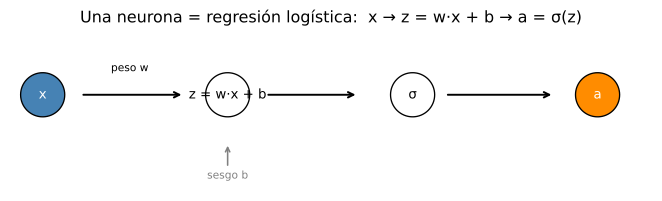
Figura 1: Una neurona artificial es, en esencia, una regresión logística: recibe una entrada x, calcula una combinación lineal z = w·x + b (más el sesgo b) y la pasa por una función de activación σ para producir la activación a.
4 De una neurona a una red: el ejemplo de las zapatillas
Una sola característica es limitada. En la vida real influyen muchas: para predecir si una zapatilla se venderá bien intervienen su precio, el material, el estilo y la marca. Construyamos una red conceptual para estimar esa probabilidad de éxito.
Agrupamos las cuatro características de entrada (precio, material, estilo, marca) en una capa de entrada. Luego introducimos una capa oculta con tres neuronas, cada una especializada en un concepto intermedio que combina las entradas:
- la comodidad depende del material y del estilo;
- el estatus (imagen de marca) depende de la marca y del estilo;
- la relación calidad-precio depende del precio y del material.
Las salidas de esas tres neuronas se conectan a una neurona de salida que combina todo y produce la probabilidad final de éxito de ventas. La Figura 2 dibuja esa arquitectura.
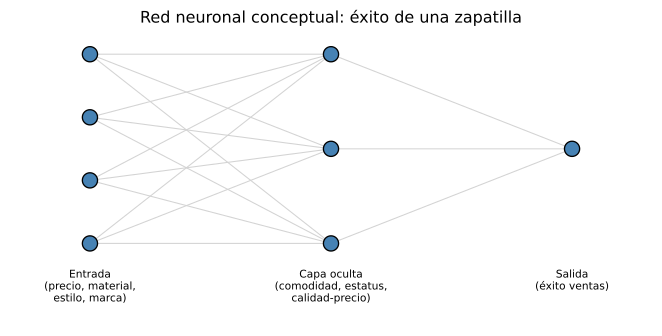
Figura 2: Red neuronal conceptual para predecir el éxito de ventas de una zapatilla. La capa de entrada son las 4 características; la capa oculta aprende conceptos intermedios combinando las entradas (comodidad, estatus, relación calidad-precio); la capa de salida produce la probabilidad final. Cada neurona de una capa recibe las activaciones de todas las de la capa anterior.
El punto clave es que las características originales no llegan directamente a la salida: primero se combinan en la capa oculta para crear nuevas características (comodidad, estatus, relación calidad-precio) que la salida ya utiliza. Cuantas más capas haya, más niveles de combinación en cascada.
En la terminología de las redes neuronales, agrupamos las neuronas en capas. La de entrada son las características originales; la de salida es la predicción; las intermedias son las capas ocultas. La propiedad clave es que cada neurona de una capa tiene acceso a todas las activaciones de la capa anterior. Eso permite que la red aprenda por sí misma qué combinaciones de características importan, en lugar de que nosotros se las escribamos a mano.
Una red “profunda” es simplemente una red con varias capas ocultas. Cuantas más capas, más niveles de abstracción puede representar —y por eso este enfoque se llama aprendizaje profundo.
5 Reconocimiento de imágenes: aprender características automáticamente
El mismo esquema sirve para algo muy distinto: reconocer qué hay en una foto. Una imagen se representa como una matriz de píxeles; cada valor es el brillo en una posición. Esa matriz se “aplana” en un vector de características que entra a la red.
La magia está en las capas ocultas. En las primeras capas las neuronas suelen detectar cosas simples: bordes y líneas cortas. En capas posteriores, esas detecciones se combinan para formar partes —ojos, narices, ruedas— y, más arriba aún, objetos completos. La Figura 3 ilustra esa pirámide de abstracción.
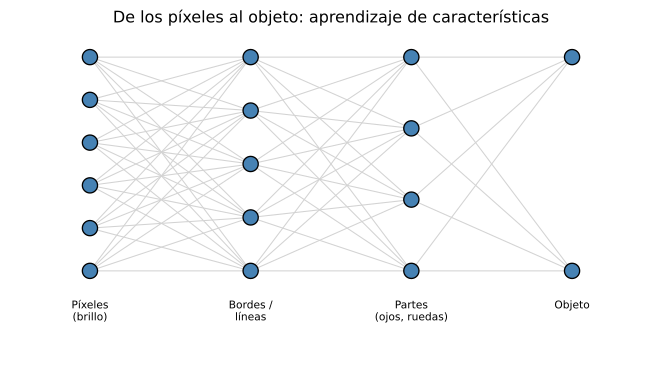
Figura 3: Reconocimiento de imágenes como pirámide de abstracción: del brillo de los píxeles (abajo) se pasa a bordes, luego a partes (ojos, ruedas) y finalmente al objeto (arriba). La red aprende estos detectores automáticamente a partir de los datos.
Lo más sorprendente es que la red aprende estos detectores a partir de los ejemplos de entrenamiento: nadie le programa “busca una rueda”. Si le das fotos de coches, aprende las ruedas; si le das rostros, aprende los ojos. La red se adapta sola al conjunto de datos.
6 Funciones de activación
En la propagación hacia adelante, cada neurona combina sus entradas en \(z = w \cdot x + b\) y luego aplica una función de activación \(g\) para producir su activación \(a = g(z)\).
6.1 ¿Por qué no lineal?
Si usáramos la función lineal \(g(z) = z\) en todas partes, la red colapsaría a una simple regresión lineal. Para verlo, basta una red mínima de dos capas con una sola unidad oculta:
La salida es lineal en \(x\). La composición de funciones lineales vuelve a ser lineal, así que apilar capas no aporta nada: varias capas lineales equivalen a una sola capa lineal. Por eso las capas ocultas deben usar una activación no lineal; si no, la red no puede capturar relaciones más allá de una recta.
6.2 Las funciones más comunes
- Sigmoide \(\sigma(z) = \frac{1}{1+e^{-z}}\): mapea a \((0,1)\). Ideal para la capa de salida en clasificación binaria, porque da una probabilidad.
- Tangente hiperbólica \(\tanh(z) = \frac{e^{z}-e^{-z}}{e^{z}+e^{-z}}\): mapea a \((-1,1)\). Similar a la sigmoide pero centrada en \(0\).
- ReLU \(\max(0, z)\): la favorita en las capas ocultas por su sencillez y porque evita el problema del gradiente que desaparece.
- Leaky ReLU: como ReLU pero con una pequeña pendiente para \(z < 0\), para no bloquear del todo las neuronas “muertas”.
- Lineal (identidad) \(g(z) = z\): equivale a “no aplicar activación”; útil en la salida de un problema de regresión.
La Figura 4 las compara en un mismo gráfico.
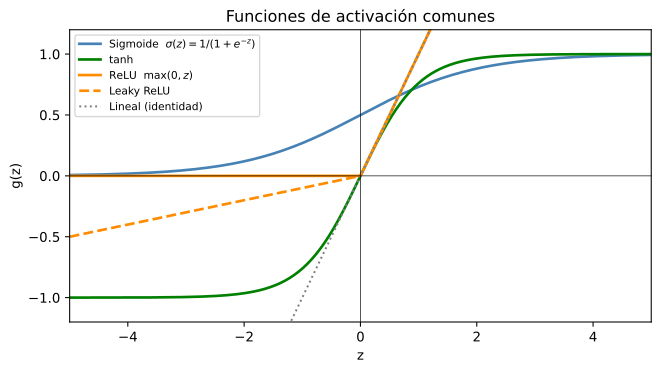
Figura 4: Funciones de activación comunes: sigmoide y tanh mapean a un rango acotado, ReLU deja pasar lo positivo y corta lo negativo, y la lineal es la identidad. Cada una tiene su lugar según la capa y el problema.
6.3 ¿Cómo elegir la activación?
La regla general depende de la capa y del problema:
- Capa de salida:
- clasificación binaria (\(y \in \{0,1\}\)) \(\rightarrow\) sigmoide (predice \(P(y=1)\));
- clasificación multiclase \(\rightarrow\) softmax
- regresión con \(y\) que puede ser positivo o negativo (p.ej. cambio de precio de una acción) \(\rightarrow\) lineal;
- regresión con \(y\) no negativo (p.ej. precio de una casa) \(\rightarrow\) ReLU.
- Capas ocultas: hoy en día la opción por defecto es ReLU (o Leaky ReLU).
¿Por qué se prefiere ReLU en las ocultas? por eficiencia en los calculos y resultados.
6.4 Derivadas y el gradiente que desaparece
Para entrenar con descenso del gradiente necesitamos la derivada de \(g\), porque el gradiente se propaga multiplicando estas derivadas capa a capa. La sigmoide y la tanh se aplanan para valores grandes (positivos o negativos) de \(z\): su derivada se acerca a \(0\). Concretamente,
Eso significa que, salvo cerca de \(z=0\), el gradiente es pequeño; al atravesar muchas capas se va haciendo minúsculo y el aprendizaje se congela (vanishing gradient). En cambio, la derivada de ReLU vale \(1\) para \(z > 0\), así que el gradiente se mantiene sano. La Figura 5 lo muestra.
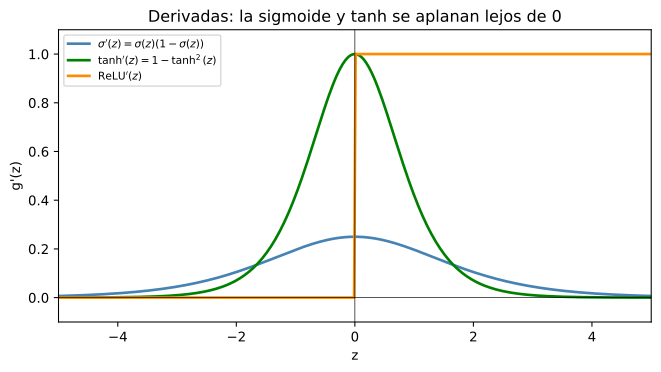
Figura 5: Derivadas de las activaciones. La sigmoide y la tanh se aplanan lejos de z=0 (gradiente casi nulo, problema del gradiente que desaparece); la derivada de ReLU vale 1 para z>0 y mantiene el gradiente vivo.