Matemáticas de la red neuronal
Documentos de esta sección
Este documento presenta la arquitectura de la red y fija los valores numéricos de pesos, sesgos y entradas. Los cálculos paso a paso están en documentos separados:
- Propagación hacia adelante: cálculo de \(z^{[l]}\) y \(a^{[l]}\) capa a capa, de las entradas a la predicción \(\hat{y}\).
- Backpropagation: cálculo de cada derivada parcial \(\partial L/\partial w\) y \(\partial L/\partial b\), capa a capa y hacia atrás, para actualizar los parámetros con descenso de gradiente.
1 El esquema de la red
Para fijar ideas, empezamos por el dibujo de una red concreta: dos entradas, dos capas ocultas (de 3 y 2 neuronas) y una salida. La Figura 1 muestra la arquitectura y la notación que usaremos a partir de ahora.
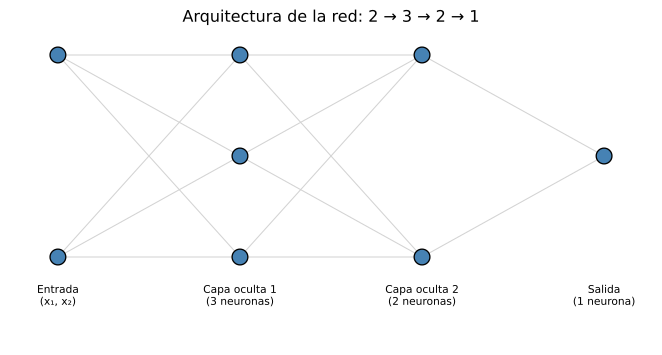
Figura 1: Esquema de la red: capa de entrada (x1, x2), primera capa oculta (3 neuronas), segunda capa oculta (2 neuronas) y capa de salida (1 neurona). Cada neurona recibe todas las activaciones de la capa anterior.
En la notación de la red, las capas se numeran con corchetes: la capa de entrada son \(x_1, x_2\); la primera capa oculta produce las activaciones \(a^{[1]}_1, a^{[1]}_2, a^{[1]}_3\); la segunda capa oculta produce \(a^{[2]}_1, a^{[2]}_2\); y la salida es \(\hat{y}\). Cada flecha lleva un peso, y cada neurona suma sus entradas ponderadas, suma un sesgo y aplica una función de activación.
¿Qué tipo de red es esta?
La arquitectura que acabamos de dibujar es una red neuronal totalmente conectada (o densamente conectada, en inglés fully-connected): cada neurona recibe todas las activaciones de la capa anterior, sin saltos ni conexiones que se realimenten. Apiladas en serie y con una sola dirección (entrada → salida) constituye un perceptrón multicapa (Multilayer Perceptron, MLP), el modelo de red neuronal más clásico. Más adelante encontraremos arquitecturas distintas (convolucionales, recurrentes…), pero todas parten de estas mismas ideas de propagación y retropropagación.
El cálculo de \(\hat{y}\) a partir de estos valores se explica en propagación hacia adelante.
2 Los valores de la red
Para no trabajar con símbolos abstractos, fijamos ya unos números concretos. Asignamos un valor a cada entrada, a cada peso (el número de cada flecha) y a cada sesgo (el número de cada neurona). La Figura 2 muestra la red completa con sus valores.
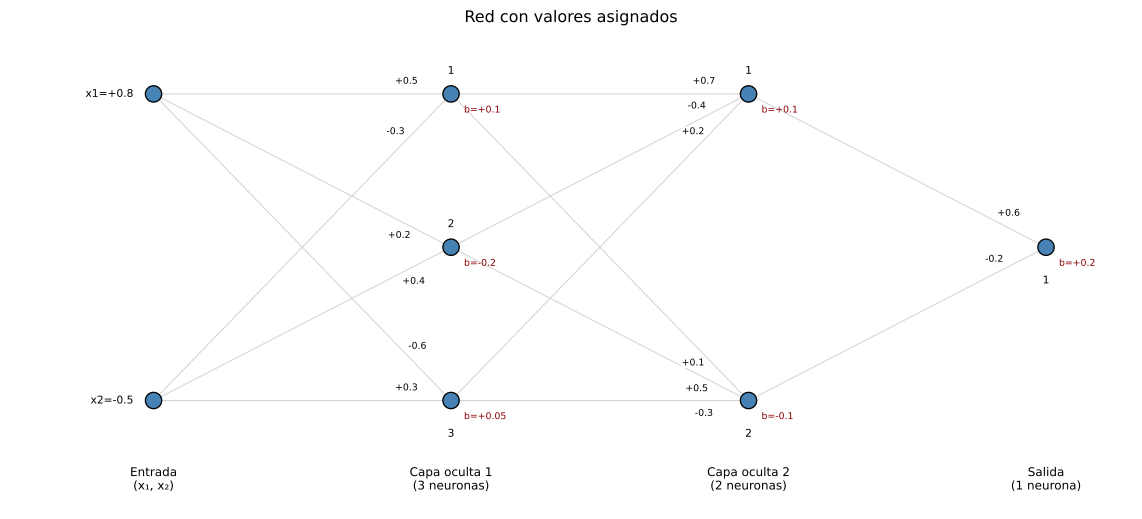
Figura 2: La misma red con valores numéricos: en las entradas (x₁, x₂), en cada flecha (peso, sobre su recta) y en cada neurona (sesgo, en rojo y a la derecha del número). Las neuronas llevan su número (1 arriba).
Los valores elegidos, neurona por neurona, son los siguientes:
Entradas
\(x_1 = 0.8\), \(x_2 = -0.5\).
Capa oculta 1 (recibe \(x_1, x_2\)) - Neurona 1: pesos \(0.5, -0.3\); sesgo \(0.1\). - Neurona 2: pesos \(0.2, 0.4\); sesgo \(-0.2\). - Neurona 3: pesos \(-0.6, 0.3\); sesgo \(0.05\).
Capa oculta 2 (recibe \(a^{[1]}_1, a^{[1]}_2, a^{[1]}_3\)) - Neurona 1: pesos \(0.7, -0.4, 0.2\); sesgo \(0.1\). - Neurona 2: pesos \(0.1, 0.5, -0.3\); sesgo \(-0.1\).
Capa de salida (recibe \(a^{[2]}_1, a^{[2]}_2\)) - Neurona 1: pesos \(0.6, -0.2\); sesgo \(0.2\).
Con estos números ya tenemos todo lo necesario. Los siguientes documentos desarrollan los cálculos:
- Propagación hacia adelante: cómo a partir de estos pesos, sesgos y entradas se obtiene la predicción \(\hat{y}\) paso a paso.
- Backpropagation: cómo se calculan las derivadas del error respecto a cada parámetro para entrenar la red con descenso de gradiente.