Análisis de Componentes Principales (PCA)
1 Introducción
A menudo trabajamos con datos que tienen muchas variables: una imagen de 28×28 píxeles son 784 variables; un conjunto de datos genético puede tener decenas de miles. Tener tanta dimensionalidad trae problemas: los algoritmos se vuelven lentos, los gráficos son imposibles de dibujar y, sobre todo, los modelos sufren la maldición de la dimensionalidad (con tantas variables, los datos quedan dispersos y “cercano” deja de ser útil, como vimos en KNN).
La reducción de dimensionalidad consiste en comprimir los datos a menos variables conservando la mayor información posible. El Análisis de Componentes Principales (Principal Component Analysis, PCA) es la técnica lineal más usada. Es un método no supervisado: no mira las etiquetas, solo la estructura de los propios datos.
La idea de PCA se puede resumir en una frase:
Encontrar las direcciones en las que los datos varían más, y proyectar sobre ellas.
Esas direcciones son las componentes principales. Cuanto más “se estiran” los datos en una dirección, más información (varianza) conservamos al proyectar sobre ella.
2 La intuición: proyectar para conservar la varianza
Imagina un conjunto de puntos en 2D que forma una elipse alargada, como una nube estirada en diagonal. Si tuvieras que representar esos puntos en una sola dimensión (una línea), ¿qué línea elegirías?
- Si los proyectas sobre el eje horizontal (\(x_1\)), los puntos quedan amontonados y pierdes la forma alargada.
- Si los proyectas sobre la dirección de mayor extensión (la diagonal), conservas casi toda la separación entre ellos.
Esa dirección de mayor extensión es la primera componente principal. La Figura 1 lo muestra: los ejes principales (flechas) son precisamente las direcciones donde la nube se estira más y menos.
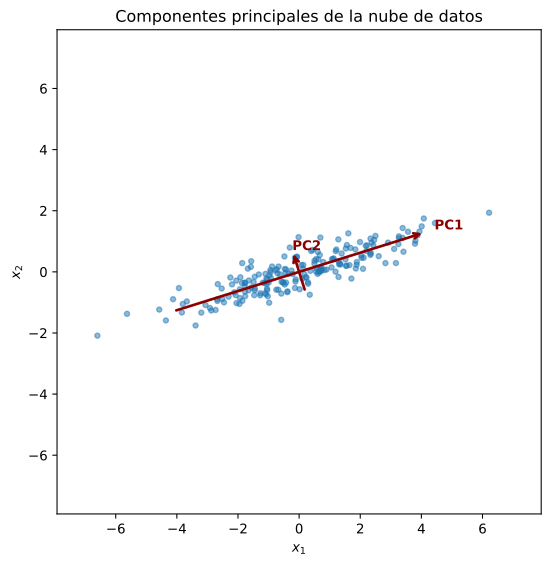
Figura 1: Nube de datos y sus dos componentes principales. PC1 apunta donde los datos se extienden más; PC2, donde menos.
La segunda componente principal es la dirección de máxima varianza entre las que son ortogonales (perpendiculares) a la primera, y así sucesivamente. Cada componente explica menos que la anterior.
3 El problema matemático
Sea \(x\) una observación (un vector de \(p\) variables) ya centrada (media cero). Queremos encontrar una dirección \(w\) (con \(\|w\|=1\)) sobre la cual proyectar, \(z = w^T x\), de forma que la varianza de esas proyecciones sea máxima:
donde \(\Sigma\) es la matriz de covarianza de los datos. Este es un problema clásico de cociente de Rayleigh: su solución es el autovector de \(\Sigma\) asociado al mayor autovalor (ver el capítulo de Autovalores y autovectores).
Por tanto:
- Las componentes principales son los autovectores de la matriz de covarianza.
- El autovalor asociado mide cuánta varianza explica esa componente.
- Se ordenan de mayor a menor autovalor: \(PC_1, PC_2, \dots, PC_p\).
La proyección de los datos sobre las \(k\) primeras componentes es, simplemente, multiplicar los datos centrados por la matriz \(W_k\) cuyas columnas son esos autovectores (un cambio de base, como se explica en Transformaciones lineales).
4 El algoritmo paso a paso
Dado un conjunto de datos \(X\) de tamaño \(n \times p\):
- Centrar. Restar la media de cada variable: \(X_c = X - \bar x\). (PCA solo captura la variabilidad, no la posición media.)
- Covarianza. Calcular \(\Sigma = \frac{1}{n} X_c^T X_c\) (matriz \(p \times p\)).
- Autovectores y autovalores. Descomponer \(\Sigma\): sus autovectores son las direcciones de las componentes y sus autovalores, la varianza explicada por cada una.
- Ordenar. Ordenar las componentes de mayor a menor autovalor.
- Proyectar. Construir la matriz reducida \(Z = X_c W_k\) (las \(k\) primeras columnas) para pasar de \(p\) a \(k\) dimensiones.
- Varianza explicada. La proporción que conserva la componente \(i\) es \(\lambda_i / \sum_j \lambda_j\).
Importante
Al igual que KNN, PCA depende de la escala. Si una variable vale miles y otra unos pocos, la primera dominará la covarianza. Por eso, antes de aplicar PCA, casi siempre se estandarizan las variables (media 0, desviación 1).
5 Ejemplo numérico: PCA a mano en 2D
Tomemos un pequeño conjunto de 4 puntos en dos dimensiones:
| Punto | \(x_1\) | \(x_2\) |
|---|---|---|
| 1 | 5 | 5 |
| 2 | 1 | 3 |
| 3 | 4 | 6 |
| 4 | 2 | 2 |
Paso 1. Centrar. La media es \(\bar x = (3, 4)\). Restamos y obtenemos los datos centrados:
| Punto | \(x_1^c\) | \(x_2^c\) |
|---|---|---|
| 1 | 2 | 1 |
| 2 | −2 | −1 |
| 3 | 1 | 2 |
| 4 | −1 | −2 |
Paso 2. Covarianza. Con \(n=4\), la matriz se calcula como \(\Sigma = \frac{1}{n} X_c^T X_c\). Cada entrada \((i,j)\) es el promedio de los productos \(x_i^c \cdot x_j^c\) punto a punto (la fila \(\cdot\) indica “igual que arriba”, por simetría):
Desarrollamos cada suma por separado, usando los valores centrados \(x_1^c = (2,-2,1,-1)\) y \(x_2^c = (1,-1,2,-2)\):
- \(\Sigma_{11}\) (varianza de \(x_1\)): \(\frac14\big(2^2+(-2)^2+1^2+(-1)^2\big) = \frac14(4+4+1+1) = \frac{10}{4} = 2.5\).
- \(\Sigma_{12} = \Sigma_{21}\) (covarianza entre \(x_1\) y \(x_2\)): \(\frac14\big(2\cdot1+(-2)(-1)+1\cdot2+(-1)(-2)\big) = \frac14(2+2+2+2) = \frac{8}{4} = 2.0\).
- \(\Sigma_{22}\) (varianza de \(x_2\)): \(\frac14\big(1^2+(-1)^2+2^2+(-2)^2\big) = \frac14(1+1+4+4) = \frac{10}{4} = 2.5\).
Por tanto:
Paso 3. Autovectores y autovalores. Para una matriz \(\begin{pmatrix} a & b \\ b & a \end{pmatrix}\) los autovalores son \(a+b\) y \(a-b\):
Los autovectores (normalizados) son:
Paso 4 y 5. Proyectar sobre PC₁. Cada punto centrado se proyecta como \(z = v_1^T x^c = (x_1^c + x_2^c)/\sqrt{2}\):
| Punto | Proyección en PC₁ |
|---|---|
| 1 | \(3/\sqrt{2} \approx 2.12\) |
| 2 | \(-3/\sqrt{2} \approx -2.12\) |
| 3 | \(3/\sqrt{2} \approx 2.12\) |
| 4 | \(-3/\sqrt{2} \approx -2.12\) |
Paso 6. Varianza explicada. La proporción conservada por PC₁ es
¡Hemos pasado de 2 dimensiones a 1 conservando el 90 % de la varianza! Verifiquémoslo con código:
import numpy as np
from sklearn.decomposition import PCA

X = np.array([[5., 5], [1, 3], [4, 6], [2, 2]])
pca = PCA().fit(X)

print("Medias:", pca.mean_)
print("Autovalores (varianza):", pca.explained_variance_)
print("Varianza explicada por componente:", pca.explained_variance_ratio_)
print("Componentes (autovectores):\n", pca.components_)
Medias: [3. 4.]
Autovalores (varianza): [6.         0.66666667]
Varianza explicada por componente: [0.9 0.1]
Componentes (autovectores):
 [[ 0.70710678  0.70710678]
 [-0.70710678  0.70710678]]
Nota
En nuestro cálculo a mano la covarianza divide por \(n=4\) y los autovalores salen \(4.5\) y \(0.5\). Scikit-learn usa la covarianza muestral (divide por \(n-1=3\)), así que aquí verás \(6.0\) y \(0.667\). La proporción de varianza explicada (explained_variance_ratio_) es idéntica en ambos casos: \(0.90\) y \(0.10\).
5.1 Proyectar una nueva observación
Hasta aquí proyectamos los propios datos de entrenamiento. Pero PCA es útil sobre todo para nuevas entidades: una vez ajustado, guardamos la media \(\mu\) y los vectores componentes \(w_1, w_2\), y aplicamos la misma transformación a cualquier punto \(x\) que llegue después.
El procedimiento es idéntico al Paso 5, pero para un solo punto:
- Centrar con la media del entrenamiento: \(x_c = x - \mu\).
- Proyectar sobre cada componente (producto punto): \(z_i = w_i^T x_c\).
Supongamos que llega una observación nueva \(x = (4, 5)\). La media del entrenamiento es \(\mu = (3, 4)\), así que:
Con \(w_1 = \tfrac{1}{\sqrt2}(1,1)\) y \(w_2 = \tfrac{1}{\sqrt2}(1,-1)\):
La entidad en el espacio PCA es \(z \approx (1.41,\, 0)\): cae casi toda en PC1, que explica el 90 % de la varianza. (El signo de las componentes es arbitrario: si \(w_1\) saliera como \((-1,-1)/\sqrt2\), el resultado sería \(-1.41\); es el mismo eje, en sentido contrario.)
Lo mismo, de forma automática, con pca.transform:
import numpy as np
from sklearn.decomposition import PCA

X = np.array([[5., 5], [1, 3], [4, 6], [2, 2]])
pca = PCA().fit(X)

x_nueva = np.array([[4., 5]])
z = pca.transform(x_nueva)
print("Coordenadas en el espacio PCA:", z)   # [[1.414 0.]]
Fíjate en que transform no reajusta nada: reutiliza la media (pca.mean_) y los componentes aprendidos. Por eso siempre hay que centrar con la media del entrenamiento, nunca recalcularla con la nueva observación.
Guardar el modelo para reutilizarlo. En la práctica se entrena el PCA una sola vez con los datos de entrenamiento y luego se guarda (p. ej. con joblib) para aplicar transform sobre datos futuros, sin volver a hacer fit:
import joblib
joblib.dump(pca, "pca.joblib")
# en otra sesión:
pca_guardado = joblib.load("pca.joblib")
z = pca_guardado.transform(X_nuevos)
Lo recomendable es guardar el pipeline completo (escalado + PCA) para que el preprocesado se aplique siempre igual. Volver a hacer fit con datos nuevos sería un error: recalcularía los componentes y daría una base distinta.
6 ¿Cuánta dimensionalidad conservar?
No siempre reducimos a 1 o 2 dimensiones. Lo habitual es elegir \(k\) de forma que la varianza acumulada supere un umbral (por ejemplo, el 95 %). Para decidirlo se usa el scree plot: una gráfica de la varianza explicada por cada componente y su suma acumulada.
La Figura 2 muestra este gráfico sobre el conocido conjunto iris (4 variables). Se ve cómo las primeras componentes explican mucho y las últimas apenas aportan.
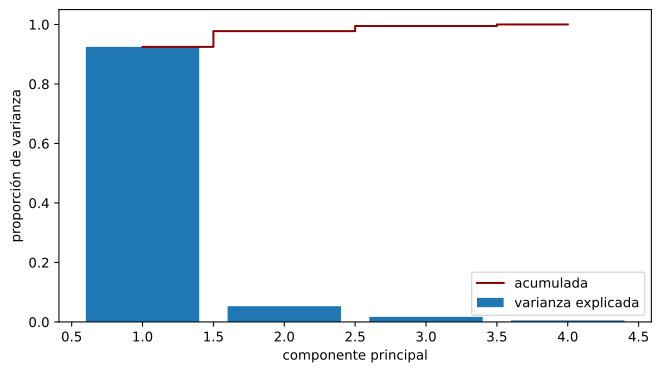
Figura 2: Scree plot del conjunto iris: varianza explicada por componente (barras) y acumulada (línea).
Una regla práctica: se elige el número de componentes necesarias para superar ~0.95 de varianza acumulada, o bien se corta justo antes de que la curva “se aplane” (el codo del gráfico).
7 Ejemplo visual: iris en dos dimensiones
Un uso muy frecuente de PCA es la visualización: proyectar datos de muchas dimensiones a 2D para dibujarlos. La Figura 3 proyecta el conjunto iris (4 variables) a sus dos primeras componentes; aunque perdemos información, las especies siguen siendo distinguibles en buena medida.
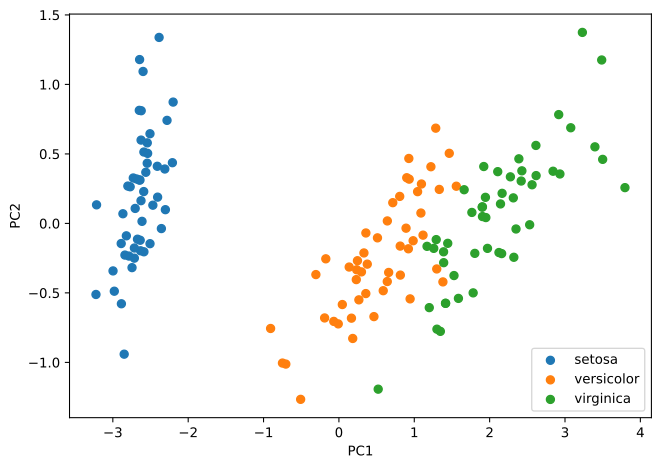
Figura 3: Conjunto iris proyectado a las dos primeras componentes principales, coloreado por especie.
8 Consideraciones y limitaciones
- Es lineal. PCA solo captura relaciones lineales. Si la estructura es curva o compleja, otras técnicas (como t-SNE o UMAP) pueden funcionar mejor para visualizar.
- Sensible a la escala. Estandariza siempre que las variables tengan unidades o rangos distintos.
- Sensible a valores atípicos. Un solo punto lejano puede arrastrar las componentes.
- La varianza no es igual a “información útil”. En clasificación, la dirección de máxima varianza no siempre separa mejor las clases; por eso PCA se usa como preprocesamiento, no como sustituto de un modelo.
- Las componentes son combinaciones lineales de todas las variables, por lo que pierden la interpretabilidad directa de las variables originales.
9 Demo ejecutable
Aplicamos PCA a un conjunto de datos de vinos (13 variables químicas). Estandarizamos primero y luego vemos cuánta varianza explican las componentes y cuántas necesitamos para llegar al 95 %.
from sklearn.datasets import load_wine
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA

datos = load_wine()
X_est = StandardScaler().fit_transform(datos.data)

pca = PCA().fit(X_est)
evr = pca.explained_variance_ratio_
acumulada = np.cumsum(evr)

k_95 = int(np.searchsorted(acumulada, 0.95) + 1)
print("Varianza explicada por las 3 primeras componentes:",
      np.round(evr[:3], 3))
print("Varianza acumulada con 3 componentes:", round(acumulada[2], 3))
print(f"Componentes necesarias para el 95 % de varianza: {k_95} de {len(evr)}")
print("¡Reducción de 13 variables a", k_95, "conservando el 95 % de la varianza!")
Varianza explicada por las 3 primeras componentes: [0.362 0.192 0.111]
Varianza acumulada con 3 componentes: 0.665
Componentes necesarias para el 95 % de varianza: 10 de 13
¡Reducción de 13 variables a 10 conservando el 95 % de la varianza!