Matemáticas y Backpropagation de la Capa Convolucional
Navegación en esta sección
Capítulo conceptual base: Redes neuronales convolucionales (CNN) — fundamentos de la operación de convolución, padding, stride, múltiples canales y pooling.
Estás en Matemáticas de la capa convolucional (cálculo numérico manual de la propagación hacia adelante, retropropagación de pesos compartidos y gradient checking).
1 Caso 1: Un canal de entrada y un filtro (\(1 \to 1\))
Para comprender a fondo cómo aprende una capa convolucional, comenzaremos con el escenario más directo: una imagen de un solo canal y un único filtro convolucional. Calcularemos paso a paso todas las operaciones del ciclo de entrenamiento (forward pass, cálculo de coste, backward pass, actualización de parámetros y gradient checking).
1.1 Planteamiento del problema: red, entrada y función de coste
- Entrada (\(X\)): Una matriz bidimensional en escala de grises de \(5 \times 5\):
-
Capa convolucional:
-
Filtro / Kernel (\(W\)): Una matriz de \(3 \times 3\) con pesos fijos iniciales:
- Sesgo (\(b\)): Un valor escalar \(b = 1\).
- Convolución sin relleno (Valid, \(P=0\)) y paso \(S=1\).
-
Activación lineal (\(a = z\)) para aislar y clarificar la mecánica algebraica de las derivadas sin distorsión no lineal.
-
Capa densa de salida (MLP):
-
Los \(3 \times 3 = 9\) valores del mapa de activaciones se aplanan (Flatten) en un vector columna \(z = [z_1, z_2, \dots, z_9]^T\).
- Se conectan a una única neurona de salida mediante un vector de pesos \(w_{\text{FC}}\) (sin sesgo en la capa densa):
-
La predicción final escalar es \(\hat{y} = w_{\text{FC}}^T z\).
-
Valor esperado y función de coste:
-
La etiqueta objetivo real es \(y = 6\).
- Empleamos la función de coste del Error Cuadrático Medio (MSE) para una muestra (\(m=1\)):
1.2 Propagación hacia adelante (Forward Pass)
1.2.1 Cálculo del mapa de características (\(Z\))
Al aplicar un filtro \(3 \times 3\) sobre una entrada \(5 \times 5\) sin padding (\(P=0\)) y con paso \(S=1\), el mapa de características resultante \(Z\) tiene dimensiones de \((5 - 3 + 1) \times (5 - 3 + 1) = 3 \times 3\).
Cada celda \(Z(i, j)\) (con índices \(i, j \in \{0, 1, 2\}\)) se calcula superponiendo el kernel \(W\), multiplicando elemento a elemento con la submatriz de entrada correspondiente y sumando el sesgo \(b=1\):
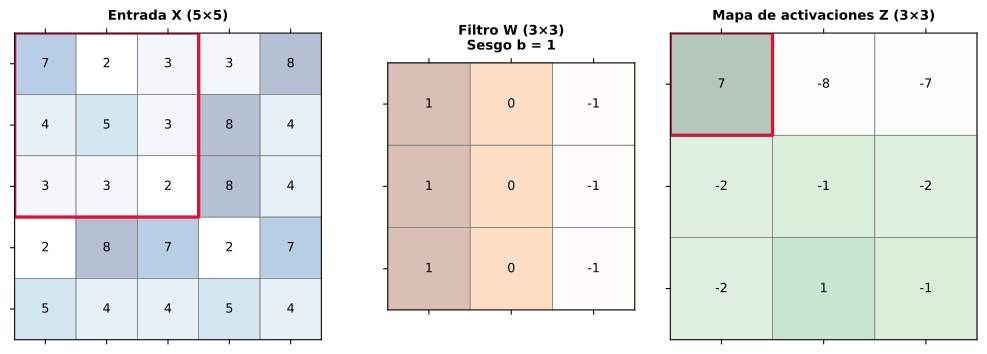
Figura 1: Propagación hacia adelante: la entrada 5×5 (izquierda) se convoluciona con el kernel 3×3 y sesgo b=1 (centro) para generar el mapa de características Z de 3×3 (derecha).
1.2.1.1 Detalle de las 9 celdas del mapa
- Celda \((0,0)\):
- Celda \((0,1)\):
- Celda \((0,2)\):
- Celda \((1,0)\):
- Celda \((1,1)\):
- Celda \((1,2)\):
- Celda \((2,0)\):
- Celda \((2,1)\):
- Celda \((2,2)\):
La matriz completa del mapa de características es:
1.2.2 Aplanado y cálculo de la predicción (\(\hat{y}\)) y coste (\(J\))
Aplanamos la matriz \(Z\) fila a fila en un vector unidimensional \(z \in \mathbb{R}^9\):
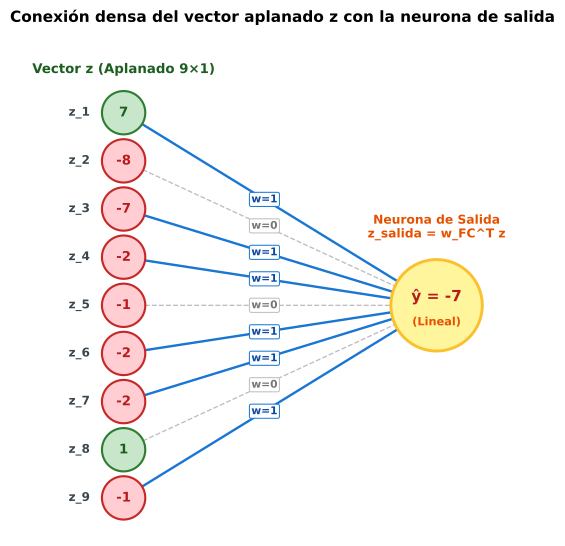
Figura 2: Conexión densa del vector aplanado z (9×1) con la neurona de salida lineal: cada componente z_k se multiplica por su peso w_FC,k y se suman todos los productos para obtener z_salida = -7.
Calculamos la pre-activación de la capa densa de salida \(z_{\text{salida}}\) multiplicando por el vector de pesos \(w_{\text{FC}} = [1, 0, 1, 1, 0, 1, 1, 0, 1]^T\):
Al tener una función de activación lineal (identidad, \(g(u) = u\)), la predicción es \(\hat{y} = g(z_{\text{salida}}) = z_{\text{salida}} = \mathbf{-7}\).
Calculamos el coste del error cuadrático medio con respecto al valor esperado \(y = 6\):
1.3 Propagación hacia atrás (Backward Pass)
Definición de Delta (δ)
Recordemos la convención fundamental: el delta (\(\delta\)) de una neurona es siempre la derivada parcial del coste respecto a su pre-activación \(z\) (la suma ponderada antes de la función de activación):
El delta es el “mensajero” que transporta la señal de error hacia atrás a través de las capas.
1.3.1 Delta de la neurona de salida (\(\delta_{\text{salida}}\))
Por definición, el delta de la neurona de salida es la derivada parcial del coste \(J\) respecto a su pre-activación \(z_{\text{salida}}\):
Aplicando la regla de la cadena:
1.3.2 Retropropagación al mapa de características (\(\delta_Z\))
La señal de error retrocede a través de la capa densa hacia cada una de las 9 neuronas del mapa aplanado \(z\).
Como \(z_{\text{salida}} = \sum_{j=1}^9 w_{\text{FC}, j} \cdot z_j\), la derivada parcial es \(\frac{\partial z_{\text{salida}}}{\partial z_k} = w_{\text{FC}, k}\). Aplicando la regla de la cadena, el delta de la neurona \(k\)-ésima del mapa de características es:
Calculando para cada posición:
Reconstruimos la matriz bidimensional de gradientes espaciales \(\delta_Z\) (\(3 \times 3\)):
1.4 Gradiente respecto al sesgo (\(\partial J / \partial b\))
En una capa convolucional, todas las neuronas del mapa de características comparten exactamente el mismo sesgo escalar \(b\).
Por la regla de la cadena multivariable, la derivada total de la función de coste respecto a \(b\) es la suma de las derivadas a través de todas las celdas \((p, q)\) donde intervino:
Dado que \(Z(p, q) = \dots + b\), la derivada parcial directa es siempre \(\frac{\partial Z(p, q)}{\partial b} = 1\). Por consiguiente:
Sumamos los 9 valores de la matriz \(\delta_Z\):
1.5 Gradiente respecto a los pesos del kernel (\(\partial J / \partial W\))
Este es el cálculo central de las redes convolucionales: ¿cómo se calcula el gradiente de un peso \(w_{i,j}\) que se ha reutilizado al deslizar el filtro por toda la imagen?
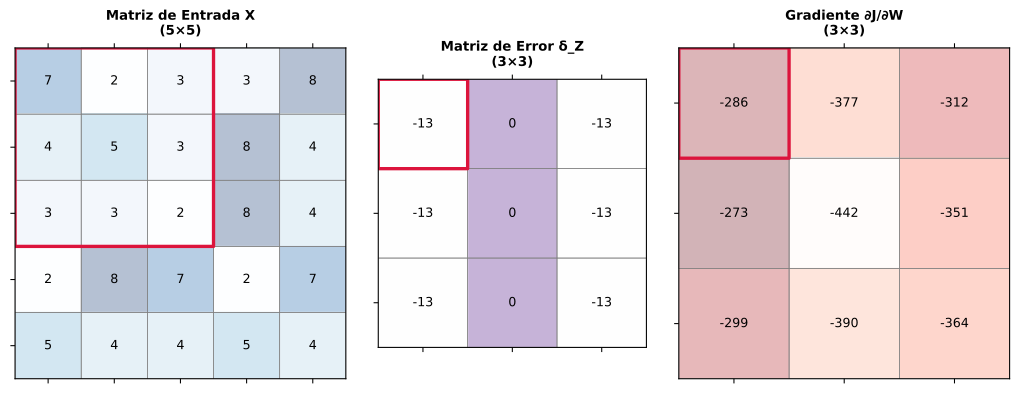
Figura 3: Cálculo del gradiente de los pesos ∂J/∂W: cada celda del kernel W afectó a múltiples salidas Z(p,q). Su gradiente total es la convolución de la entrada X con la matriz de errores δ_Z.
1.5.1 Fórmula general del gradiente con pesos compartidos
Cada peso \(W(i, j)\) del kernel (para \(i, j \in \{0, 1, 2\}\)) multiplica al elemento \(X(p+i, q+j)\) en la posición \((p, q)\) de la ventana deslizante. Por tanto, su derivada es la suma acumulada de los productos del error \(\delta_Z(p, q)\) por el píxel de entrada correspondiente:
1.5.2 Cálculo detallado de los 9 pesos
1.5.2.1 1. Gradiente del peso \(W(0, 0)\) (Esquina superior izquierda)
El peso \(W(0, 0)\) interactúa con las entradas \(X(p, q)\) para cada una de las 9 posiciones \((p, q)\) del mapa:
1.5.2.2 2. Gradiente del peso \(W(0, 1)\) (Fila 0, Columna 1)
El peso \(W(0, 1)\) interactúa con las entradas \(X(p, q+1)\):
1.5.2.3 3. Gradiente del peso \(W(0, 2)\) (Fila 0, Columna 2)
El peso \(W(0, 2)\) interactúa con \(X(p, q+2)\):
1.5.2.4 4. Gradientes de la Fila 1
- \(W(1, 0)\) (interactúa con \(X(p+1, q)\)):
- \(W(1, 1)\) (interactúa con \(X(p+1, q+1)\)):
- \(W(1, 2)\) (interactúa con \(X(p+1, q+2)\)):
1.5.2.5 5. Gradientes de la Fila 2
- \(W(2, 0)\) (interactúa con \(X(p+2, q)\)):
- \(W(2, 1)\) (interactúa con \(X(p+2, q+1)\)):
- \(W(2, 2)\) (interactúa con \(X(p+2, q+2)\)):
1.5.3 Matriz completa del gradiente \(\partial J / \partial W\)
1.6 Verificación numérica del gradiente (Gradient Checking)
Para tener la certeza matemática absoluta de que las derivadas obtenidas analíticamente son exactas, aplicamos el método de comprobación numérica de gradientes (gradient checking).
Modificamos el peso \(W(0, 0)\) sumándole una perturbación minúscula \(\epsilon = 0.001\):
Repetimos la propagación hacia adelante con este nuevo peso:
-
Nuevo mapa de activaciones \(Z_{\text{nuevo}}\): Como \(W(0, 0)\) multiplica a las entradas \(X(0,0)=7\), \(X(0,2)=3\), \(X(1,0)=4\), \(X(1,2)=3\), \(X(2,0)=3\) y \(X(2,2)=2\) en las posiciones donde \(\delta \neq 0\):
-
\(Z_{\text{nuevo}}(0,0) = 7 + 0.001 \times 7 = 7.007\)
- \(Z_{\text{nuevo}}(0,2) = -7 + 0.001 \times 3 = -6.997\)
- \(Z_{\text{nuevo}}(1,0) = -2 + 0.001 \times 4 = -1.996\)
- \(Z_{\text{nuevo}}(1,2) = -2 + 0.001 \times 3 = -1.997\)
- \(Z_{\text{nuevo}}(2,0) = -2 + 0.001 \times 3 = -1.997\)
-
\(Z_{\text{nuevo}}(2,2) = -1 + 0.001 \times 2 = -0.998\)
-
Nueva predicción \(\hat{y}_{\text{nuevo}}\):
- Nuevo coste \(J_{\text{nuevo}}\):
- Aproximación numérica de la derivada:
El valor analítico teórico calculado mediante backpropagation fue exactamente \(-286\).
La coincidencia (\(-285.758 \approx -286\)) confirma rigurosamente la exactitud de nuestras fórmulas de retropropagación.
2 Caso 2: Un canal de entrada y dos filtros (\(1 \to 2\))
En este segundo caso, procesamos la misma imagen de entrada \(X\) (\(5 \times 5\)) pero aplicamos dos filtros distintos en paralelo (\(W_1\) y \(W_2\)), generando dos mapas de activaciones (\(Z_1\) y \(Z_2\)).
2.0.1 Planteamiento
- Entrada (\(X\)): La misma matriz \(5 \times 5\) del Caso 1.
- Filtro 1 (\(W_1\)) y Sesgo 1 (\(b_1 = 1.0\)):
- Filtro 2 (\(W_2\)) y Sesgo 2 (\(b_2 = 0.0\)):
- Capa densa (MLP):
- Aplanamos \(Z_1\) y \(Z_2\) concatenándolos en un vector de \(9 + 9 = \mathbf{18 \text{ elementos}}\):
- Vector de pesos densos \(w_{\text{FC}} \in \mathbb{R}^{18}\):
- Valor esperado: \(y = 6.0\).
2.0.2 Propagación hacia adelante (Forward Pass)
Cada filtro genera su propio mapa de \(3 \times 3\) de forma independiente:
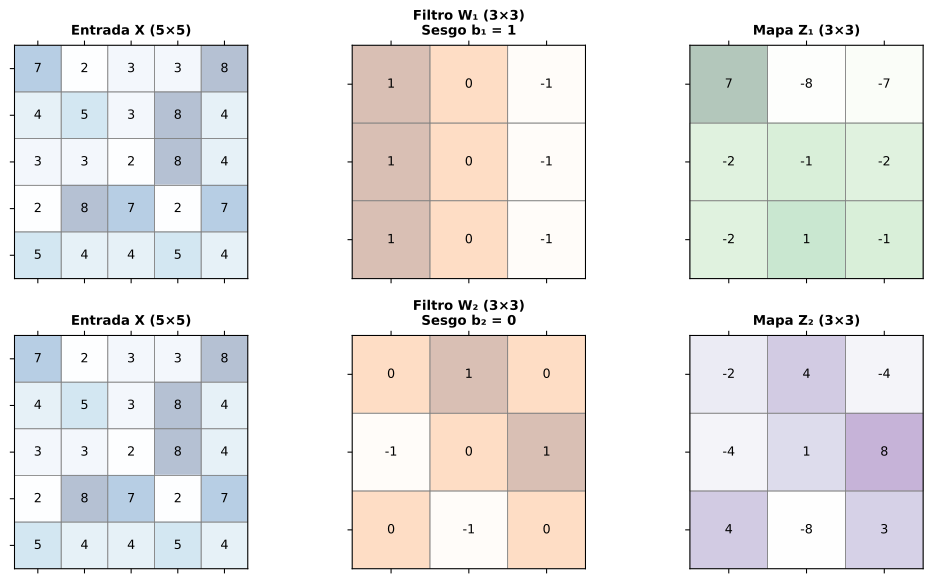
Figura 4: Caso 2 (1 canal, 2 filtros): la entrada 5×5 es procesada en paralelo por W₁ (arriba) y W₂ (abajo), generando los mapas de activaciones Z₁ y Z₂.
Las dos matrices calculadas son:
Multiplicamos el vector concatenado de 18 activaciones por \(w_{\text{FC}}\):
Predicción: \(\hat{y} = z_{\text{salida}} = \mathbf{17.0}\).
Coste del error:
2.0.3 Propagación hacia atrás (Backward Pass)
- Delta de la neurona de salida:
- Retropropagación y bifurcación a los dos mapas (\(\delta_{Z_1}\) y \(\delta_{Z_2}\)): El vector de 18 deltas es \(\delta_z = 11 \cdot w_{\text{FC}}\). Al reconstruir las matrices espaciales \(3 \times 3\):
-
Gradientes de los sesgos (\(b_1\) y \(b_2\)):
-
\(\frac{\partial J}{\partial b_1} = \sum \delta_{Z_1} = 6 \times 11 = \mathbf{66.0}\)
-
\(\frac{\partial J}{\partial b_2} = \sum \delta_{Z_2} = 11 - 11 + 11 - 11 = \mathbf{0.0}\)
-
Gradientes de los pesos (\(W_1\) y \(W_2\)): Aplicando la convolución de la entrada \(X\) con su respectiva matriz de error:
3 Caso 3: Dos canales de entrada y un filtro 3D (\(2 \to 1\))
Examinemos ahora una entrada con múltiples canales (\(C_{\text{in}} = 2\)), como ocurriría con dos planos de color o dos mapas de características intermedios.
3.0.1 Planteamiento
- Entrada multicanal (\(X \in \mathbb{R}^{4 \times 4 \times 2}\)):
- Canal 1 (\(X_{\text{c1}}\)):
- Canal 2 (\(X_{\text{c2}}\)):
- Filtro 3D (\(W \in \mathbb{R}^{2 \times 2 \times 2}\)) y Sesgo escalar (\(b = 1.0\)):
- Rebanada Canal 1 (\(W_{\text{c1}}\)):
- Rebanada Canal 2 (\(W_{\text{c2}}\)):
- Capa densa (MLP):
- Los \(3 \times 3 = 9\) valores del mapa resultante se conectan con \(w_{\text{FC}} = [1, 0, 1, 1, 0, 1, 1, 0, 1]^T\).
- Valor objetivo real: \(y = 6.0\).
3.0.2 Propagación hacia adelante (Forward Pass)
La convolución 3D calcula la suma de convoluciones de cada canal más el sesgo único \(b\):
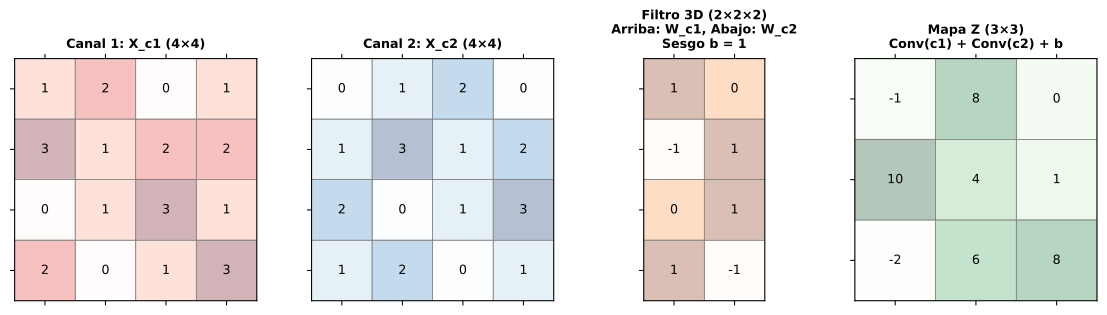
Figura 5: Caso 3 (2 canales, 1 filtro 3D): los canales de entrada X_c1 y X_c2 se convolucionan con sus correspondientes rebanadas de filtro W_c1 y W_c2 y se suman con el sesgo b=1 para formar el mapa Z.
El mapa de características \(Z\) resultante es:
Aplanado y proyección densa:
Predicción: \(\hat{y} = \mathbf{16.0}\).
Coste del error:
3.0.3 Propagación hacia atrás (Backward Pass)
- Delta de salida:
- Matriz de errores del mapa (\(\delta_Z\)):
- Gradiente del sesgo (\(b\)): Como el sesgo es único para el filtro 3D completo:
- Gradiente de los pesos por canal (\(\frac{\partial J}{\partial W_{\text{c1}}}\) y \(\frac{\partial J}{\partial W_{\text{c2}}}\)): Cada rebanada del kernel recibe su gradiente convolucionando su canal de entrada con el mapa común \(\delta_Z\):
4 Resumen comparativo de los tres casos
| Configuración | Entrada | Filtros | Activaciones (\(Z\)) | Gradiente del Sesgo | Gradiente de los Pesos |
|---|---|---|---|---|---|
| Caso 1 (\(1 \to 1\)) | \(5 \times 5 \times 1\) | 1 de \(3 \times 3 \times 1\) | 1 mapa (\(3 \times 3\)) | \(\frac{\partial J}{\partial b} = \sum \delta_Z = -78\) | \(\frac{\partial J}{\partial W} = X * \delta_Z\) (\(3 \times 3\)) |
| Caso 2 (\(1 \to 2\)) | \(5 \times 5 \times 1\) | 2 de \(3 \times 3 \times 1\) | 2 mapas (\(3 \times 3 \times 2\)) | \(\frac{\partial J}{\partial b_1} = 66, \; \frac{\partial J}{\partial b_2} = 0\) | \(\frac{\partial J}{\partial W_1} = X * \delta_{Z_1}, \; \frac{\partial J}{\partial W_2} = X * \delta_{Z_2}\) |
| Caso 3 (\(2 \to 1\)) | \(4 \times 4 \times 2\) | 1 de \(2 \times 2 \times 2\) | 1 mapa (\(3 \times 3 \times 1\)) | \(\frac{\partial J}{\partial b} = \sum \delta_Z = 60\) | \(\frac{\partial J}{\partial W_{\text{c}k}} = X_{\text{c}k} * \delta_Z\) (\(2 \times 2 \times 2\)) |