Detección de Objetos: Localización, Ventanas Convolucionales y YOLO
Navegación en esta sección
Capítulos anteriores del bloque de Visión Artificial: 1. Redes neuronales convolucionales (CNN) — convolución, padding, pooling y LeNet-5. 2. Matemáticas de la capa convolucional — cálculo manual y backpropagation. 3. Arquitecturas clásicas y modernas de CNN — AlexNet, VGG, ResNet, Inception y MobileNet. 4. Práctica en Visión Artificial — Transfer Learning y Data Augmentation.
Estás en Detección de Objetos (localización espacial, regresión de coordenadas, ventanas convolucionales y el algoritmo YOLO).
1 De la Clasificación a la Detección de Objetos
En los capítulos anteriores abordamos el problema de la clasificación de imágenes: determinar la categoría global de una imagen completa («esta fotografía contiene un automóvil»). Sin embargo, en aplicaciones críticas como los vehículos autónomos, la robótica o los sistemas de vigilancia, no basta con saber qué objetos hay; es imprescindible saber dónde están y cuántos hay.
Distinguimos tres niveles de complejidad progresiva:
- Clasificación de Imágenes: Asigna una etiqueta de clase a toda la imagen. Se asume un único objeto dominante.
- Clasificación con Localización: Identifica la clase del objeto y genera un cuadro delimitador (bounding box) que encuadra su posición espacial precisa. Se asume un único objeto principal en la escena.
- Detección de Objetos (Object Detection): Localiza y clasifica múltiples objetos de diversas categorías simultáneamente en una misma escena, generando un cuadro delimitador para cada uno de ellos.
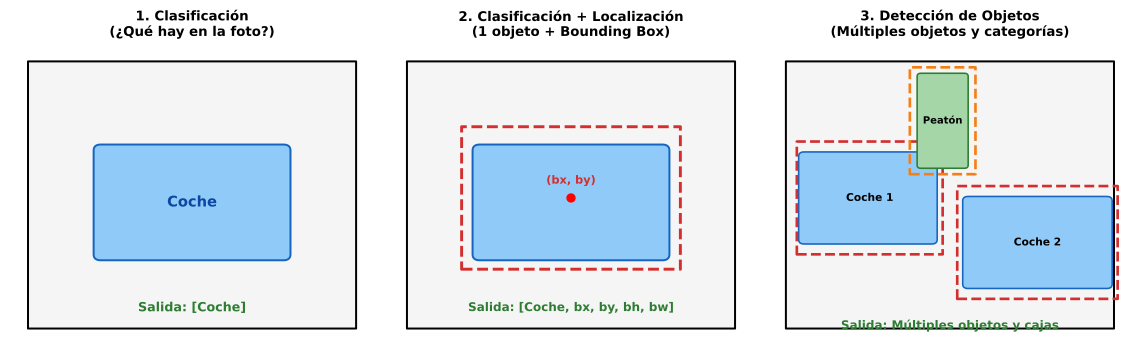
Figura 1: Los tres niveles de visión espacial: Clasificación (izquierda), Clasificación con Localización de un objeto (centro) y Detección de múltiples objetos con cuadros delimitadores (derecha).
2 Clasificación con Localización: El vector objetivo \(y\)
Para que una red convolucional aprenda simultáneamente a clasificar un objeto y a predecir su posición, modificamos la capa de salida para formular un problema híbrido de clasificación y regresión continua.
Definimos el vector de salida \(y\) con las siguientes componentes:
donde:
- \(p_c \in \{0, 1\}\) (Probabilidad de presencia): Vale \(1\) si la imagen contiene un objeto de interés (peatón, coche, motocicleta), y \(0\) si corresponde a fondo (background).
- \(b_x, b_y \in [0, 1]\) (Centro del cuadro): Coordenadas del punto medio del cuadro delimitador, normalizadas respecto al ancho y alto de la imagen (con \((0,0)\) en la esquina superior izquierda y \((1,1)\) en la inferior derecha).
- \(b_h, b_w \in [0, 1]\) (Dimensiones del cuadro): Altura (\(b_h\)) y anchura (\(b_w\)) del cuadro delimitador como fracción del tamaño total de la imagen.
- \(c_1, c_2, c_3 \in \{0, 1\}\) (Clases One-Hot): Vector de clasificación que identifica la categoría detectada (por ejemplo, \(c_1=\text{Peatón}\), \(c_2=\text{Coche}\), \(c_3=\text{Motocicleta}\)).
2.1 Ejemplo ilustrativo: dos imágenes etiquetadas
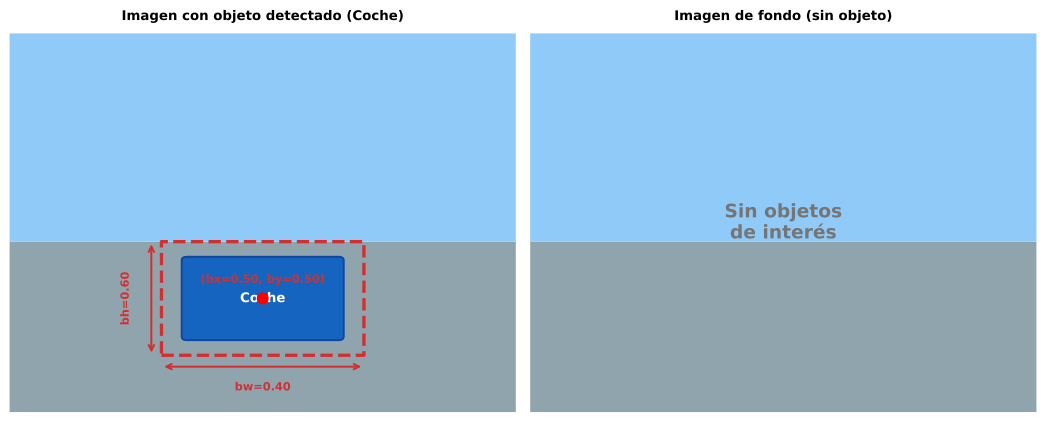
Figura 2: Dos ejemplos de etiquetado para clasificación con localización: (izquierda) una imagen con un coche detectado y su cuadro delimitador; (derecha) una imagen de fondo sin ningún objeto de interés.
2.1.1 Imagen 1: Un coche en la carretera
Supongamos una imagen de \(100 \times 100\) píxeles donde un coche ocupa una región cuyo centro está en el píxel \((50, 50)\), mide \(60\) píxeles de alto y \(40\) de ancho. Normalizando por el tamaño de la imagen:
Como es un coche, la clase one-hot es \(c_1 = 0\) (Peatón), \(c_2 = 1\) (Coche), \(c_3 = 0\) (Moto). El vector etiqueta completo es:
2.1.2 Imagen 2: Fondo sin objetos
Si la imagen solo muestra carretera vacía (sin peatones, coches ni motos), el vector etiqueta es:
Los signos de interrogación indican que esos valores son irrelevantes: solo importa que \(p_c = 0\).
2.2 La función de pérdida condicional
El vector de predicción de la red \(\hat{y}\) contiene 8 números continuos. Sin embargo, ¿cómo calculamos el error cuando en la imagen no hay ningún objeto (\(p_c = 0\))?
Si no hay ningún objeto en la escena, los valores de las coordenadas \((b_x, b_y, b_h, b_w)\) y las clases \((c_1, c_2, c_3)\) son irrelevantes. Por tanto, la función de pérdida \(\mathcal{L}(\hat{y}, y)\) debe ser condicional:
Comportamiento del gradiente cuando pc = 0
Cuando la imagen corresponde a fondo (\(p_c = 0\)), el error de las coordenadas y de las clases se fija deliberadamente en cero. En el paso de retropropagación (backpropagation), los gradientes de esas neuronas son exactamente \(0\). La red solo ajusta sus pesos para aprender a predecir \(\hat{p}_c \to 0\), sin penalizar las salidas de regresión que carecen de significado.
3 Regresión de Puntos Clave (Landmarks)
La técnica de predecir coordenadas continuas no se restringe a cajas rectangulares. Una red convolucional puede configurarse para predecir las posiciones \((x, y)\) de puntos de referencia anatómicos o estructurales (landmarks).
3.1 Casos de uso fundamentales
- Detección facial y filtros de Realidad Aumentada:
- Una red recibe una fotografía del rostro y predice las coordenadas de \(68\) puntos clave (comisuras de los ojos, contorno de la nariz, arco de las cejas, borde de los labios y mandíbula).
- El vector de salida contiene \(1 + (68 \times 2) = \mathbf{137 \text{ neuronas}}\) (\(p_c\) de presencia facial más los 68 pares \((l_{1x}, l_{1y}), \dots, (l_{68x}, l_{68y})\)).
- Permite aplicar efectos en tiempo real (filtros AR) o medir expresiones para reconocimiento de emociones.
- Estimación de Pose Humana (Pose Estimation):
- Predicción de los puntos de articulación corporal: hombros, codos, muñecas, caderas, rodillas y tobillos.
- Utilizado en análisis biomecánico deportivo, animación de avatares 3D y control por gestos.
Requisito de coherencia en el etiquetado
Para que la regresión de puntos clave converja, la asignación de índices debe ser estrictamente consistente en todo el conjunto de datos: el punto 1 debe corresponder siempre a la misma esquina interior del ojo izquierdo en todas las imágenes de entrenamiento.
4 Ventanas Deslizantes y su Convolucionalización (OverFeat)
El enfoque clásico para detectar objetos en una imagen grande consistía en el algoritmo de ventanas deslizantes (Sliding Windows). Veamos cómo funciona paso a paso con un ejemplo concreto.
4.1 Paso 1: Entrenamiento de la CNN
Primero entrenamos una CNN convencional para clasificar parches de tamaño fijo. Por ejemplo, entrenamos con imágenes de \(64 \times 64\) píxeles clasificadas en dos categorías: “Coche” o “Fondo”. La CNN aprende a mirar una imagen de \(64 \times 64\) y decir si contiene un coche o no.
4.2 Paso 2: Detección en una imagen grande
Ahora tenemos una imagen de prueba de \(200 \times 200\) píxeles con un coche pequeño (de unos \(50 \times 50\) píxeles) en la esquina inferior derecha. ¿Cómo lo detectamos?
Recortamos ventanas y las clasificamos una a una:
- Colocamos una ventana de \(64 \times 64\) en la esquina superior izquierda de la imagen.
- Pasamos ese parche por la CNN → “Fondo”.
- Desplazamos la ventana unos píxeles a la derecha (stride) y repetimos.
- Seguimos deslizando la ventana fila por fila hasta recorrer toda la imagen.
En algún momento, la ventana caerá sobre el coche y la CNN dirá “Coche”. ¡Objeto detectado!
4.3 Paso 3: El problema de los distintos tamaños
¿Qué ocurre si el coche es más grande, de \(120 \times 120\) píxeles? La ventana de \(64 \times 64\) solo verá una porción parcial del coche (un trozo de rueda, un trozo de ventana), y la CNN probablemente dirá “Fondo” porque no ve el coche completo.
Solución: Escanear la imagen con ventanas de distintos tamaños:
- Primer barrido: ventana de \(64 \times 64\) (detecta coches pequeños).
- Segundo barrido: ventana de \(96 \times 96\) (detecta coches medianos).
- Tercer barrido: ventana de \(128 \times 128\) (detecta coches grandes).
4.4 ¿Por qué redimensionar? El problema del tamaño fijo de la CNN
Aquí surge la pregunta clave: la CNN fue entrenada con imágenes de \(64 \times 64\), ¿cómo le pasamos una ventana de \(96 \times 96\) o \(128 \times 128\)?
La solución es redimensionar (resize) cada parche recortado al tamaño que espera la CNN:
- Recortamos una ventana de \(96 \times 96\) de la imagen.
- La redimensionamos a \(64 \times 64\) usando interpolación (el algoritmo calcula los nuevos valores de píxeles promediando los vecinos).
- Pasamos la imagen redimensionada por la CNN.
De esta forma, la CNN siempre recibe entradas de \(64 \times 64\), sin importar el tamaño original de la ventana.
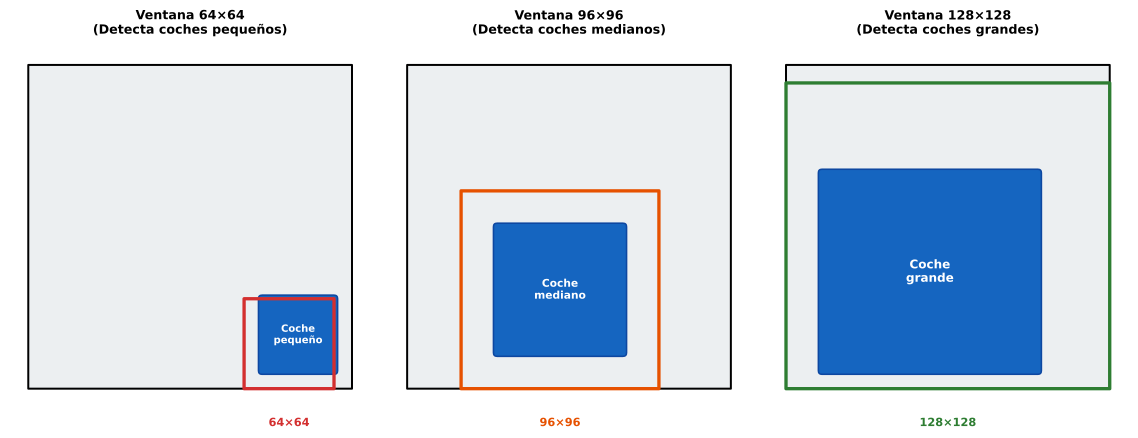
Figura 3: Algoritmo de ventanas deslizantes: se escanea la imagen con ventanas de distintos tamaños (64×64, 96×96, 128×128). Cada parche se redimensiona a 64×64 antes de pasarlo por la CNN entrenada.
¿Cómo funciona el redimensionamiento?
Cuando recortamos una ventana de \(96 \times 96\) y la redimensionamos a \(64 \times 64\), el algoritmo de interpolación (bilineal o bicúbica) calcula los nuevos valores de píxeles promediando los píxeles vecinos. La imagen se “encoge” pero conserva la forma general del objeto. La CNN, que fue entrenada con imágenes de \(64 \times 64\), puede reconocer el coche en la versión redimensionada.
4.5 El problema de coste computacional
El algoritmo de ventanas deslizantes funciona, pero tiene un grave problema de eficiencia:
- Para una imagen de \(200 \times 200\) con un stride de 8 píxeles y 3 tamaños de ventana, necesitamos ejecutar la CNN miles de veces (aproximadamente \(\frac{200}{8} \times \frac{200}{8} \times 3 \approx 1.875\) veces).
- Cada ejecución de la CNN implica millones de operaciones de convolución.
- La mayoría de esas ventanas son “Fondo” puro, lo que significa que estamos desperdiciando cómputo clasificando regiones vacías.
El problema insalvable: Ejecutar una CNN miles de veces de forma independiente sobre parches superpuestos es extremadamente lento e inviable para aplicaciones en tiempo real.
4.6 El truco de la convolucionalización (Sermanet et al., 2013)
La solución introducida por el modelo OverFeat consiste en convertir todas las capas totalmente conectadas (FC) en capas convolucionales equivalentes.
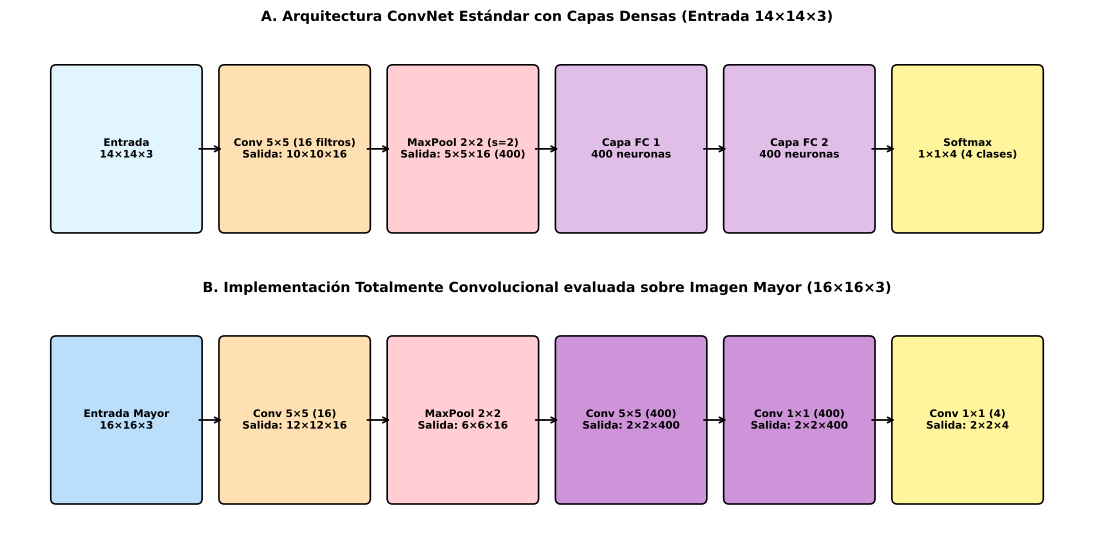
Figura 4: Convolucionalización de capas densas (OverFeat): A (arriba), arquitectura estándar con capas FC para entrada 14×14. B (abajo), sustitución de capas FC por filtros 5×5 y 1×1, permitiendo evaluar una imagen mayor de 16×16 y obtener las 4 predicciones espaciales en un único pase.
Supongamos una red que procesa una entrada base de \(14 \times 14 \times 3\):
- Tras las convoluciones y un Max Pooling \(2 \times 2\), produce un volumen de \(5 \times 5 \times 16 = 400\) valores.
- Tradicionalmente, una capa FC conectaría esos 400 valores a 400 neuronas densas.
- Equivalencia matemática convolucional: En su lugar, aplicamos 400 filtros convolucionales de tamaño \(5 \times 5 \times 16\). Al tener el filtro el mismo tamaño espacial que el volumen de entrada (\(5 \times 5\)), cada filtro no se desplaza y produce una única celda de \(1 \times 1\), generando un volumen de \(1 \times 1 \times 400\).
- La siguiente capa densa se sustituye por 400 filtros de \(1 \times 1\), y la capa Softmax final por 4 filtros de \(1 \times 1\) (generando una salida \(1 \times 1 \times 4\) para las 4 clases).
4.6.1 Evaluación de imágenes grandes en un único pase hacia adelante
Al tener una red compuesta exclusivamente por operaciones convolucionales y de pooling, la red puede recibir imágenes de cualquier tamaño sin necesidad de reescalado:
- Si introducimos una imagen mayor de \(16 \times 16 \times 3\), la salida final será automáticamente un volumen de \(2 \times 2 \times 4\). Cada una de las 4 celdas espaciales de \(1 \times 1 \times 4\) contiene exactamente la clasificación correspondiente a una de las 4 ventanas deslizantes de \(14 \times 14\).
- Si introducimos una imagen de \(28 \times 28 \times 3\), la red produce de inmediato una matriz de salida de \(8 \times 8 \times 4\) (las predicciones de 64 ventanas deslizantes).
Ventaja decisiva: Toda la computación de las regiones superpuestas se comparte de forma natural dentro de las operaciones de convolución, evaluando la imagen completa en un único pase hacia adelante (single forward pass).
5 El Algoritmo YOLO (You Only Look Once)
Hemos visto dos enfoques para detectar objetos:
- Ventanas deslizantes: Lento (miles de ejecuciones de la CNN por imagen).
- Ventanas convolucionales: Más rápido, pero las cajas están restringidas a posiciones y tamaños fijos.
YOLO (Joseph Redmon et al., 2016) propone una idea radicalmente diferente: ¿y si ejecutamos la imagen por la CNN una sola vez y obtenemos todas las detecciones de golpe?
5.1 La idea central: una sola pasada
En lugar de preguntar “¿hay un coche en esta ventana?”, YOLO hace lo siguiente:
- Divide la imagen en una cuadrícula de \(S \times S\) celdas (por ejemplo, \(3 \times 3\) para simplificar, o \(19 \times 19\) en la práctica).
- Para cada celda, la red predice directamente: ¿hay algún objeto cuyo centro cae en mí? Si es así, ¿qué clase es y dónde está su cuadro delimitador?
- Todo esto se calcula en un único pase hacia adelante de la CNN.
5.2 Ejemplo concreto paso a paso
Supongamos una imagen de \(300 \times 300\) píxeles con dos coches:
- Coche 1: centro en el píxel \((100, 150)\), mide \(120 \times 80\) píxeles.
- Coche 2: centro en el píxel \((220, 160)\), mide \(100 \times 70\) píxeles.
Dividimos la imagen en una cuadrícula de \(3 \times 3\). Cada celda mide \(100 \times 100\) píxeles.
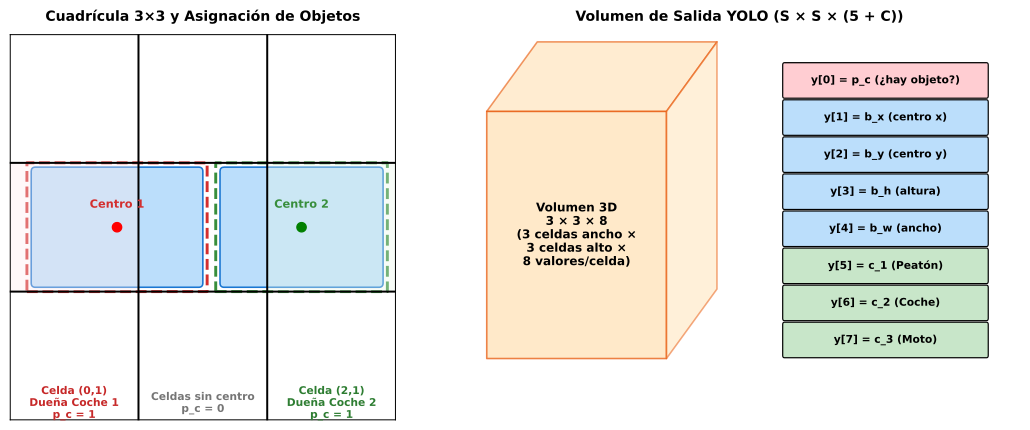
Figura 5: Filosofía YOLO: la imagen se divide en una cuadrícula S×S (izquierda). El objeto se asigna exclusivamente a la celda que contiene su punto central (bx, by), generando un volumen 3D de salida S×S×(5+C) en un único pase hacia adelante (derecha).
5.2.1 Paso 1: Asignar cada objeto a su celda
La regla es simple: cada objeto se asigna a la celda que contiene su punto central.
- Coche 1: centro en \((150, 150)\). Como la cuadrícula es de \(3 \times 3\) sobre una imagen de \(300 \times 300\), cada celda mide \(100 \times 100\). El centro \((150, 150)\) cae claramente dentro de la celda columna 1, fila 1 → celda \((1, 1)\).
- Coche 2: centro en \((270, 160)\). El centro \((270, 160)\) cae dentro de la celda columna 2, fila 1 → celda \((2, 1)\).
- Las otras 7 celdas no contienen ningún centro de objeto → son “fondo”.
5.2.2 Paso 2: ¿Qué predice la red para cada celda?
La CNN procesa la imagen completa y produce un volumen de salida de \(3 \times 3 \times 8\) (para 3 clases: Peatón, Coche, Moto). Cada celda de la cuadrícula tiene asociado un vector de 8 números:
Para nuestro ejemplo con 2 coches:
| Celda | \(p_c\) | \(b_x\) | \(b_y\) | \(b_h\) | \(b_w\) | \(c_1\) (Peatón) | \(c_2\) (Coche) | \(c_3\) (Moto) |
|---|---|---|---|---|---|---|---|---|
| \((0,0)\) | \(0\) | \(?\) | \(?\) | \(?\) | \(?\) | \(?\) | \(?\) | \(?\) |
| \((0,1)\) | \(0\) | \(?\) | \(?\) | \(?\) | \(?\) | \(?\) | \(?\) | \(?\) |
| \((0,2)\) | \(0\) | \(?\) | \(?\) | \(?\) | \(?\) | \(?\) | \(?\) | \(?\) |
| \((1,0)\) | \(0\) | \(?\) | \(?\) | \(?\) | \(?\) | \(?\) | \(?\) | \(?\) |
| \((1,1)\) | \(\mathbf{1}\) | \(\mathbf{0.50}\) | \(\mathbf{0.50}\) | \(\mathbf{0.40}\) | \(\mathbf{0.27}\) | \(\mathbf{0}\) | \(\mathbf{1}\) | \(\mathbf{0}\) |
| \((1,2)\) | \(0\) | \(?\) | \(?\) | \(?\) | \(?\) | \(?\) | \(?\) | \(?\) |
| \((2,0)\) | \(0\) | \(?\) | \(?\) | \(?\) | \(?\) | \(?\) | \(?\) | \(?\) |
| \((2,1)\) | \(\mathbf{1}\) | \(\mathbf{0.70}\) | \(\mathbf{0.60}\) | \(\mathbf{0.70}\) | \(\mathbf{0.33}\) | \(\mathbf{0}\) | \(\mathbf{1}\) | \(\mathbf{0}\) |
| \((2,2)\) | \(0\) | \(?\) | \(?\) | \(?\) | \(?\) | \(?\) | \(?\) | \(?\) |
Los valores \(?\) son irrelevantes cuando \(p_c = 0\) (la función de pérdida los ignora).
5.2.3 Paso 3: Interpretación de las coordenadas
Las coordenadas \(b_x, b_y\) se expresan relativas a la celda, no a la imagen completa:
- Celda \((1,1)\): El centro del coche 1 está en el píxel \((150, 150)\). Dentro de su celda (que va del píxel 100 al 200 en X y del 100 al 200 en Y), el centro relativo es:
- \(b_x = \frac{150 - 100}{100} = 0.50\) (centro de la celda en X)
- \(b_y = \frac{150 - 100}{100} = 0.50\) (centro de la celda en Y)
- Dimensiones \(b_h, b_w\): Se expresan como fracción del tamaño total de la imagen:
- \(b_h = \frac{120}{300} = 0.40\) (altura del coche 1 respecto a la imagen)
- \(b_w = \frac{80}{300} \approx 0.27\) (anchura del coche 1 respecto a la imagen)
5.2.4 Paso 4: Arquitectura de la red
La red CNN toma la imagen de entrada y, tras varias capas convolucionales y de pooling, produce un volumen de salida de exactamente \(S \times S \times (5 + C)\). Para nuestro ejemplo:
- Entrada: \(300 \times 300 \times 3\)
- Salida: \(3 \times 3 \times 8\) (9 celdas, cada una con 8 valores)
La clave es que la última capa convolucional tiene exactamente \((5 + C)\) filtros para que la salida tenga el número correcto de canales.
¿Por qué YOLO es tan rápido?
En las ventanas deslizantes, ejecutamos la CNN \(\approx 1.875\) veces por imagen. En YOLO, ejecutamos la CNN una sola vez. Toda la información de “¿qué hay en cada celda?” se extrae en un único pase hacia adelante. Esto permite procesar vídeo en tiempo real (\(> 45\) FPS).
5.3 Parametrización de las coordenadas
Para garantizar la estabilidad numérica: - Centro (\(b_x, b_y\)): Se expresa relativo a la esquina superior izquierda de su propia celda (\(0 \le b_x, b_y \le 1\)). En implementaciones como YOLOv2/v3, se aplica una función sigmoide (\(\sigma(t_x), \sigma(t_y)\)) para restringir el centro estrictamente dentro de la celda. - Dimensiones (\(b_h, b_w\)): Se expresan como fracciones relativas al tamaño total de la imagen (pudiendo ser mayores que 1 si el objeto es más grande que una celda).
6 Métrica de evaluación: Intersección sobre Unión (IoU)
Para cuantificar objetivamente la precisión de un cuadro delimitador predicho respecto a la verdad fundamental (Ground Truth), utilizamos la métrica Intersección sobre Unión (IoU):
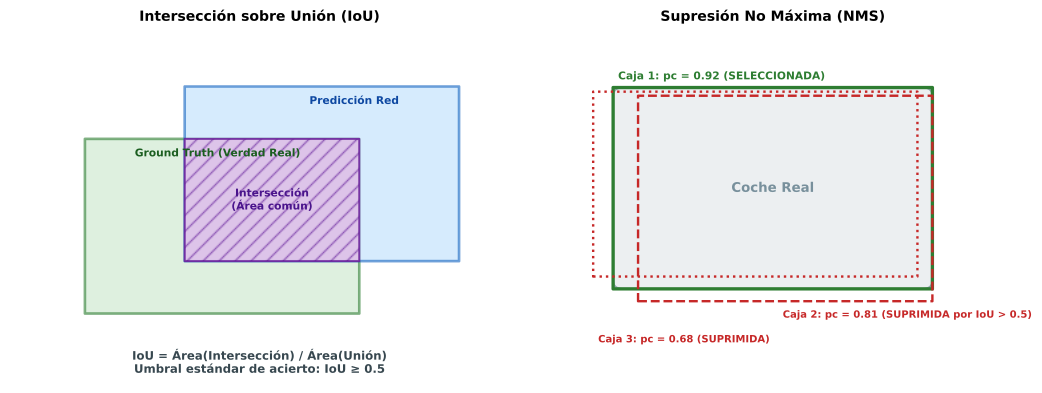
Figura 6: Métrica IoU (izquierda, cociente entre área común y área total cubierta) y Supresión No Máxima (derecha, conservación de la caja de máxima confianza y eliminación de duplicados solapados).
- \(\text{IoU} = 1.0\): Coincidencia geométrica perfecta.
- \(\text{IoU} = 0.0\): Cajas completamente disjuntas.
- Convención estándar: Se considera que una detección es un verdadero positivo (True Positive) si \(\text{IoU} \ge 0.5\) (en benchmarks estrictos como COCO se evalúa el promedio de IoU entre \(0.5\) y \(0.95\)).
7 Supresión No Máxima (Non-Max Suppression / NMS)
En la práctica, aunque un objeto tenga su centro en una celda específica, las celdas contiguas también detectan partes del objeto y activan valores altos de \(p_c\). El resultado en crudo son múltiples cajas delimitadoras superpuestas para un mismo objeto.
El algoritmo NMS limpia estas detecciones redundantes en 3 pasos:
- Filtrado inicial por confianza: Se descartan todas las cajas cuya probabilidad sea inferior a un umbral mínimo (por ejemplo, \(p_c < 0.6\)).
- Bucle voraz (Greedy Selection):
- Se selecciona la caja no procesada con la probabilidad \(p_c\) más alta. Se declara como detección final definitiva.
- Se calculan las IoU de esa caja con todas las demás cajas restantes.
- Se suprimen (eliminan) todas las cajas que tengan una \(\text{IoU} > 0.5\) con la caja seleccionada (al considerarse detecciones duplicadas del mismo objeto).
- Repetición multiclase: Se repite el proceso de forma independiente para cada una de las clases de objetos detectables.
8 Cuadros de Anclaje (Anchor Boxes)
¿Qué ocurre si dos objetos distintos tienen sus centros en la misma celda de la cuadrícula (por ejemplo, un peatón situado justo delante de un automóvil)?
Con la formulación básica, cada celda solo puede emitir un único vector \(y\), obligando a la red a descartar uno de los dos objetos.
Los cuadros de anclaje (Anchor Boxes) definen \(B\) plantillas o siluetas predeterminadas con diferentes relaciones de aspecto (por ejemplo, Anclaje 1 alto y estrecho para peatones, y Anclaje 2 ancho y bajo para coches).
8.1 Modificación del vector objetivo
El vector \(y\) de cada celda se expande concatenando las predicciones de cada cuadro de anclaje:
- Regla de asignación: El objeto se asigna a la celda de su centro y al cuadro de anclaje que tenga mayor IoU con su forma real.
- Selección de anclajes: En las versiones modernas de YOLO (v2 a v8), las dimensiones de los anclajes no se eligen a mano, sino aplicando clustering K-means sobre todas las cajas delimitadoras del conjunto de entrenamiento (Dimension Clusters).
9 Comparativa de paradigmas: Detectores en Dos Etapas vs Una Etapa
| Característica | Detectores en Dos Etapas (Two-Stage) | Detectores en Una Etapa (Single-Stage) |
|---|---|---|
| Modelos representativos | R-CNN, Fast R-CNN, Faster R-CNN | YOLO (v1 a v8), SSD, RetinaNet |
| Flujo de trabajo | 1. Genera regiones candidatas (RPN) 2. Clasifica y ajusta cada región |
Predice cuadrícula, cajas y clases en un único pase |
| Velocidad (FPS) | Lenta ($5 - 15$ FPS) | Ultra-rápida ($45 - 160$ FPS, tiempo real) |
| Precisión en objetos pequeños | Ligeramente superior | Muy alta en versiones modernas |
| Caso de uso óptimo | Diagnóstico médico, satélites, conteo estático | Coches autónomos, robótica, drones, vídeo en directo |
10 Código interactivo en Python: Cálculo de IoU y Algoritmo NMS
El siguiente script en Python implementa la función geométrica de IoU y el algoritmo completo de Supresión No Máxima:
import numpy as np

def compute_iou(boxA, boxB):
    """
    Calcula la Intersección sobre Unión (IoU) entre dos cajas delimitadoras.
    Formato de caja: [x1, y1, x2, y2]
    """
    # Coordenadas de la intersección
    xA = max(boxA[0], boxB[0])
    yA = max(boxA[1], boxB[1])
    xB = min(boxA[2], boxB[2])
    yB = min(boxA[3], boxB[3])

    # Área de intersección
    inter_w = max(0.0, xB - xA)
    inter_h = max(0.0, yB - yA)
    inter_area = inter_w * inter_h

    # Áreas individuales
    boxA_area = (boxA[2] - boxA[0]) * (boxA[3] - boxA[1])
    boxB_area = (boxB[2] - boxB[0]) * (boxB[3] - boxB[1])

    # Unión
    union_area = boxA_area + boxB_area - inter_area

    if union_area == 0:
        return 0.0
    return inter_area / union_area

def non_max_suppression(boxes, scores, iou_threshold=0.5, score_threshold=0.6):
    """
    Algoritmo de Supresión No Máxima (NMS).
    boxes: array Nx4 [x1, y1, x2, y2]
    scores: array N de probabilidades pc
    """
    # 1. Filtrar por umbral de confianza
    valid_mask = scores >= score_threshold
    boxes = boxes[valid_mask]
    scores = scores[valid_mask]

    if len(boxes) == 0:
        return []

    # 2. Ordenar de mayor a menor confianza
    order = np.argsort(scores)[::-1]
    selected_indices = []

    while len(order) > 0:
        best_idx = order[0]
        selected_indices.append(best_idx)

        # Calcular IoU del mejor con el resto
        remaining = order[1:]
        ious = np.array([compute_iou(boxes[best_idx], boxes[i]) for i in remaining])

        # Conservar solo los que tengan IoU <= iou_threshold
        keep = np.where(ious <= iou_threshold)[0]
        order = remaining[keep]

    return boxes[selected_indices], scores[selected_indices]

# Demostración con 3 cajas predichas sobre el mismo coche
boxes = np.array([
    [50, 50, 200, 150],  # Caja 1: Detección central fuerte
    [55, 48, 205, 152],  # Caja 2: Duplicado muy solapado
    [40, 60, 190, 145]   # Caja 3: Duplicado solapado
], dtype=float)
scores = np.array([0.92, 0.81, 0.68])

print("=" * 60)
print("1. EVALUACIÓN DE IoU ENTRE CAJAS")
print("=" * 60)
print(f"IoU(Caja 1, Caja 2): {compute_iou(boxes[0], boxes[1]):.4f}")
print(f"IoU(Caja 1, Caja 3): {compute_iou(boxes[0], boxes[2]):.4f}\n")

final_boxes, final_scores = non_max_suppression(boxes, scores, iou_threshold=0.5)

print("=" * 60)
print("2. RESULTADO TRAS SUPRESIÓN NO MÁXIMA (NMS)")
print("=" * 60)
print(f"Cajas iniciales: {len(boxes)} | Cajas conservadas tras NMS: {len(final_boxes)}")
print(f"Caja seleccionada: {final_boxes[0]} con confianza pc = {final_scores[0]:.2f}")
============================================================
1. EVALUACIÓN DE IoU ENTRE CAJAS
============================================================
IoU(Caja 1, Caja 2): 0.9006
IoU(Caja 1, Caja 3): 0.7508

============================================================
2. RESULTADO TRAS SUPRESIÓN NO MÁXIMA (NMS)
============================================================
Cajas iniciales: 3 | Cajas conservadas tras NMS: 1
Caja seleccionada: [ 50.  50. 200. 150.] con confianza pc = 0.92
Siguiente paso: Delimitación píxel a píxel
Aprende cómo ir más allá de los cuadros rectangulares y recortar siluetas exactas a nivel de píxel en Segmentación Semántica, Convolución Transpuesta y Arquitectura U-Net.