Máquinas de Vectores de Soporte (SVM)
1 Introducción
A diferencia de otros métodos como la regresión lineal o la regresión logística, SVM es capaz de resolver tanto tareas de clasificación como de regresión. Su popularidad radica en su capacidad para manejar conjuntos de datos pequeños y complejos, una característica poco común en otras técnicas de aprendizaje automático (la mayoría de algoritmos funcionan bien cuando disponemos de muchos datos).
SVM se basa en el aprendizaje supervisado, por lo que requiere un conjunto de datos etiquetado para entrenar el modelo. Esta técnica puede generar modelos tanto lineales como no lineales, lo que la hace adaptable a una gran variedad de conjuntos de datos.
En función de si los datos son linealmente separables o no, SVM utiliza estrategias distintas:
- Para conjuntos de datos linealmente separables, SVM busca maximizar el margen entre las clases. En este caso distinguimos dos enfoques:
- Hard Margin Classification (margen rígido).
- Soft Margin Classification (margen flexible).
- Cuando los datos no son linealmente separables, SVM utiliza un enfoque de kernels para mapear los datos a un espacio de mayor dimensionalidad donde la separación lineal es posible.
La característica que define a SVM es que construye un límite de decisión que maximiza el margen entre las clases, lo que promueve una generalización sólida para datos nuevos y la distingue de algoritmos como la regresión logística.
2 Clasificación de márgenes amplios (Large Margin Classification)
Cuando un conjunto de datos puede separarse con una línea recta (o, en general, con un hiperplano), decimos que es linealmente separable. Es decir, existe una función lineal que permite separar los datos en categorías.
Sin embargo, puede haber varios modelos lineales que separen correctamente las clases. El problema aparece cuando el límite de decisión se acerca demasiado a los datos: un modelo así clasificará bien los ejemplos conocidos pero tendrá un rendimiento pobre ante ejemplos aún no vistos.
SVM no solo separa las clases, sino que intenta mantener el límite de decisión lo más alejado posible de ambas clases. Por eso su método de clasificación se denomina large margin classification (clasificación de márgenes amplios): al generar la función hipótesis que actúa como separador, se aplica además un margen que maximiza la separación entre dicha función y los datos de entrenamiento.
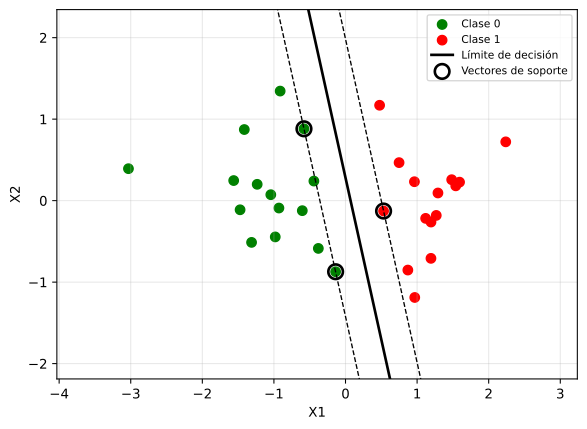
Figura 1: Clasificación de márgenes amplios. El límite de decisión (línea negra continua) se construye lo más lejos posible de los datos; las líneas punteadas marcan el margen y los círculos los vectores de soporte.
2.1 Hard Margin Classification
En la Hard Margin Classification el algoritmo ajusta los parámetros del modelo de forma que se maximiza la distancia (el margen) entre el límite de decisión y los ejemplos del conjunto de entrenamiento. El modelo se apoya en los ejemplos más cercanos al límite de decisión, conocidos como vectores de soporte (support vectors), para construir el separador y maximizar el margen.
Si añadimos nuevos datos que respetan el margen, el límite de decisión no cambia. Pero si un nuevo dato cae más cerca del límite que el vector de soporte actual, el modelo se ajusta para volver a maximizar el margen: aparece un nuevo vector de soporte, un nuevo separador y nuevos márgenes.
Este método solo funciona para conjuntos linealmente separables. Además es muy sensible a las anomalías: si un ejemplo de una clase aparece anómalamente cerca de la otra, el SVM construye un límite de decisión muy próximo a los datos “correctos”, lo que produce malas predicciones para datos futuros.
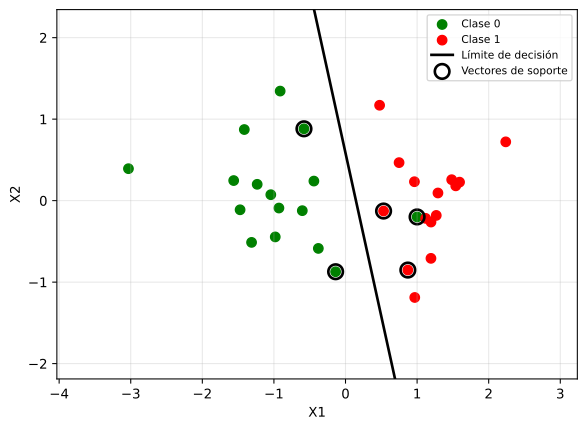
Figura 2: Efecto de un valor atípico (anomalía) en la Hard Margin Classification: un único punto de la clase 0 situado entre los de la clase 1 desvía drásticamente el límite de decisión.
La Hard Margin Classification presenta, por tanto, dos limitaciones importantes:
- No es aplicable cuando los datos no son linealmente separables.
- Es muy sensible a las anomalías.
3 La función de coste de SVM
Para entender cómo SVM maximiza el margen, conviene comparar su función de coste con la de la regresión logística.
3.1 Repaso: la función de coste de la regresión logística
En la regresión logística la salida es una probabilidad \(f_{w,b}(x) \in (0,1)\) obtenida al pasar la combinación lineal \(z = w^T x + b\) por la sigmoide. Su función de coste es la entropía cruzada, que penaliza severamente las predicciones incorrectas: si la clase real es \(1\) y la predicción es cercana a \(0\), el coste es alto, y viceversa.
3.2 Las funciones de coste de SVM (pérdida hinge)
SVM sustituye la función de coste continua de la regresión logística por una función por tramos basada en la pérdida hinge. Sea \(z = w^T x + b\) la combinación lineal (sin sigmoide). Definimos:
- Para la clase positiva (\(y = 1\)):
- Para la clase negativa (\(y = 0\)):
La intuición es la siguiente:
- Si \(y = 1\) y \(z \geq 1\), el ejemplo está “holgadamente” bien clasificado y el coste es 0.
- Si \(y = 0\) y \(z \leq -1\), ocurre lo mismo: el coste es 0.
- Solo cuando el ejemplo cae dentro del margen (\(|z| < 1\)) o es mal clasificado (\(z\) del signo equivocado), la función de coste crece linealmente.
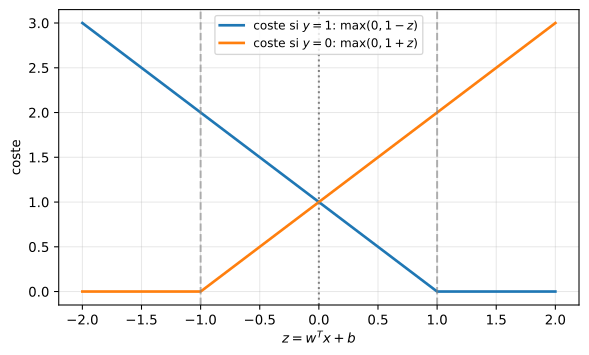
Figura 3: Funciones de coste de SVM. El coste es cero fuera del margen (z ≥ 1 para la clase 1, z ≤ -1 para la clase 0) y crece linealmente conforme el ejemplo se acerca o cruza el límite de decisión.
La función de coste total del SVM combina la penalización de los errores con la maximización del margen (que equivale a minimizar la norma de los pesos). En su forma estándar:
El término \(\frac{1}{2}\|w\|^2\) es lo que obliga a construir un margen amplio: cuanto mayor sea el margen, menor es \(\|w\|\). El hiperparámetro \(C\) controla el equilibrio entre ambos términos (lo veremos en la sección de Soft Margin).
3.3 Función hipótesis de SVM
La regresión logística aplica una sigmoide que acota el resultado lineal entre \(0\) y \(1\), y luego usa un umbral (típicamente \(0.5\)) para decidir la clase. SVM, en cambio, predice un valor discreto directamente a partir del resultado lineal:
Sin embargo, como vimos en la función de coste, a SVM no le basta con acertar: exige que la predicción quede “holgada” y no justa en el límite. Para que el coste sea cero, el resultado lineal debe cumplir \(w^T x + b \geq 1\) (clase 1) o \(w^T x + b \leq -1\) (clase 0).
3.4 Ejemplo numérico
Supongamos un problema con una sola característica y parámetros \(w = 0.2\), \(b = -1.0\), de modo que la combinación lineal es \(z(x) = 0.2x - 1.0\).
Ejemplo A (clase real \(y = 0\)): \(x = 4\).
La hipótesis predice \(\hat{y} = 0\) porque \(-0.2 < 0\): la clasificación es correcta. Pero el coste no es cero:
Ejemplo B (clase real \(y = 1\)): \(x = 6\).
La hipótesis predice \(\hat{y} = 1\) (ya que \(0.2 \geq 0\)): también correcta. El coste, con todo, es:
Aunque ambas predicciones son correctas, el modelo incurre en coste porque los ejemplos caen dentro del margen (\(|z| < 1\)). SVM empujará los parámetros para que, en datos bien separados, se cumpla \(z \geq 1\) o \(z \leq -1\) y el coste desaparezca.
3.5 Del coste al entrenamiento: cómo se calcula el gradiente y se actualizan los pesos
En el Ejemplo numérico anterior calculamos el coste de dos ejemplos aislados. Para entrenar el SVM necesitamos lo contrario: dado un coste \(J(w,b)\), ¿cómo cambiamos \(w\) y \(b\) para que ese coste baje? La herramienta es el gradiente (o, con la hinge por tramos, el subgradiente).
La regla es siempre la misma:
El término \(\frac{\partial J}{\partial w}\) responde a: “¿cuánto sube el coste si aumento \(w_1\) (o \(w_2\)) una pizca?”. Como queremos bajar el coste, restamos esa cantidad (escalada por la tasa de aprendizaje \(\eta\)).
A continuación resolvemos un ejemplo completo, sin introducir ninguna notación nueva: usamos exactamente coste_1 y coste_0 tal como se definieron más arriba.
3.5.1 El escenario
Dos puntos en 2D:
- Punto 1: \(x^{(1)} = (1, 2)\), clase \(y^{(1)} = 1\).
- Punto 2: \(x^{(2)} = (3, 1)\), clase \(y^{(2)} = 0\).
Hiperparámetros: \(C = 1\), tasa de aprendizaje \(\eta = 0.1\), y parámetros iniciales \(w = (0.2, -0.3)\), \(b = 0\).
3.5.2 Paso 1: evaluamos el coste (lo que ya sabemos hacer)
Punto 1 (clase 1, usamos coste_1):
Punto 2 (clase 0, usamos coste_0):
El coste total suma ambas hinge más el término de margen \(\tfrac{1}{2}\|w\|^2\):
Hasta aquí solo hemos medido el error. Ahora viene la parte que no se entendía: de dónde sale el gradiente.
3.5.3 Paso 2: la regla de la cadena, con las fórmulas del libro
El coste de un punto depende de \(w\) a través de \(z\). Escribámoslo explícitamente para la clase 1:
Para derivar respecto a \(w\) encadenamos dos derivadas:
- (B) derivada de \(z\) respecto a \(w\): como \(z = w_1 x_1 + w_2 x_2 + b\),
- (A) derivada de la hinge respecto a \(z\): aquí está lo único “raro”. La función
max(0, 1−z)es por tramos, así que su derivada también lo es. El trozo activo es \(1 - z\), y la derivada de \((1 - z)\) respecto a \(z\) es −1:
Para la clase 0 ocurre lo mismo pero con coste_0 = max(0, 1+z); el trozo activo es \(1 + z\), cuya derivada respecto a \(z\) es +1:
Juntando (A) y (B), el subgradiente de la hinge de un punto respecto a \(w\) es simplemente \((\text{A}) \cdot x\):
| Clase | Condición (margen falla) | \(\partial\,\text{coste}/\partial z\) (A) | \(\partial\,\text{coste}/\partial w = \text{(A)}\cdot x\) |
|---|---|---|---|
| 1 | \(z < 1\) | \(-1\) | \(-x\) |
| 0 | \(z > -1\) | \(+1\) | \(+x\) |
| cualquiera | margen cumplido | \(0\) | \(0\) (ese punto no enseña) |
Intuición: la hinge solo “empuja” cuando el punto está mal o dentro del margen. Si ya está fuera (\(z\ge 1\) para clase 1, o \(z\le -1\) para clase 0), el coste es 0 y su derivada es 0: el modelo no aprende de los puntos ya bien separados.
3.5.4 Paso 3: aplicamos la regla a nuestros dos puntos
Punto 1 (clase 1, \(z_1 = -0.4 < 1\) → margen falla, usa la fila “clase 1”):
Punto 2 (clase 0, \(z_2 = 0.3 > -1\) → margen falla, usa la fila “clase 0”):
Sumamos las contribuciones de la hinge (con \(C = 1\)) y le sumamos una sola vez el término de margen \(\frac{\partial}{\partial w}\tfrac{1}{2}\|w\|^2 = w\):
Error frecuente: no incluyas el término \(w\) dentro del gradiente de cada punto y luego los sumes; contaría la regularización una vez por ejemplo. \(\tfrac{1}{2}\|w\|^2\) es único para todo el modelo y se añade una vez al gradiente total.
3.5.5 Paso 4: actualizamos los parámetros
Restamos el gradiente (por eso el signo menos en la fórmula inicial):
3.5.6 Paso 5: comprobamos que el coste baja
Con \(w = (-0.02,-0.17),\; b = 0\):
- Punto 1: \(z_1 = -0.36\), \(\text{coste}_1 = 1.36\) (antes \(1.4\)).
- Punto 2: \(z_2 = -0.23\), \(\text{coste}_0 = 0.77\) (antes \(1.3\)).
- Margen: \(\tfrac{1}{2}\|w\|^2 = 0.0147\) (antes \(0.065\)).
- Nuevo \(J = 1.36 + 0.77 + 0.0147 \approx 2.145\) (antes \(2.765\)). ✓ Bajó.
Repitiendo este ciclo muchas veces (con un paso \(\eta\) que decrezca, p. ej. \(\eta_t \propto 1/t\)) los parámetros convergen al hiperplano que maximiza el margen.
Nota: el SVM estándar suele resolverse vía el problema dual (multiplicadores de Lagrange / algoritmo SMO) en lugar de descenso de subgradiente sobre el primal. El procedimiento de este ejemplo es válido y didáctico, pero no es la implementación típica de las librerías.
import numpy as np

w = np.array([0.2, -0.3])
b = 0.0
C = 1.0
eta = 0.1

X = np.array([[1.0, 2.0], [3.0, 1.0]])
y = np.array([1, 0])  # clase 1 y clase 0

z = X @ w + b
coste1 = np.maximum(0, 1 - z[y == 1])   # clase 1: max(0, 1 - z)
coste0 = np.maximum(0, 1 + z[y == 0])   # clase 0: max(0, 1 + z)
J = C * (coste1.sum() + coste0.sum()) + 0.5 * np.sum(w**2)
print("z:", z, "| coste total antes:", J)

# Subgradiente de la parte hinge (solo si el margen falla)
dW = np.zeros_like(w)
db = 0.0
for xi, yi, zi in zip(X, y, z):
    if yi == 1 and (1 - zi) > 0:     # clase 1, z < 1
        dW += C * (-xi)
        db += C * (-1)
    elif yi == 0 and (1 + zi) > 0:   # clase 0, z > -1
        dW += C * (+xi)
        db += C * (+1)
dW += w  # regularización 1/2||w||^2, una sola vez

w = w - eta * dW
b = b - eta * db
print("w nuevo:", w, "| b nuevo:", b)

# Coste tras el paso
z2 = X @ w + b
c1 = np.maximum(0, 1 - z2[y == 1]).sum()
c0 = np.maximum(0, 1 + z2[y == 0]).sum()
print("coste total despues:", C * (c1 + c0) + 0.5 * np.sum(w**2))
z: [-0.4  0.3] | coste total antes: 2.765
w nuevo: [-0.02 -0.17] | b nuevo: 0.0
coste total despues: 2.14465
4 Soft Margin Classification
La Hard Margin Classification falla cuando los datos no son linealmente separables o contienen anomalías: el algoritmo no puede construir un buen límite de decisión, o lo construye tan pegado a los valores atípicos que no generaliza.
La Soft Margin Classification es un enfoque menos rígido. Permite que algunos ejemplos queden dentro del margen o sean mal clasificados, a cambio de obtener un límite de decisión más robusto y mejor generalización. No se trata de un algoritmo distinto, sino de ajustar la flexibilidad del modelo mediante el hiperparámetro \(C\).
4.1 El hiperparámetro \(C\)
El hiperparámetro \(C\) regula la regularización y controla cuánto peso damos a clasificar correctamente todos los ejemplos de entrenamiento frente a maximizar el margen:
- Un valor alto de \(C\) da menos flexibilidad al modelo: penaliza fuertemente las clasificaciones erróneas e intenta clasificar correctamente todos los puntos (margen estrecho, parecido a hard margin).
- Un valor bajo de \(C\) permite más errores en el entrenamiento, produciendo un límite de decisión más flexible y robusto frente a anomalías (margen amplio).
En la formulación con variables de holgura (slack variables) \(\xi_i \geq 0\), el problema de optimización es:
Las \(\xi_i\) miden cuánto se viola la restricción de margen para el ejemplo \(i\). Un \(C\) pequeño hace que el término \(\frac{1}{2}\|w\|^2\) domine, priorizando un margen amplio aunque algunas \(\xi_i\) sean grandes.
4.1.1 Ejemplo numérico: el papel de \(C\)
Consideremos tres puntos en 2D, con la misma notación de coste del apartado anterior (\(J = C\sum \text{coste} + \tfrac{1}{2}\|w\|^2\)):
| punto | \(x\) | clase |
|---|---|---|
| 1 | \((-1, -1)\) | 0 |
| 2 | \((1.5, 1.5)\) | 1 |
| 3 | \((1, 1)\) | 0 (valor atípico) |
El punto 3 es un valor atípico: es de la clase 0 pero cae en la región de la clase 1 (cerca del punto 2), de modo que los datos no son linealmente separables. Para ver el efecto de \(C\) comparamos dos soluciones candidatas.
Solución A — margen amplio (tolera el valor atípico). Frontera \(x_1 + x_2 = 0\), es decir \(w = (1,1)\), \(b = 0\), con \(z = x_1 + x_2\):
- Punto 1 (clase 0): \(z = -2\) → \(\text{coste}_0 = \max(0,\, 1 + (-2)) = 0\).
- Punto 2 (clase 1): \(z = 3\) → \(\text{coste}_1 = \max(0,\, 1 - 3) = 0\).
- Punto 3 (clase 0): \(z = 2\) → \(\text{coste}_0 = \max(0,\, 1 + 2) = 3\) (mal clasificado).
Suma de hinge \(= 3\), término de margen \(\tfrac{1}{2}\|w\|^2 = \tfrac{1}{2}(1^2 + 1^2) = 1\).
Solución B — margen estrecho (ajusta todo). Frontera \(x_1 + x_2 = 2.25\), es decir \(w = (4,4)\), \(b = -9\), con \(z = 4(x_1 + x_2) - 9\):
- Punto 1 (clase 0): \(z = -17\) → \(\text{coste}_0 = \max(0,\, 1 + (-17)) = 0\).
- Punto 2 (clase 1): \(z = 3\) → \(\text{coste}_1 = \max(0,\, 1 - 3) = 0\).
- Punto 3 (clase 0): \(z = -1\) → \(\text{coste}_0 = \max(0,\, 1 + (-1)) = 0\).
Suma de hinge \(= 0\), término de margen \(\tfrac{1}{2}\|w\|^2 = \tfrac{1}{2}(4^2 + 4^2) = 16\).
Comparación según \(C\):
- Con \(C = 0.1\): \(J_A = 1.3\), \(J_B = 16\) → gana la A (margen amplio: asume el error del valor atípico porque le sale barato).
- Con \(C = 100\): \(J_A = 301\), \(J_B = 16\) → gana la B (margen estrecho: prefiere ajustar todos los puntos aunque la norma de \(w\) crezca).
El cambio se da en torno a \(C \approx 5\). Esto ilustra el papel de \(C\): valores pequeños priorizan un margen amplio (poco peso a los errores); valores grandes fuerzan clasificar bien todos los puntos a costa de un margen estrecho. (El margen de A mide \(2/\|w\| = \sqrt{2} \approx 1.41\); el de B, \(2/\|w\| = 1/\sqrt{8} \approx 0.35\).)
A y B son dos soluciones candidatas que ilustran el compromiso; el algoritmo elige la que minimice \(J\) para el \(C\) dado.
4.2 Ejemplo gráfico del efecto de \(C\)
El siguiente ejemplo ilustra el efecto de \(C\) en un SVM lineal (sin kernels, que se introducen más adelante). Los datos son linealmente separables con algo de ruido. Un \(C\) pequeño da prioridad al margen amplio y tolera que algunos puntos queden dentro de él; un \(C\) grande fuerza la clasificación de casi todos los puntos de entrenamiento a costa de un margen estrecho.
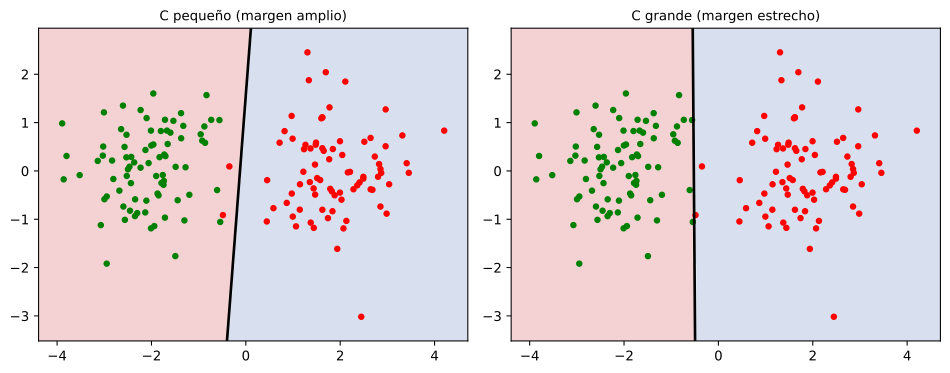
Figura 4: Efecto del hiperparámetro C con un kernel lineal. La línea continua es la frontera de decisión. A la izquierda, C pequeño: margen amplio y mayor tolerancia a errores. A la derecha, C grande: el modelo reduce los errores de entrenamiento con un margen estrecho.
5 Kernels en SVM
Hasta aquí hemos clasificado conjuntos linealmente separables. ¿Qué ocurre cuando los datos no se pueden separar con una recta?
5.1 Datos no linealmente separables
Una función hipótesis lineal no es adecuada cuando las clases se entrelazan. En el conjunto de la figura siguiente (dos “lunas”), una frontera lineal deja inevitablemente ejemplos mal clasificados.
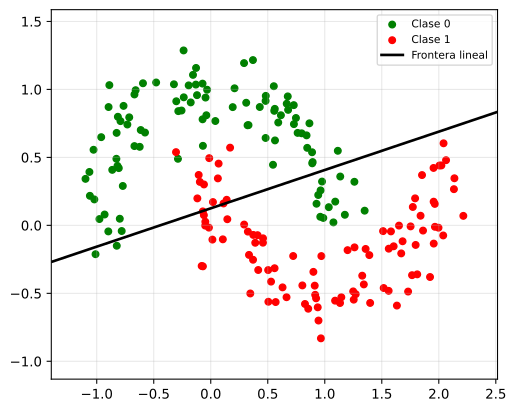
Figura 5: Conjunto no linealmente separable (dos ‘lunas’). Una frontera lineal no puede separar las clases correctamente.
Para manejar esta situación necesitamos una función hipótesis no lineal.
5.2 Regresión polinómica como separador no lineal
Una técnica sencilla para generar modelos no lineales es añadir características polinómicas a partir de las existentes. Partiendo de una característica \(x\), podemos crear \(x^2\), \(x^3\), etc., y tratar cada una como una característica independiente dentro de la hipótesis lineal. Con ello, en el espacio ampliado las clases sí se vuelven linealmente separables.
No obstante, la regresión polinómica tiene limitaciones:
- Los polinomios de bajo grado no crean fronteras de decisión lo suficientemente complejas.
- Los polinomios de alto grado generan un número enorme de características, disparando el coste computacional.
Los kernels resuelven este problema calculando las similitudes en el espacio transformado sin materializar explícitamente las nuevas características.
5.3 El kernel Gaussiano (RBF)
El kernel Gaussiano, también llamado Radial Basis Function (RBF), genera nuevas características a partir de un conjunto de puntos de referencia (landmarks) y de la similitud entre cada ejemplo y dichos puntos.
5.3.1 Landmarks y medida de similitud
Fijemos \(m\) puntos de referencia \(l^{(1)}, l^{(2)}, \dots, l^{(m)}\). Para un ejemplo \(x\), definimos una nueva característica \(f_j\) como una medida de similitud respecto al landmark \(l^{(j)}\):
Esta función es la exponencial de la distancia euclídea negativa entre \(x\) y el landmark, dividida por \(2\sigma^2\). Sus propiedades son intuitivas:
- Si \(x\) está cerca del landmark \(l^{(j)}\), la distancia es pequeña y \(f_j \approx 1\).
- Si \(x\) está lejos, la distancia es grande y \(f_j \approx 0\).
Así, el SVM clasifica los puntos en función de su proximidad a los landmarks. La hipótesis pasa a construirse con las nuevas características \(f_1, f_2, \dots, f_m\) en lugar de las originales \(x_1, x_2\).
5.3.1.1 Ejemplo numérico (similitud RBF)
Tomemos dos landmarks y \(\sigma = 1\) (con \(2\sigma^2 = 2\)):
- \(l^{(1)} = (0,0)\), de la clase 0.
- \(l^{(2)} = (3,4)\), de la clase 1.
Para un punto \(x\) calculamos \(f_1(x) = \exp(-\|x-l^{(1)}\|^2/2)\) y \(f_2(x) = \exp(-\|x-l^{(2)}\|^2/2)\):
| \(x\) | \(\|x-l^{(1)}\|^2\) | \(f_1\) | \(\|x-l^{(2)}\|^2\) | \(f_2\) |
|---|---|---|---|---|
| \((1,0)\) | \(1\) | \(e^{-0.5} \approx 0.61\) | \(20\) | \(e^{-10} \approx 0\) |
| \((3,5)\) | \(34\) | \(e^{-17} \approx 0\) | \(1\) | \(e^{-0.5} \approx 0.61\) |
| \((10,0)\) | \(100\) | \(e^{-50} \approx 0\) | \(65\) | \(e^{-32.5} \approx 0\) |
Se aprecia el comportamiento descrito: el punto \((1,0)\) está cerca de \(l^{(1)}\) (\(f_1 \approx 0.61\)) y lejos de \(l^{(2)}\) (\(f_2 \approx 0\)); el punto \((3,5)\) hace lo contrario; y \((10,0)\) está lejos de ambos (\(f_1, f_2 \approx 0\)). Así el SVM usa estas similitudes como entradas: un punto “hereda” la característica del landmark próximo. Como \(l^{(1)}\) es de la clase 0 y \(l^{(2)}\) de la clase 1, \(x=(1,0)\) (alto \(f_1\)) tendería a clase 0 y \(x=(3,5)\) (alto \(f_2\)) a clase 1.
5.3.2 Relación entre \(\sigma\) y \(\gamma\)
El kernel RBF que implementan las librerías (por ejemplo, scikit-learn) se expresa habitualmente con el hiperparámetro \(\gamma\) (gamma) en lugar de \(\sigma\):
Por tanto, \(\gamma\) y \(\sigma\) son inversamente proporcionales: un \(\gamma\) grande equivale a un \(\sigma\) pequeño (zona de influencia estrecha) y viceversa.
La estrategia más común para elegir los landmarks es crear un landmark por cada ejemplo de entrenamiento \(l^{(i)} = x^{(i)}\). Con \(m\) ejemplos generamos \(m\) nuevas características, y la función de optimización es la misma que para el caso lineal, pero operando en el espacio de similitudes.
5.4 Kernel polinómico
Además del RBF, SVM admite otros kernels. El kernel polinómico aplica implícitamente la transformación polinómica que comentábamos, sin crear todas las características a mano:
donde \(d\) es el grado y \(c_0\) (coef0) un término independiente. En la práctica, el kernel RBF suele ser el primero a probar por su flexibilidad.
5.5 Comparativa de fronteras con distintos kernels
La figura siguiente muestra, sobre el mismo conjunto no lineal, las fronteras que construye SVM con kernel lineal, polinómico y RBF.
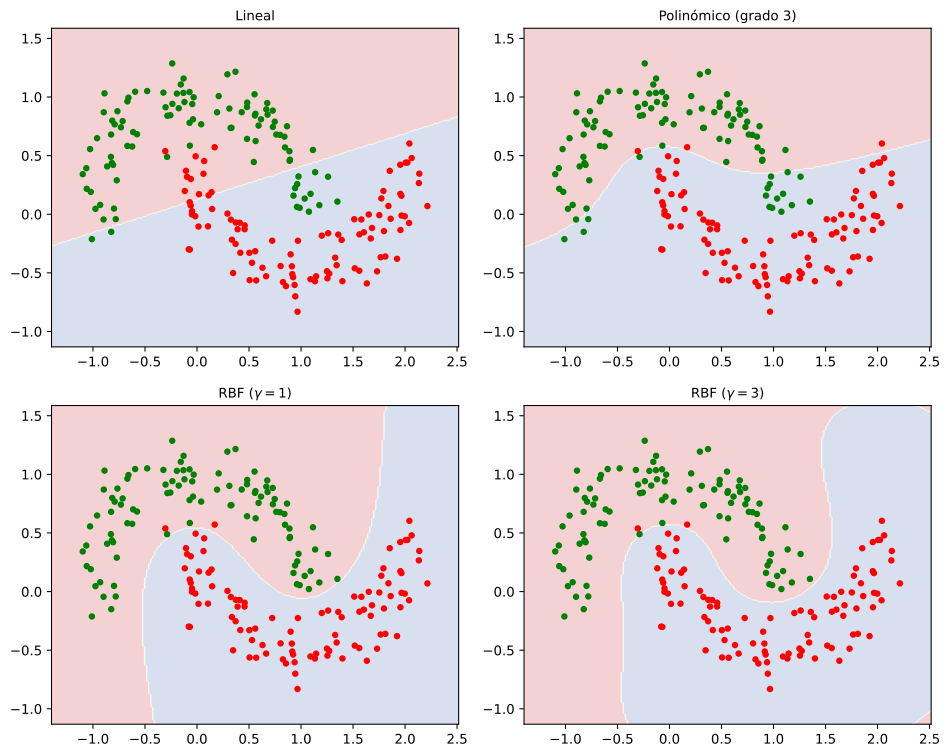
Figura 6: Fronteras de decisión de SVM con distintos kernels sobre un conjunto no lineal. El kernel lineal falla; el polinómico y el RBF (con distintos gamma) logran separar las clases.
6 Hiperparámetros: \(C\) y \(\gamma\)
Resumimos el papel de los dos hiperparámetros clave de SVM:
- \(C\) (regularización): controla el equilibrio entre margen amplio y error de entrenamiento.
- \(C\) grande: el modelo intenta clasificar correctamente todos los ejemplos, aunque el margen sea pequeño. Riesgo de sobreajuste a anomalías.
- \(C\) pequeño: prioriza un margen amplio, tolerando algunos errores de entrenamiento. Mayor robustez.
- \(\gamma\) (solo kernel RBF): controla la influencia de cada punto de entrenamiento (la “anchura” de la base Gaussiana, \(\gamma = 1/(2\sigma^2)\)).
- \(\gamma\) grande: un punto solo se considera similar a otro si están muy cerca; frontera muy flexible y propensa al sobreajuste.
- \(\gamma\) pequeño: puntos distantes se consideran similares; frontera suave y de menor capacidad.
El siguiente ejemplo muestra el efecto de \(\gamma\) con un kernel RBF: un \(\gamma\) pequeño produce una frontera suave, mientras que un \(\gamma\) grande produce una frontera muy rígida que se ajusta excesivamente a los datos.
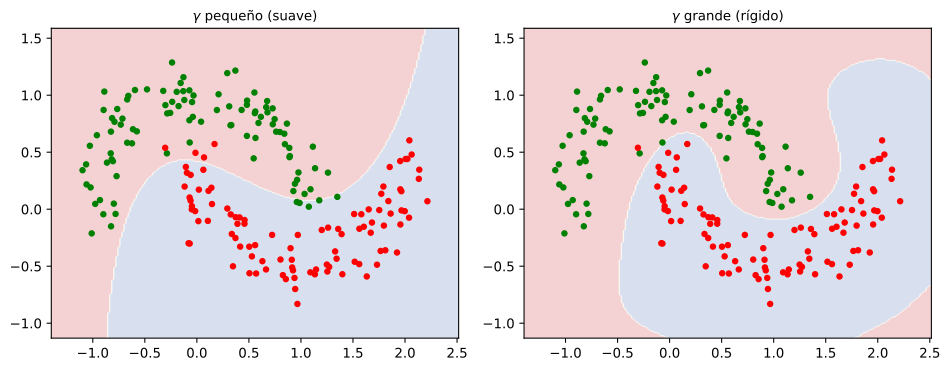
Figura 7: Efecto del hiperparámetro gamma con un kernel RBF. A la izquierda, gamma pequeño: frontera suave y generalizadora. A la derecha, gamma grande: frontera muy rígida y propensa al sobreajuste.
Nota: los kernels Gaussianos y RBF no son exactamente el mismo concepto. El kernel Gaussiano es una medida de similitud concreta; el RBF (Gaussian Radial Basis Function) es la versión parametrizada con \(\gamma\) que implementan las librerías. En la práctica suelen usarse como sinónimos, pero conviene recordar que la ecuación con \(\gamma\) es la que se ajusta al entrenar.
7 Caso práctico: detección de URLs de phishing
Veamos un ejemplo real de aplicación de SVM. El objetivo es clasificar URLs como benignas o de phishing a partir de decenas de características (longitud de la consulta, número de tokens, entropía de distintas partes de la URL, etc.).
El flujo habitual es: cargar los datos, separar en entrenamiento/validación/test, imputar valores faltantes o infinitos, escalar las características (fundamental para kernels no lineales, donde la escala cambia la noción de “distancia”) y entrenar el modelo.
import pandas as pd
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.impute import SimpleImputer
from sklearn.svm import SVC
from sklearn.preprocessing import RobustScaler
from sklearn.pipeline import Pipeline
from sklearn.metrics import f1_score

# Carga del conjunto de datos de URLs (benignas y de phishing)
df = pd.read_csv("datasets/FinalDataset/Phishing.csv")

# División en entrenamiento, validación y test
train_set, val_set, test_set = train_test_split(df, test_size=0.3, random_state=42)
# (En la práctica se suele hacer una división triple train/val/test)

X_train = train_set.drop("URL_Type_obf_Type", axis=1)
y_train = train_set["URL_Type_obf_Type"].copy()
X_val = val_set.drop("URL_Type_obf_Type", axis=1)
y_val = val_set["URL_Type_obf_Type"].copy()

# Eliminamos la columna con valores infinitos y rellenamos nulos con la mediana
X_train = X_train.drop("argPathRatio", axis=1)
X_val = X_val.drop("argPathRatio", axis=1)
imputer = SimpleImputer(strategy="median")
X_train_prep = pd.DataFrame(imputer.fit_transform(X_train), columns=X_train.columns)
X_val_prep = pd.DataFrame(imputer.transform(X_val), columns=X_val.columns)
Una vez preparados los datos, podemos entrenar distintos tipos de SVM. Con un kernel lineal el escalado es menos crítico, pero con kernels no lineales (polinómico o RBF) es imprescindible.
# SVM con kernel lineal (Large Margin Classification)
svm_clf = SVC(kernel="linear", C=50)
svm_clf.fit(X_train_prep, y_train)

y_pred = svm_clf.predict(X_val_prep)
print("F1 Score:", f1_score(y_pred, y_val, pos_label="phishing"))
# F1 Score: 0.814
Aplicando un pipeline con escalado (RobustScaler) y kernel RBF se obtienen resultados superiores:
# SVM con kernel Gaussiano (RBF) y escalado
rbf_kernel_svm_clf = Pipeline([
    ("scaler", RobustScaler()),
    ("svm_clf", SVC(kernel="rbf", gamma=0.5, C=1000))
])
rbf_kernel_svm_clf.fit(X_train_prep, y_train)

y_pred = rbf_kernel_svm_clf.predict(X_val_prep)
print("F1 Score:", f1_score(y_pred, y_val, pos_label="phishing"))
# F1 Score: 0.862
También es posible usar un kernel polinómico directamente, sin crear las características a mano:
# SVM con kernel polinómico
svm_poly = SVC(kernel="poly", degree=3, coef0=10, C=20)
svm_poly.fit(X_train_prep, y_train)

y_pred = svm_poly.predict(X_val_prep)
print("F1 Score:", f1_score(y_pred, y_val, pos_label="phishing"))
# F1 Score: 0.825
En este caso real, el kernel RBF supera al lineal y al polinómico, lo que ilustra por qué es el kernel por defecto recomendado.
7.1 Demo ejecutable: kernels sobre datos sintéticos
Para ver el comportamiento de los kernels de forma reproducible sin necesidad del conjunto de datos externo, entrenamos SVM sobre el clásico conjunto make_moons (el mismo que usamos en las figuras anteriores):
#  echo: true

import numpy as np
from sklearn.datasets import make_moons
from sklearn.svm import SVC
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import Pipeline
from sklearn.metrics import accuracy_score

X, y = make_moons(n_samples=300, noise=0.2, random_state=1)

for nombre, clf in [
    ("lineal", SVC(kernel="linear", C=1)),
    ("polinómico (d=3)", SVC(kernel="poly", degree=3, C=1)),
    ("rbf (gamma=1)", SVC(kernel="rbf", gamma=1, C=1)),
]:
    pipe = Pipeline([("scaler", StandardScaler()), ("clf", clf)])
    pipe.fit(X, y)
    print(f"Kernel {nombre:18s} -> accuracy: {accuracy_score(y, pipe.predict(X)):.3f}")
Kernel lineal             -> accuracy: 0.857
Kernel polinómico (d=3)   -> accuracy: 0.860
Kernel rbf (gamma=1)      -> accuracy: 0.967
8 SVM para regresión (SVR)
Hasta aquí solo hemos visto clasificación. Como se anticipó en la introducción, SVM también resuelve regresión: en lugar de predecir una clase, predice un valor continuo \(f(x) = w^T x + b\). La idea del margen se traslada a un tubo de anchura \(\varepsilon\) (épsilon) alrededor de la predicción.
8.1 La pérdida \(\varepsilon\)-insensible
En clasificación usábamos la hinge \(\max(0, 1 - yz)\), que solo penaliza cuando el punto está mal o dentro del margen. En regresión la pérdida es su análoga simétrica:
Su comportamiento es el equivalente continuo de la hinge:
- Si \(|y - f(x)| \le \varepsilon\) (el punto cae dentro del tubo), la pérdida es 0.
- Si \(|y - f(x)| > \varepsilon\) (el punto está fuera del tubo), la pérdida crece linealmente con la distancia al tubo.
Al igual que los vectores de soporte en clasificación eran los puntos del margen, en SVR los vectores de soporte son los puntos fuera del tubo: solo ellos contribuyen al aprendizaje.
8.2 Función de coste y optimización
que, con variables de holgura \(\xi_i, \xi_i^* \ge 0\), se escribe como
El papel de los hiperparámetros es el mismo espíritu que en clasificación:
- \(C\): cuánto penalizamos los puntos fuera del tubo (igual que en soft margin).
- \(\varepsilon\): anchura del tubo; un \(\varepsilon\) grande tolera más error y da un modelo más simple (menos vectores de soporte).
8.3 Ejemplo numérico
Consideremos un modelo lineal candidato \(f(x) = w^T x + b\) con \(w = (0.5, 0.5)\), \(b = 0\) (es decir, \(f(x) = 0.5(x_1 + x_2)\)) y \(\varepsilon = 0.5\), con tres puntos en 2D:
| punto | \(x\) | \(y\) | \(f(x)\) | \(|y - f(x)|\) | ¿dentro del tubo? | coste | |----|----|----|----|----|----|----| | 1 | \((1, 0)\) | 0.7 | 0.5 | 0.2 | sí (\(\le 0.5\)) | 0 | | 2 | \((2, 1)\) | 1.8 | 1.5 | 0.3 | sí (\(\le 0.5\)) | 0 | | 3 | \((3, 2)\) | 3.5 | 2.5 | 1.0 | no (\(> 0.5\)) | \(\max(0,\, 1.0 - 0.5) = 0.5\) |
Solo el punto 3 queda fuera del tubo, así que es el único vector de soporte; su coste es \(0.5\). El término de margen es \(\tfrac{1}{2}\|w\|^2 = \tfrac{1}{2}(0.5^2 + 0.5^2) = 0.25\), y por tanto:
Si aumentáramos \(\varepsilon\) a \(1.0\), el punto 3 pasaría a estar dentro del tubo y su coste bajaría a \(0\) (menos vectores de soporte, modelo más simple). Si aumentamos \(C\), el optimizador fuerza acercar la recta a los puntos para reducir la penalización de los vectores de soporte.
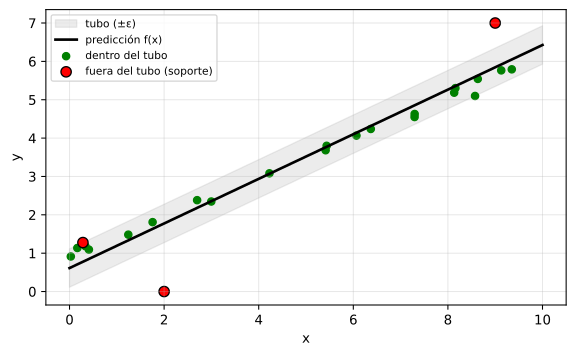
Figura 8: SVM para regresión (SVR). La línea continua es la predicción f(x); las líneas punteadas delimitan el tubo de anchura ε (f(x) ± ε). Los puntos dentro del tubo no aportan coste; los que caen fuera (en rojo) son los vectores de soporte.
Al igual que en clasificación, los kernels (RBF, polinómico) también se aplican a SVR para modelar relaciones no lineales: basta sustituir el producto \(x^T x'\) por \(K(x,x')\) en el problema dual.