Práctica en Visión Artificial: Transfer Learning, Data Augmentation y Producción
Navegación en esta sección
Capítulos anteriores del bloque de Visión Artificial: 1. Redes neuronales convolucionales (CNN) — fundamentos teóricos y LeNet-5. 2. Matemáticas de la capa convolucional — cálculo manual y backpropagation. 3. Arquitecturas clásicas y modernas de CNN — de AlexNet y VGG a ResNet, MobileNet y EfficientNet.
Estás en Práctica en Visión Artificial (ingeniería de datos, transferencia de modelos preentrenados y despliegue real).
1 El dilema de los datos en Visión por Computadora
En el aprendizaje automático tradicional con datos tabulares, disponer de miles de filas suele ser suficiente para ajustar modelos con alta precisión. En visión por computadora, sin embargo, una sola imagen de \(1000 \times 1000\) píxeles RGB contiene 3 millones de valores numéricos de entrada. Para que una red neuronal profunda aprenda a distinguir patrones complejos sin memorizar el ruido de fondo, la regla general es tajante: en visión artificial nunca hay suficientes datos.
Los algoritmos de visión se nutren de dos fuentes de conocimiento:
- Datos etiquetados (\(X, Y\)): Imágenes reales acompañadas de sus anotaciones o etiquetas.
- Conocimiento previo e ingeniería de diseño: Elección de arquitecturas modulares, sesgos inductivos espaciales y transferencia de pesos preentrenados.
Cuando disponemos de pocos datos propios (por ejemplo, apenas 50 o 200 fotografías de un problema industrial o médico específico), la ingeniería de transferencia y el aumento de datos son las únicas herramientas que permiten obtener precisiones del estado del arte sin caer en el sobreajuste (overfitting).
2 Aprendizaje por Transferencia (Transfer Learning)
Entrenar desde cero (from scratch) una arquitectura como ResNet-50 o EfficientNet sobre el conjunto de datos ImageNet (\(1.2\) millones de imágenes y 1000 categorías) requiere semanas de computación en clústeres de GPUs de alto rendimiento.
El aprendizaje por transferencia (Transfer Learning) consiste en descargar esos pesos ya optimizados y utilizarlos como punto de partida para resolver una tarea nueva con un conjunto de datos mucho más reducido.
2.1 ¿Por qué funciona la transferencia?
Como vimos en la jerarquía visual de representaciones:
- Las primeras capas de cualquier CNN aprenden detectores de rasgos universales: bordes orientados, curvas, gradientes de luz y contrastes de color (filtros de tipo Gabor). Estos rasgos son idénticos tanto si la red clasifica perros como si analiza radiografías médicas o componentes mecánicos.
- Las capas intermedias aprenden combinaciones geométricas: texturas, rejillas, círculos y esquinas.
- Solo las últimas capas convolucionales y densas se especializan en los conceptos semánticos específicos del dataset original (por ejemplo, razas concretas de gatos o modelos de coches).
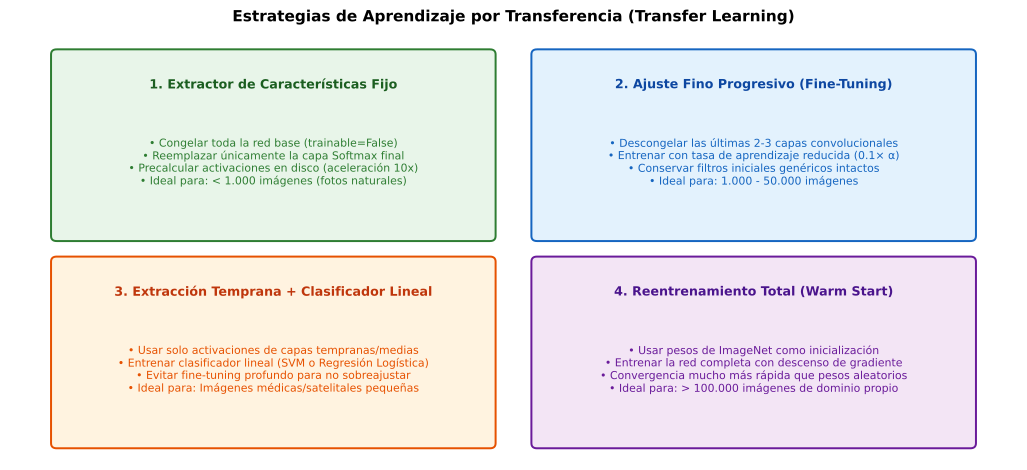
Figura 1: Matriz de decisión de Transfer Learning: la estrategia óptima depende del volumen de datos propio y de la similitud visual con el dominio preentrenado (ImageNet).
2.2 Los tres escenarios de aplicación práctica
2.2.1 Escenario 1: Conjunto de datos pequeño (\(< 1.000\) imágenes)
Si deseamos clasificar 3 tipos de defectos en piezas industriales y solo contamos con 100 fotos por clase:
- Tomamos una red preentrenada (por ejemplo, ResNet-50).
- Congelamos (freeze) todos los pesos de la red base (
trainable = False), evitando que el descenso de gradiente los modifique. - Eliminamos la capa de salida original de 1000 clases y añadimos una nueva capa Softmax con 3 neuronas.
- Entrenamos únicamente los pesos de la nueva capa de salida.
Truco de ingeniería: Pre-cálculo de activaciones en disco
Como las capas base están congeladas, el resultado de pasar una imagen \(X\) por la red base siempre produce el mismo vector de características \(z\). En lugar de ejecutar la red convolucional completa en cada época de entrenamiento:
- Pasamos todo el dataset por la red base una sola vez.
- Guardamos los vectores resultantes (\(1 \times 1 \times 2048\)) en disco como un archivo
.npyo.h5. - Entrenamos un clasificador lineal (o una pequeña capa densa) directamente sobre esos vectores.
Esto reduce el tiempo de entrenamiento de horas a pocos segundos, consumiendo una fracción mínima de CPU/GPU.
2.2.2 Escenario 2: Conjunto de datos mediano (\(1.000 - 50.000\) imágenes)
Con un volumen moderado de datos, podemos realizar un ajuste fino (Fine-Tuning):
- Primero entrenamos la capa de salida con la red base congelada hasta que converja.
- A continuación, descongelamos las últimas 2 o 3 capas convolucionales de la red.
- Continuamos el entrenamiento con una tasa de aprendizaje muy pequeña (\(\alpha_{\text{fine}} \approx 0.1 \times \alpha_{\text{inicial}}\)).
La tasa de aprendizaje reducida es crítica: si usamos una tasa grande, los gradientes iniciales destruirán los pesos preentrenados (catastrophic forgetting), arruinando el conocimiento previo.
2.2.3 Escenario 3: Conjunto de datos masivo (\(> 100.000\) imágenes)
Si disponemos de cientos de miles de imágenes de un dominio específico (por ejemplo, conducción autónoma):
- Se utiliza la red preentrenada como inicialización cálida (Warm Start) de todos los parámetros de la red.
- Se entrena la red completa con descenso de gradiente. La convergencia es entre 3 y 5 veces más rápida que partiendo de pesos aleatorios (He o Xavier).
3 Aumento de Datos (Data Augmentation) en tiempo real
En visión artificial, el objetivo es que el modelo aprenda a reconocer la identidad semántica del objeto con independencia de variaciones de luz, ángulo, encuadre o posición. El aumento de datos (Data Augmentation) genera artificialmente nuevas muestras de entrenamiento aplicando transformaciones que preservan la etiqueta real.
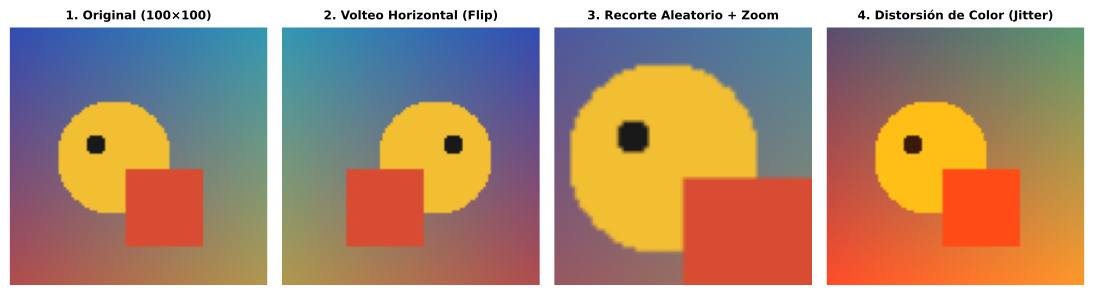
Figura 2: Transformaciones comunes de aumento de datos generadas sintéticamente: original (1), reflejo horizontal (2), recorte aleatorio con reescalado (3) y distorsión fotométrica de color (4).
3.1 Tipos de transformaciones
3.1.1 1. Transformaciones geométricas
- Reflejo horizontal (Horizontal Flip): Invierte el eje horizontal. Es muy efectivo en fotografías naturales (animales, vehículos, paisajes).
- Precaución: No debe usarse si la orientación altera la etiqueta (por ejemplo, detección de señales de giro a la izquierda vs derecha o reconocimiento de texto y dígitos como \(6\) vs \(9\)).
- Recorte aleatorio (Random Cropping) y reescalado: Extrae sub-regiones aleatorias (por ejemplo, del \(70\%\) al \(100\%\) del área original) y las redimensiona al tamaño de entrada de la red. Fuerza al modelo a reconocer objetos a partir de partes parciales.
- Rotación leve y traslación: Giros entre \(\pm 10^\circ\) o desplazamientos de pocos píxeles que simulan variaciones de encuadre.
3.1.2 2. Transformaciones fotométricas (Color Jittering)
- Alteración de brillo, contraste y saturación: Modifica la intensidad lumínica multiplicando y sumando valores aleatorios a los canales RGB, preparando a la red para operar bajo luz solar directa o sombras.
- Aumento de color por PCA (PCA Color Augmentation): Técnica empleada en AlexNet que calcula los autovectores y autovalores de la matriz de covarianza de los píxeles RGB del dataset completo. Añade múltiplos aleatorios de los componentes principales a cada píxel, variando el tono general sin alterar la correlación natural entre los colores de la escena.
3.2 Pipeline asíncrono de entrenamiento (CPU vs GPU)
En implementaciones profesionales, las distorsiones de aumento de datos nunca se guardan en disco (lo que multiplicaría innecesariamente el espacio de almacenamiento). En su lugar, se generan al vuelo (on-the-fly) en memoria RAM:
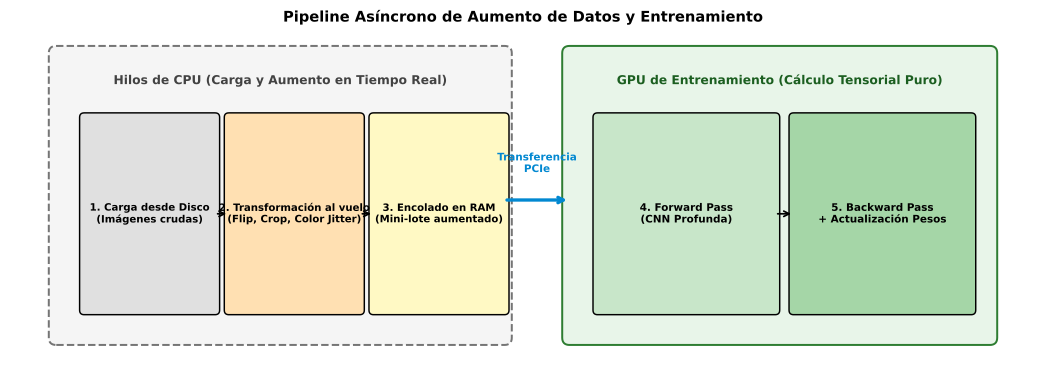
Figura 3: Pipeline de datos multihilo: la CPU procesa el aumento de datos en memoria en paralelo mientras la GPU entrena la red neuronal sin tiempos de espera.
- Hilos de CPU: Leen lotes de imágenes crudas del disco duro, aplican distorsiones aleatorias en tiempo real y preparan los tensores numéricos en memoria RAM.
- GPU: Recibe continuamente los mini-lotes ya procesados mediante transferencia DMA/PCIe y ejecuta el forward pass y backward pass sin sufrir bloqueos de entrada/salida (I/O bottlenecks).
4 Competiciones (Benchmarks) vs. Sistemas en Producción
Al leer literatura científica o participar en competiciones de Machine Learning (como Kaggle o ILSVRC), es frecuente encontrar ciertas técnicas que ganan torneos pero que rara vez se implementan en aplicaciones comerciales reales.
4.1 Técnicas habituales en competiciones
- Ensamblado de modelos (Ensembling):
- Se entrenan independientemente entre 3 y 10 redes neuronales distintas (o la misma con distintas semillas).
- En inferencia, cada imagen se evalúa en todos los modelos y se promedian sus probabilidades Softmax: \(\hat{y}_{\text{ensamble}} = \frac{1}{M} \sum_{m=1}^M \hat{y}^{(m)}\).
- Ventaja: Aumenta la precisión entre un \(1\%\) y un \(2\%\), lo que a menudo marca la diferencia entre el primer y el quinto puesto.
- Inconveniente en producción: Multiplica por \(M\) el tiempo de respuesta (latencia), el consumo de memoria y el coste de servidores.
- Aumento en tiempo de prueba (Test-Time Augmentation / TTA):
- En lugar de evaluar la imagen original, se generan 10 versiones de prueba (las 4 esquinas, el centro y sus 5 versiones reflejadas, técnica conocida como 10-crop).
- Se promedian las 10 predicciones resultantes.
- Inconveniente en producción: Hace que la inferencia sea 10 veces más lenta.
4.2 Criterios de diseño para sistemas en producción
| Criterio | Competición / Benchmark | Sistema en Producción (Comercial / Móvil) |
|---|---|---|
| Métrica reina | Precisión pura (\(+0.1\%\) importa) | Balance entre precisión, latencia, coste y robustez |
| Latencia de inferencia | Irrelevante (ejecución por lotes en servidor) | Estricta (\(< 30\text{ ms}\) en móvil, \(< 100\text{ ms}\) en API web) |
| Arquitecturas preferidas | Grandes ensambles (ResNet-152 + Inception-v4) | Modelos compactos únicos (MobileNet v2, EfficientNet-B0) |
| Optimización de modelos | Precisión de 32 bits (FP32) | Cuantización a enteros de 8 bits (INT8), poda (Pruning) y ONNX |
5 Código interactivo en Python: Aumento de datos y Extracción de características
El siguiente script en Python implementa funciones reproducibles para transformaciones de datos y simula el flujo de trabajo de Transfer Learning con pesos congelados:
import numpy as np

# 1. Simulación de funciones de Data Augmentation
def random_horizontal_flip(image, prob=0.5):
    """Aplica volteo horizontal con probabilidad p."""
    if np.random.rand() < prob:
        return np.fliplr(image)
    return image

def color_jitter(image, factor=0.2):
    """Aplica una distorsión luminosa aleatoria por canal."""
    shift = np.random.uniform(-factor, factor, size=(1, 1, image.shape[2]))
    return np.clip(image + shift, 0.0, 1.0)

# Imagen sintética de prueba (4x4x3)
img_sample = np.random.uniform(0.2, 0.8, size=(4, 4, 3))
img_augmented = color_jitter(random_horizontal_flip(img_sample, prob=1.0), factor=0.15)

print("=" * 60)
print("1. AUMENTO DE DATOS EN TIEMPO REAL")
print("=" * 60)
print("Canal Rojo Original (4×4):\n", np.round(img_sample[:, :, 0], 2))
print("\nCanal Rojo Aumentado (Volteado + Jitter):\n", np.round(img_augmented[:, :, 0], 2))

# 2. Simulación de Transfer Learning (Feature Extraction)
print("\n" + "=" * 60)
print("2. SIMULACIÓN DE TRANSFER LEARNING CON BASE CONGELADA")
print("=" * 60)

N_samples = 20
feature_dim = 128   # Salida de la última capa convolucional congelada
num_classes = 3     # Nuevo problema (3 clases)

# Generamos vectores de características simulados (como si vinieran de ResNet)
X_features = np.random.randn(N_samples, feature_dim)
y_labels = np.random.randint(0, num_classes, size=N_samples)

# Capa Softmax final propia (pesos entrenables)
W_head = np.random.randn(feature_dim, num_classes) * 0.01
b_head = np.zeros(num_classes)

def softmax(z):
    exp_z = np.exp(z - np.max(z, axis=1, keepdims=True))
    return exp_z / np.sum(exp_z, axis=1, keepdims=True)

# Forward pass de la cabeza clasificadora
logits = np.dot(X_features, W_head) + b_head
probabilities = softmax(logits)

print(f"Dimensiones de entrada a la cabeza:  {X_features.shape}")
print(f"Dimensiones de pesos entrenables:    {W_head.shape}")
print(f"Probabilidades de salida (muestra 0): {np.round(probabilities[0], 3)}")
print(f"Clase predicha: {np.argmax(probabilities[0])} | Etiqueta real: {y_labels[0]}")
============================================================
1. AUMENTO DE DATOS EN TIEMPO REAL
============================================================
Canal Rojo Original (4×4):
 [[0.42 0.56 0.23 0.62]
 [0.7  0.31 0.46 0.28]
 [0.47 0.51 0.56 0.77]
 [0.38 0.46 0.22 0.6 ]]

Canal Rojo Aumentado (Volteado + Jitter):
 [[0.53 0.14 0.46 0.33]
 [0.19 0.36 0.22 0.6 ]
 [0.67 0.47 0.41 0.38]
 [0.5  0.13 0.37 0.29]]

============================================================
2. SIMULACIÓN DE TRANSFER LEARNING CON BASE CONGELADA
============================================================
Dimensiones de entrada a la cabeza:  (20, 128)
Dimensiones de pesos entrenables:    (128, 3)
Probabilidades de salida (muestra 0): [0.357 0.304 0.339]
Clase predicha: 0 | Etiqueta real: 2